شرح الدرس
تعرّف التعلم الآلي وخوارزميات التعلم الآلي المختلفة وخطوات بناء نموذج التعلم الآلي وتقييمه، إضافة إلى تعرّف طبيعة المشكلات التي يُمكن حلها بالتعلم الآلي، وكيفية بناء نظام تعلم آلي باستخدام أدوات محددة.
منتجات التعلم
- تحليل البيانات التي جُمعت حول استخدام السيارة باستخدام أداة Orange Data Mining، وتطبيق خوارزمية شجرة القرار (Decision Tree) لتحديد نوع السيارة المناسب (بنزين، كهرباء، هايبيرد) بناءً على طبيعة الاستخدام.
- وسيتم أيضاً تقييم أداء النموذج باستخدام مقاييس الدقة.
نتاجات التعلم
- أعرف أنظمة التعلم الآلي.
- أبني نموذجا للتعلم الآلي باستخدام الأدوات الجاهزة.
- أذكر بعضا من الأدوات الجاهزة للتعلم الآلي.
- أوضح خوارزميات التعلم الآلي.
- أبني نموذجا للتعلم الآلي باستخدام لغة بايثون.
- تعمل الأنظمة الخبيرة بشكل جيد في المجالات التي تكون فيها القواعد واضحة والمعرفة ثابتة.
- أما في حال تغيرت المعرفة أو القواعد، فإن هذه الأنظمة ستحتاج إلى تعديل من قبل الخبير البشري بشكل يدوي ودوري، إن هذه الآلية للتعديل غير فعالة في المجالات التي تتغير فيها المعرفة بشكل سريع.
- بالإضافة إلى وجود بعض المشكلات المعقدة مثل التعرف إلى الأصوات والأنماط والنصوص الكتابية التي قد يكون من الصعب إيجاد قواعد عامة لها وحلها بشكل فعال من قبل الأنظمة الخبيرة.
فكيف يمكن حل هذه التحديات؟
تعلم الآلة
- يتوافر في وقتنا الحالي كمّ هائل من البيانات، تولدت بسبب الانتشار الكبير للأجهزة الرقمية، وإنترنت الأشياء والتجارة الرقمية، ووسائل التواصل الاجتماعي، وغيرها الكثير من المصادر.
- وتقدّر كمية المعلومات المولّدة يوميا بـ 2.5 Quintillion Bytes. هذه المعلومات بحاجة إلى تحليل ودراسة؛ لتصبح ذات معنى، ويُمكن توظيف مخرجاتها في صنع القرارات.
- تعلم الآلة هو أحد فروع الذكاء الاصطناعي الذي يُعنى بتطوير برمجيات وخوارزميات تعطي الحاسوب القدرة على التعلم من دون أن يُبرمج بشكل صريح للقيام بمهمات معينة.
- نستطيع القول إن برنامجا معينا لديه القدرة على التعلم؛ إذا كان تعريضه لعدد أكثر من الأمثلة في مسألة معينه يؤدي إلى تحسين أدائه وفق معايير قياس محدده.
- من الأمثلة على ذلك برنامج مسؤول عن تصنيف الإيميلات الواردة إلى البريد الإلكتروني إلى إيميلات غير مرغوبه (Spam Emails) وإيميلات مرغوبة (Regular Emails). حيث إن إعطاء خوارزميات تعلم الآلة أمثلة على كلا النوعين من الرسائل يمكنه من تطوير نموذج قادر على تصنيف الإيميلات بناء على محتواها.
أبحث
أبحث في المصادر الإلكترونية الموثوقة عن العناصر التي يجب توافرها في نظام، يمكنه حل المشكلات باستخدام تقنيات تعلم الآلة. أدوّن ما أتوصل إليه وأشاركه مع زملائي.
متطلبات بناء نموذج التعلم الآلي
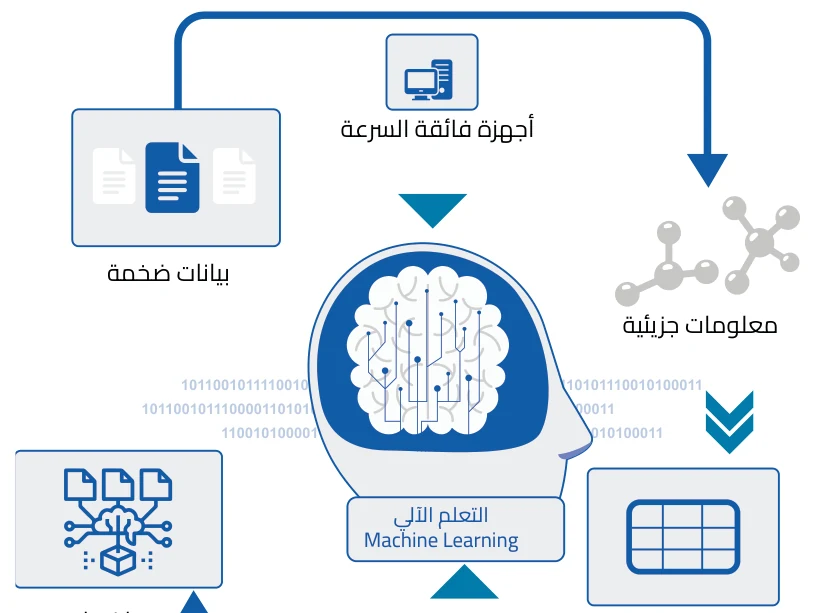
لنتمكن من تطوير نماذج فعالة باستخدام تعلم الآلة، فيجب توافر مجموعة من العناصر وهي:
- البيانات الضخمة (Big Data): تؤدي البيانات دورا كبيرا في تكوين أنظمة دقيقة لديها نظرة شمولية؛ لذلك نحتاج إلى كمية كبيرة من البيانات المتعلقة بالمشكلة التي نحاول حلها. أيضا يجب أن تكون البيانات دقيقة وخالية من الضوضاء والأخطاء. لنقل مثلاً إنّ لدينا أداة إدارة للبريد الإلكتروني، ونريد حذف الرسائل المزعجة أوتوماتيكيا، فيجب علينا جمع أكبر عدد من البيانات لرسائل بريد إلكتروني مزعجه، وكلما زاد تنوّع الرسائل لدينا، زادت نسبة صحة النتائج. توجد طريقتان لجمع البيانات، يدويا وأوتوماتيكيا.
- الخصائص (Features): وتسمى أحيانا بالمتغيرات، وتعدّ أيضاً جزءا من البيانات. وبشكل عام عندما يكون لدينا ملف يحتوي على بيانات كبيرة، يجب اختيار الخصائص بعناية؛ فيجب أن نختار خصائص مميزة، ولها تأثير أكبر في النتائج.
- خوارزميات تعلم الآلة (Alghorithms): هي مجموعة من التقنيات والأساليب التي تستخدم لتطوير نماذج يمكنها التعلم من البيانات وتحليلها، واستخلاص الأنماط والتنبؤات منها. كل مشكله لها حل مختلف، وطريقة الوصول إلى الحل تغير دقة النموذج (Model) النهائي وأداءه وحجمه. يعتمد كل شيء على البيانات المعطاة، فإذا قدمت بيانات خاطئة وغير دقيقه أو غير صحيحه، فلن تستطيع أي خوارزمية إيجاد أفضل نموذج لها.
أجهزة فائقة السرعة والذاكرة: حتى تتمكن الخوارزميات من تطوير نماذج ذات دقة عالية، فإنها تحتاج إلى تحليل البيانات الكبيرة. هذا يتطلب مصادر لديها قدرات حسابية عالية من ناحية السرعة وسعة الذاكرة.
إضافةً إلى العناصر الأساسية، تشمل المتطلبات الإضافية لتنفيذ نموذج تعلّم الآلة الفعال تنظيف البيانات، وتقسيمها بشكل صحيح، واختيار الخوارزمية الأنسب، وتقييم النموذج بشكل مستمر، وتحسين الأداء، والنشر، ومراقبة النموذج في بيئة الإنتاج.
أبحث وأناقش
أبحث في المواقع الإلكترونية الموثوقة عن الفرق بين التعلّم الآلي والذكاء الاصطناعي، وأنظّم المعلومات في مستند Google Docs. ثم أشارك النتائج مع الزملاء.
أنواع خوارزميات التعلّم الآلي
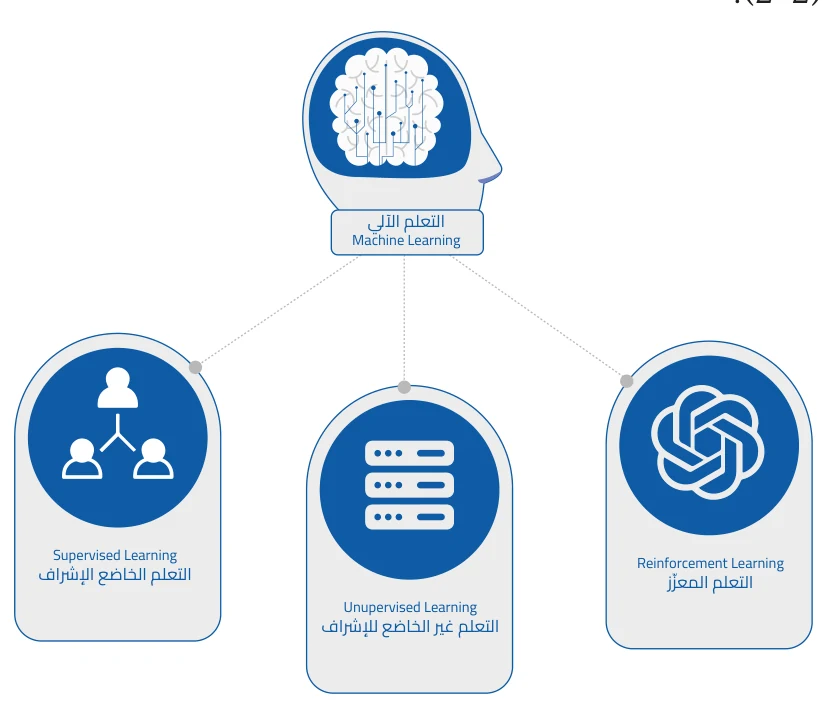
يمكن تصنيف خوارزميات تعلّم الآلة إلى فئات عدّة وفقاً لطبيعة التعلّم وطريقة عملها كما هو مبين في الشكل (2-2).
1. التعلّم الخاضع للإشراف
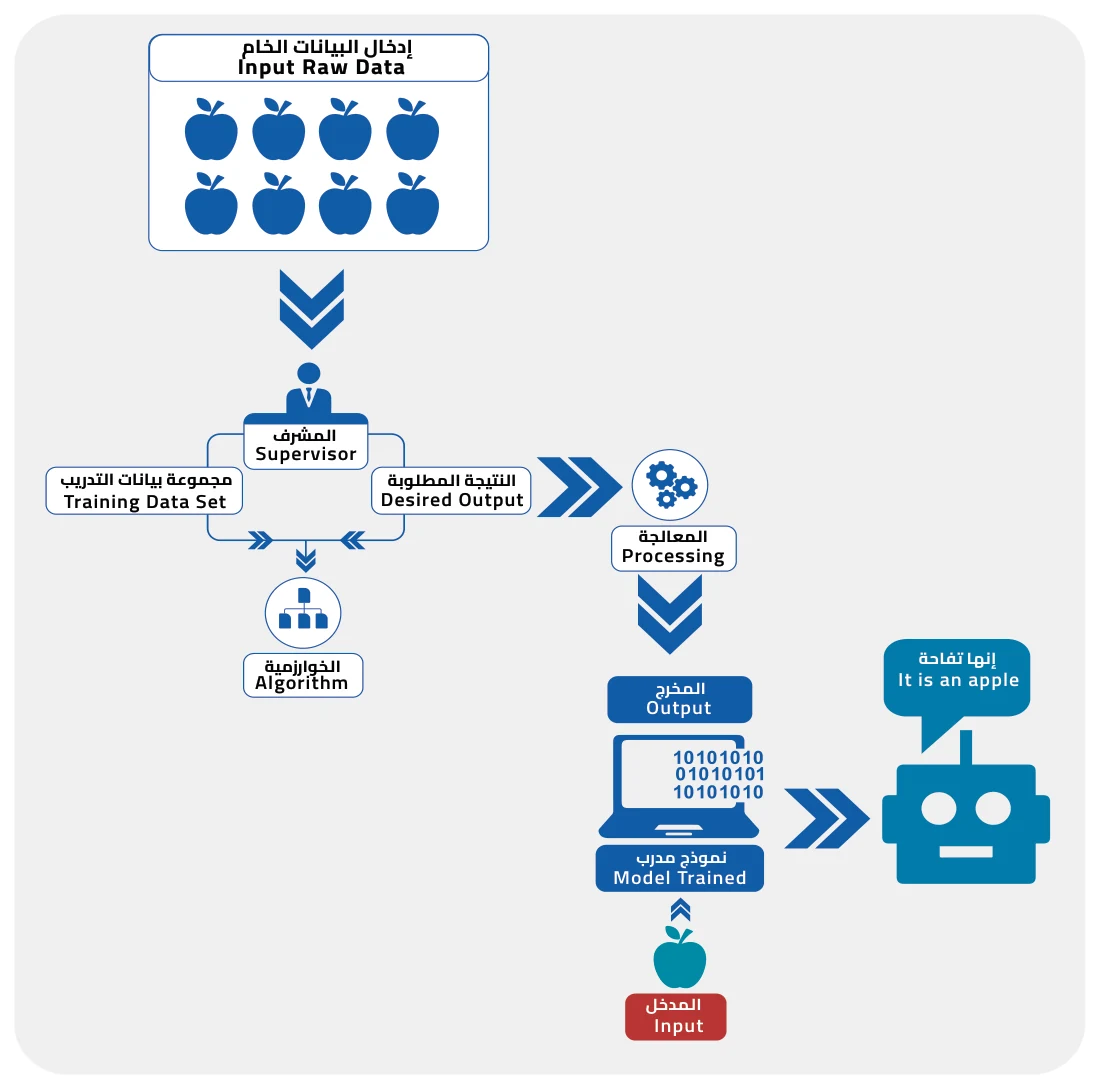
في التعلّم الخاضع للإشراف تُستعمل بيانات موسومة مسبقاً (Labeled Data) لتدريب نموذج تعلّم الآلة على استنباط العلاقات التي تساعد النموذج لتوقع الوسم. فعلى سبيل المثال إذا أردنا تطوير نموذج آلي لتشخيص مرض معين، فإن البيانات بهذه الحالة تشمل الفحوصات الطبية للمريض، بالإضافة إلى وسم لكل عينة تبيّن هل هو مصاب بالمرض أم لا. بعد الانتهاء من التدريب نتوقع من النموذج إعطاء تشخيص لمريض جديد بناءً على الفحوصات الطبية فقط. وإذا أردنا أيضاً تطوير نموذج لتوقع أسعار المنازل باستخدام التعلّم الخاضع للإشراف، يجب تزويد النموذج بخصائص المنازل، مثل عدد الغرف وعمر البناء وغيرها، بالإضافة إلى الوسم وهو سعر البيت في هذه الحالة. بعد التدريب، نتوقع الحصول على نموذج دقيق قادر على توقع سعر بيت معين بناءً على خصائصه. الشكل (2-3) يوضح بشكل مرئي عملية التعلّم الخاضع للإشراف في التعلّم الآلي.
أفكّر وأشارك
أفكر مع زملائي في المجموعة في أمثلة للتعلّم الخاضع للإشراف، يمكن تطبيقها في الحياة مع ذكر طبيعة الوسم لكلّ منها. وأشارك ما نتوصل إليه من أفكار مع المجموعات الأخرى.
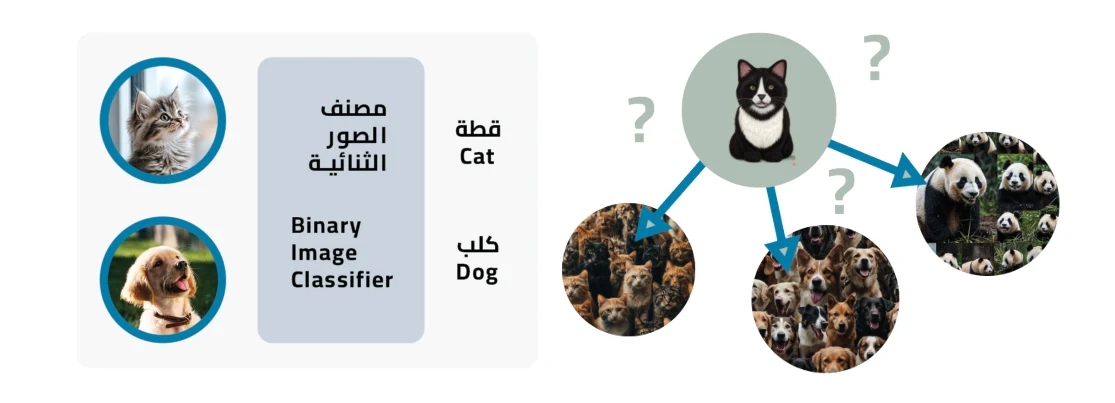
- هي النماذج التي يتم تدريبها بناءً على بيانات يأخذ الوسمُ فيها قيمًا منفصلة محددة (Discrete Values).
- على سبيل المثال، فإن تحديد ما إذا كان المريض مصابًا أم لا، أو إذا كان الإيميل غير مرغوب فيه أو مرغوب فيه، أو تحديد نوع الفاكهة الموجودة في الصورة ما إذا كانت موزًا أو تفاحًا أو برتقالًا، هي مشكلات تصنيفية تحتاج إلى نموذج تصنيف.
- وفي نماذج التصنيف إذا كان عدد الأوسمة اثنين فقط، فيُرمَز إليها "بالتصنيف الثنائي (Binary Classification)، كما هو الحال في مثال تشخيص الحيوانات إلى أحد نوعين.
- أمّا إذا كان عدد الأوسمة أكثر من اثنين، فيُرمَز إليها بالتصنيف متعدد الفئات (Multiclass Classification)، كما هو الحال في مثال تصنيف حيوانات إلى أنواعٍ متعددة. انظر الشكل (2-4).
التصنيف
الشكل (2-4): التصنيف في التعلّم الآلي للمصمم صورة مشابهة ب. نماذج الانحدار (Regression): هي النماذج التي يتم تدريبها بناءً على بيانات يأخذ الوسمُ فيها قيمًا مستمرة (Continuous Values). على سبيل المثال، تحديد سعر المنزل، أو توقع درجة الحرارة بناءً على مجموعة من الظروف الجوية. أمثلة على نماذج التعلّم الخاضع للإشراف:
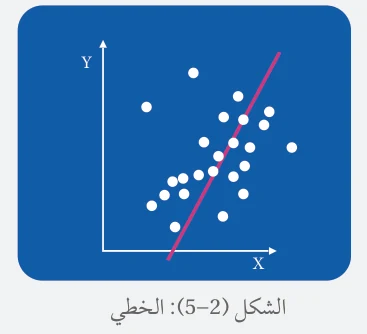
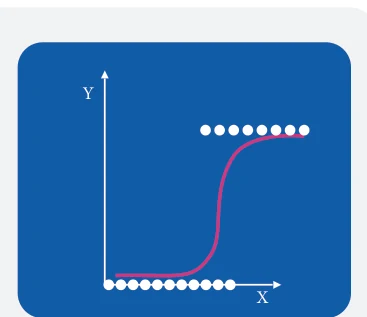
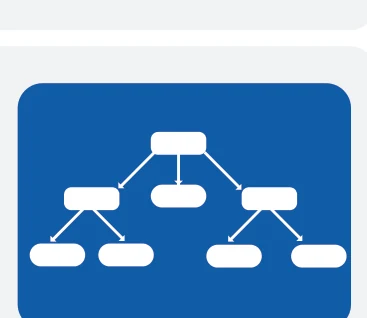
الانحدار الخطي
تُستخدم هذه الخوارزمية لنمذجة العلاقة بين المدخلات والمخرجات باستخدام خط مستقيم. انظر الشكل (5-2).
الانحدار اللوجستي
تُستخدم هذه الخوارزمية للتصنيف الثنائي (مثلًا: نعم/ لا، نجاح/ فشل). انظر الشكل (6-2).
أشجار القرار
- تُستخدم هذه الخوارزمية للتصنيف والتنبؤ؛ حيث تقوم ببناء نموذج يشبه شجرة تتخذُ قرارات بناءً على ميزات المُدخلات.
- كل عقدة في الشجرة تمثل اختبارًا على قيمة مدخل معين، والفروع تمثل نتائج هذا الاختبار، والأوراق تمثل المخرجات.
- يبين الشكل (7-2) شجرة القرار لإيجاد احتمال تعرّض شخص لصدمة قلبية.
أحلل وأصنف
أتعاون مع زملائي في المجموعة لتحليل الحالات الآتية، واختيار نموذج التعلّم الخاضع للإشراف لكل منها.
- تصنيف الطلبة بناءً على أدائهم الأكاديمي.
- توقع قبول الطلبة في برنامج جامعي.
- التعرّف إلى الخطوط المكتوبة باليد.
- التعرّف إلى الوجوه.
- أقارن الإجابات مع المجموعات الأخرى وأناقشهم فيها.
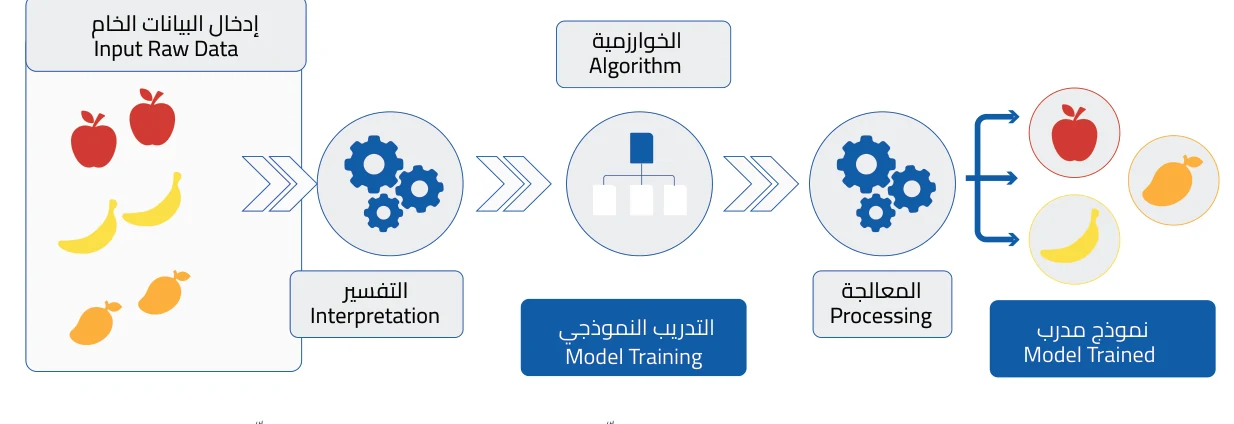
2. التعلّم غير الخاضع للإشراف
- هو نوع من التعلّم الآلي، يُستخدم لاستخراج الأنماط أو الهياكل من البيانات من دون وجود وسم للبيانات، ومن ثمّ لا تُعطي البيانات التي يتم تدريب النموذج عليها أي معلومات مسبقة عن الفئات أو النتائج المستهدفة.
- ويُستخدمُ عندما تكون البيانات غير موسومة أو غير مهيكلة، ويهدف إلى فهم العلاقات الداخلية في البيانات. تساعد تقنيات التعلّم غير الخاضع للإشراف على الاستفادة من البيانات غير الموسومة التي يحتاج وسمها إلى جهد بشريّ كبير من مختصين بالمجال.
- فعلى سبيل المثال، إذا كانت لدينا معلومات عن زوار متجر تسوق إلكتروني معين، وأردنا أن نجد علاقات بين تسوّق الزوار، وتحديد الزوار الذين لديهم الأنماط نفسها، فإن خوارزميات التعلّم غير الخاضع للإشراف، ستعمل على تقسيم الزوار بناءً على أنماط استقرأت واستنتجت من البيانات بوساطة الخوارزمية.
- هذا التقسيم سيكون مفيدًا؛ لأنه يسهل استهداف فئة معينة من دون غيرها بإعلان معين للمتجر. الشكل (11-2) يوضح بشكل مرئي عملية التعلّم غير الخاضع للإشراف في التعلّم الآلي. يُظهر الرسم كيف يتم التعامل مع البيانات الخام (Raw Data) من دون معلومات مسبقة (مثل التصنيفات أو التسميات)، وتحويلها عبر عملية خوارزمية للوصول إلى النتائج النهائية.
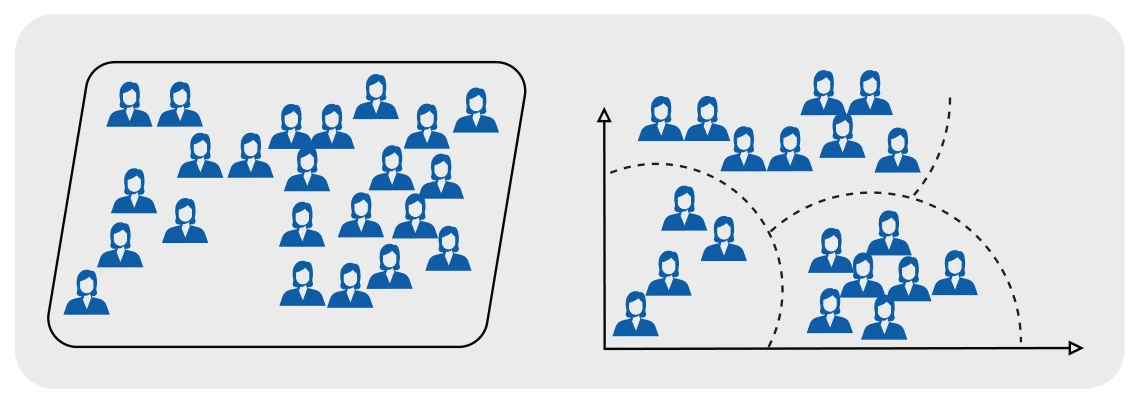
الشكل (11-2): مثال توضيحي لعملية التعلّم غير الخاضع للإشراف في التعلّم الآلي تتنوّع الخوارزميات التي تندرج تحت التعلّم غير الخاضع للإشراف، ونبيّنها في ما يأتي: أ. التجميع (Clustering): يهدف إلى تقسيم البيانات إلى مجموعات (Clusters) بناءً على التشابه بين العناصر. تساعدنا خوارزميات التجميع في تحليل البيانات، وتصميم أنظمة التوصية (Recommended Systems)، وعمل محركات البحث (Search Engines)، وتسهيل عملية وسم كميات كبيرة من المعلومات (Semi-Supervised Learning)، كما هو مبين في الشكل (2-12).
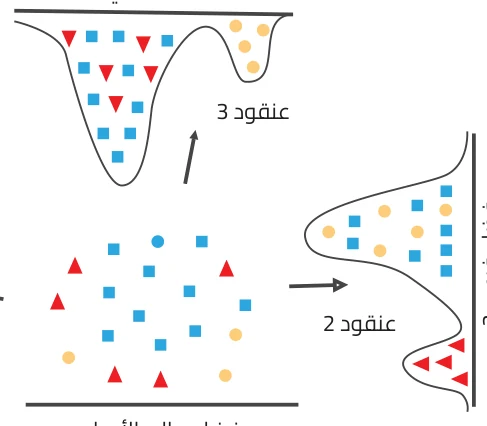
ب. تقليل الأبعاد (Dimensionality Reduction): تهدف إلى تبسيط البيانات عن طريق تقليل عدد المتغيرات مع الحفاظ على أكبر قدر ممكن من المعلومات. وتساعد خوارزميات تقليل الأبعاد في تمثيل البيانات في بعدين أو ثلاثة؛ لتسهيل عرضها ورؤية الهيكل العام للبيانات والتكتّلات إن وجدت. وخوارزميات مثل PCA (تحليل المكونات الرئيسية) من أكثر الأساليب شيوعاً في هذا المجال. وكما يظهر في الشكل (2-13)، تُمثّل البيانات في فضاء عالي الأبعاد، وتُقلّص لعرضها في فضاء فرعي.
ج. اكتشاف القيم المتطرفة أو الشاذة (Detection of Outliers or Anomalies)
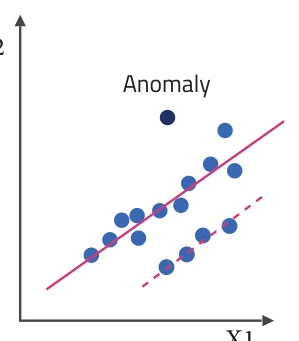
- يتمثّل اكتشاف القيم المتطرفة في الكشف عن محاولات الاحتيال وخاصة عند رصد تصرُّفات غير عادية، أو اكتشاف العينات التي بها عيوب، ومن ثمَّ تعمل على تنقية البيانات من هذه القيم التي قد تؤثر في جودة النماذج التي تعتمد عليها.
- وكما يظهر في الشكل (2-14)، تبرُز القيم الشاذة بوضوح وتظهرُ منفصلة عن الأنماط العامة للبيانات.
دراسة حالة في التعلّم غير الخاضع للإشراف
أتعاون مع مجموعتي على اختيار إحدى الحالات الآتية، ونحدّد خوارزمية التعلّم غير الخاضع للإشراف المناسبة لكل حالة، ثم نعدُّ عرضًا تقديمِيًّا يبين الحالة والمتغيرات والخوارزمية المختارة، ومبررات اختيارها، مع استخدام أداة تمثيل بصري لها؛ باستخدام أحد برامج الذكاء الاصطناعي، ونشاركه مع الزملاء على اللوح التفاعلي للصف، ونتفاعل مع عروض المجموعات الأخرى عبر طرح الأسئلة وطلب التوضيحات.
الحالة 1: بيانات العملاء بناءً على سلوك الشراء
الوصف: شركة تجارة إلكترونية ترغب في تخصيص العروض التسويقية بناءً على الاحتياجات المختلفة لكل عملائها بناءً على سلوكهم الشرائي.
الحالة 2: مجموعة بيانات طبية
الوصف: تتوافر لدى مستشفى مجموعةُ بيانات تحتوي كبيرة تحتوي على العديد من المتغيرات الطبية، مثل نتائج الفحوصات المختبرية للمرضى، والعمر، والجنس. ويرغب المستشفى في تقليل عدد المتغيرات لتحليل البيانات بشكل أكثر فعالية.
الحالة 3: تحليل البيانات النصية للتعليقات
الوصف: موقع للتسوق الإلكتروني يجمع التعليقات النصية من العملاء حول منتجاتهم، ويرغب في استخراج الأنماط الخفية أو تقسيم التعليقات إلى مجموعات بناءً على التشابه في النصوص، وتحليل هذه التعليقات لتحديد الأنماط في ردود الفعل للعملاء من دون تصنيف مسبق.
3. التعلّم المعزّز
- التعلّم المعزّز هو نوع من أنواع التعلّم الآلي، يتخصَّص في كيفية اتخاذ القرارات عن طريق التجربة (خلال المحاولة والخطأ)، والتفاعل مع البيئة بدلاً من تلقي مجموعة ثابتة من البيانات لتعلّمها؛ حيث يُحسّن سلوك الوكيل أو العميل (Agent) بمرور الوقت بناءً على المكافآت والعقوبات التي يتلقاها، والمرتبطة بالأفعال التي يقوم بها، وتكون الأفعال مبنيّة على سياسات معينة يُعدَّل عليها بمرور الوقت.
- يبين الشكل (2-15) آلية عمل التعلّم المعزّز.
- لنقُل مثلاً إننا نريد أن تتعلّم الآلة كيفية لعب لعبة إلكترونية، وطريقة تعلّمها إتقان هذه اللعبة عن طريق عملية تكرار، (Loop).
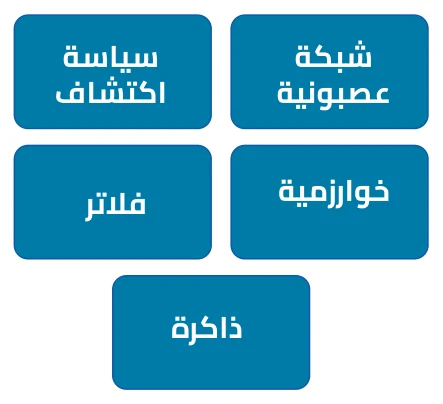
- يمكن أن يكون العميل -مثلاً- هو البرنامج الذي يتحكم في الروبوت.
- في هذه الحالة، تكون البيئة هي العالم الحقيقي؛ حيث يراقب العميل البيئة عن طريق مجموعة من المستشعرات مثل الكاميرات وأجهزة الاستشعار اللمسية، وتتمثل أفعاله في إرسال إشارات لتفعيل المحركات.
- وقد يُبرمج ليحصل على مكافآت إيجابية كلما اقترب من الوجهة المستهدفة، ومكافآت سلبية كلما أضاع الوقت أو اتجه في الاتجاه الخطأ.
خطوات بناء نموذج تعلّم الآلة
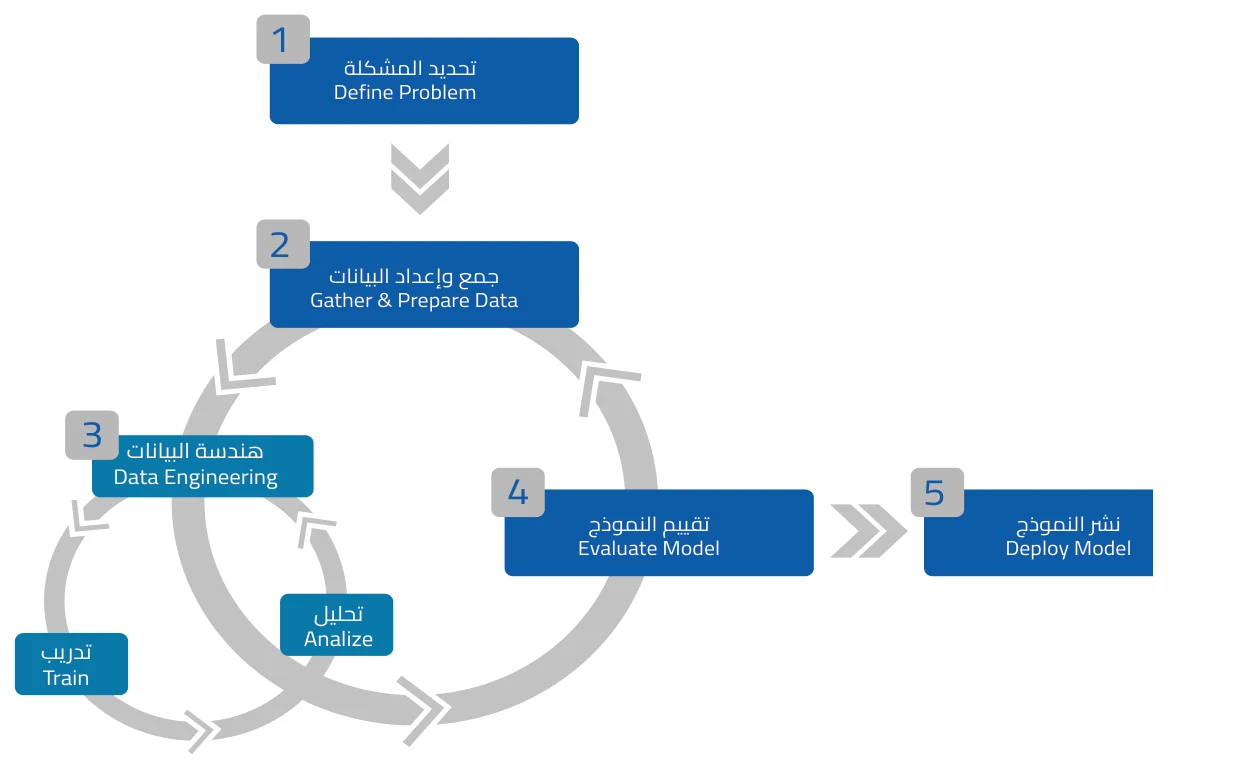
- يبدأ البحث عن حلول عندما يكون هناك مشكلة معينة يسعى المعنيون إلى حلها، ولديهم فهم عن كيفية قيام الشركة باستخدام الحل المقترح وتوظيفه.
- تختلف طرق الحل باختلاف التقنيات المراد استعمالها؛ حيث تتنوع التقنيات، فمنها على سبيل المثال الاستعانة بخبير لوضع قواعد معينة لتحسين الأداء، أو استعمال خوارزميات معروفة في المجال، أو الاعتماد على تقنيات تعلّم الآلة.
أفكر وأناقش
أتخيّل أن شركة ما لجأت لحلول تقنيّات التعلّم الآلي لحل مشكلة معينة، أفكر في الأسئلة التي يجب الإجابة عنها قبل البدء بخطوات بناء نموذج تعلّم الآلة. أشارك أفكاري مع زملائي في الصف.
تتمثّل الخطوات الأساسية لبناء نموذج تعلّم الآلة في ما يأتي:
1. جمع البيانات
- بمجرد تحديد المشكلة، يجب البدء بجمع البيانات اللازمة.
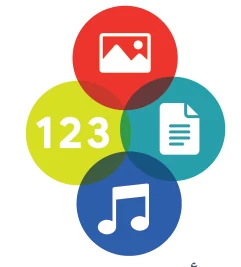
- تعدُّ هذه الخطوة أولِيّة ومهمة في تعلّم الآلة؛ لأن حجم البيانات ونوعيتها تُحدد كفاءة النموذج وفاعليته، وتختلف طبيعة البيانات باختلاف المشكلة.
- فعلى سبيل المثال إذا أردنا توقّع سعر سيارة، فإننا نحتاج إلى بيانات عن السيارة مثل الطراز، والحجم، واللون، وتاريخ الصنع، والمسافة المقطوعة، وغيرها من الخصائص.
- نحتاج أيضًا إلى وسمِ لكل عينة يوضّح سعر السيارة الحقيقي.
وكما تعلّمنا مسبقًا، فإن جميع البيانات التي يُتعاملُ معها ضمن التعلّم الخاضع للإشراف، تنقسم إلى خصائص ووسم؛ حيث إنَّ كلَّ عينة في البيانات يكون لديها قِيَمٌ لهذه الخصائص والوسم.
أتعاون مع مجموعتي على البحث ومناقشة البيانات التي نحتاج جمعها لكل مشكلة من المشكلات الآتية، مع تحديد الخصائص والوسم لكل منها:
- توقُّع أسعار المنازل في الأردن.
- تحديد ما إذا كان الشخص مصابًا بالتهاب رئوي بناء على صورة الأشعة.
- تحديد ما إذا كان الشخص مصابًا بمرض الضغط.
- تحديد درجة صعوبة فقرة مكتوبة باللغة الإنجليزية.
- تحديد الكائن الحي الموجود في صورة.
نعرض ما نتوصل له من نتائج ونناقشه مع المجموعات الأخرى.
2. استكشاف البيانات
استكشاف البيانات المجمعة يشمل عمل إحصائيات عن البيانات وتوزيع العينات فيها، والتأكد من عدم وجود قيم مفقودة أو متطرفة، وتحديد العلاقة بين الخصائص المختلفة التي جُمعت، وتمثيل البيانات والخصائص برسومات تعبيرية؛ للتمكن من فهم البيانات بشكل أفضل.
3. تجهيز البيانات
بعد استكشاف البيانات نحتاج لعمل ما يأتي؛ لتكون المعلومات جاهزة للاستعمال من قبل خوارزميات التعلّم الآلي:
- تنظيف البيانات (Cleaning): إزالة القيم المفقودة أو إعطاؤها قيما بناءً على عمليات إحصائية على بقية العينات، مثل الوسط أو الوسيط أو التكرار. يجب أيضًا تحديد القيم المتطرفة وإزالتها أو تعديلها.
- تسوية البيانات (Scaling): تعديل القيم في البيانات بحيث تكون ضمن نطاق معين، مثل تحويل القيم إلى مقياس موحد.
- تحويل البيانات (Transformation): تحويل البيانات إلى شكل يمكن للنموذج التعامل معه، مثل تحويل النصوص والخصائص غير الرَّقميّة إلى أعداد باستخدام تقنيّات، مثل الترميز أو التمثيل الرَّقمي (Encoding).
- تقسيم البيانات (Splitting): تُقسَّمُ البيانات إلى مجموعات تدريب، ومجموعات اختبار، ومجموعات تحقق. يساعد هذا في تقييم أداء النموذج بشكل صحيح. وهناك قاعدة مهمة عند تقسيم البيانات إلى "تدريب - تقييم" وهي أن نسب تقسيم البيانات يجب أن تكون إما 80% - 20% أو 70% - 30%، على التوالي. يعتمد هذا التقسيم -طبعًا- على الحجم الإجمالي للبيانات.
4. اختيار النموذج (Choose
- تختلف خوارزميات تعلّم الآلة باختلاف الهدف/الوظيفة المراد تحقيقها.
- فهناك خوارزميات تُستخدم لبيانات الصور، وأخرى للنصوص أو الأصوات، وبعضها للبيانات الرَّقميّة.
- عادة ما تُجرَّب أكثر من خوارزمية، وتُختارُ الخوارزمية التي تُنتج أفضل نموذج بناءً على أدوات قياس تنسجم مع طبيعة المشكلة.
5. التدريب (Training)
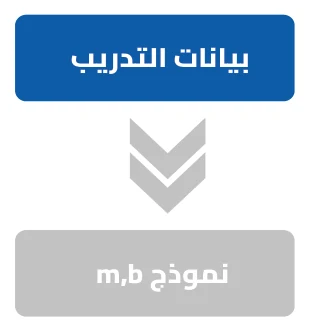
في هذه المرحلة تُستخدم البيانات لتدريب النموذج على إيجاد العلاقات والأنماط بين البيانات وتمثيلها بنموذج رياضي. يبين الشكل (2-18) مثالاً للنموذج الخطي وبعض معاملاته. تتكون البيانات في هذا المثال من خاصية واحدة فقط X ستُستخدم للتنبُّؤ بقيمة Y.
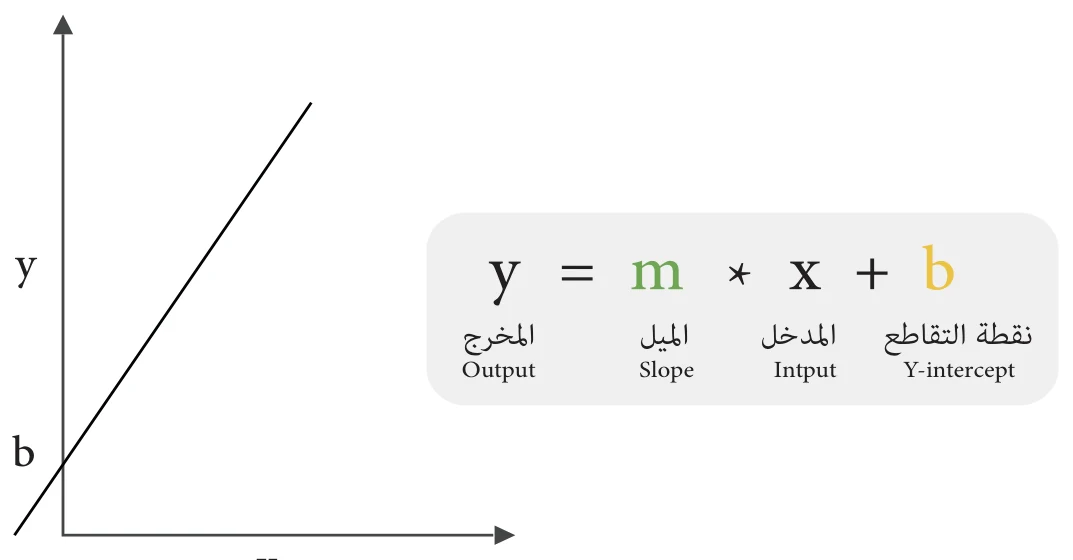
في معادلة الخط المستقيم الظاهرة في الشكل، تمثل Y معادلة النموذج، وسيتم إيجاد قيم m و b التي تجعل من قيمة Y المتوقعة قريبة جدًا من قيمة Y الحقيقية؛ بحيث يتم خلال التدريب تعديل قيم m و b لزيادة الدقة. وتتكرر العملية أكثر من مرة؛ بحيث يُسمى كل تكرار أو دورة لتحديث قيم (m و b) بخطوة تدريب واحدة Epoch. ويتغير الخط المستقيم مع التكرار؛ ليحقق الناتج بشكل مثالي، كما هو موضح في الشكل (2-19).
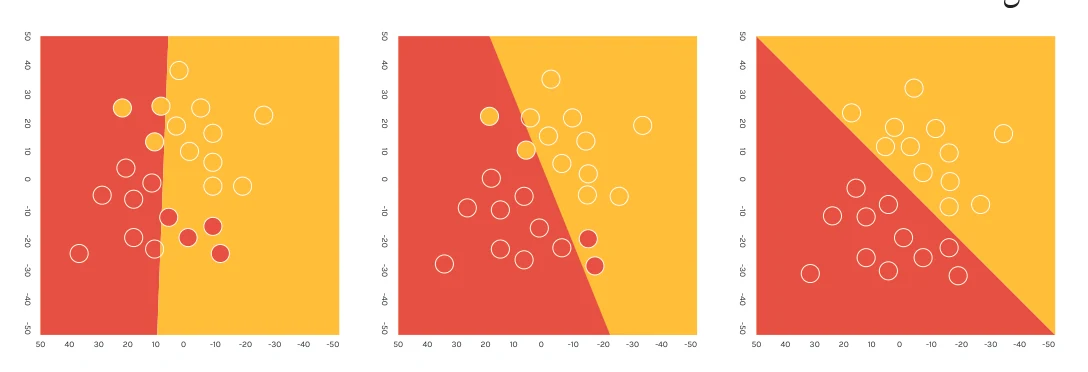
ويبين الشكل (2-20) الآلية التي يتم فيها تدريب النموذج وتحسينه بشكل مستمر للحصول على دقة جيدة.
6. تقييم النموذج (Evaluation)
بعد الانتهاء من عملية التدريب، يجب التحقق من أداء النموذج بحسب الخطوات الآتية:
- تقسيم البيانات: تقسيم البيانات إلى مجموعة تدريب ومجموعة اختبار. تُستخدم أحياناً مجموعة تحقق (Validation) إضافية لضبط المُعلّمات (Hyperparameters).
- اختيار المقاييس المناسبة: يوجد مقاييس عدة للتقييم نذكر منها: الصحة والاسترجاع والدقة.
- مصفوفة الالتباس (Confusion Matrix): جدول يُستخدم لوصف أداء نموذج التصنيف. يعرض عدد التنبؤات الصحيحة والخاطئة مقسمة بحسب النوع، في التصنيف الثنائي، وتحتوي المصفوفة على المكونات الآتية:
- الإيجابيات الصحيحة (TP): عدد الحالات الإيجابية التي تم التنبؤ بها بشكل صحيح.
- السلبيات الصحيحة (TN): عدد الحالات السلبية التي تم التنبؤ بها بشكل صحيح.
- الإيجابيات الخاطئة (FP): عدد الحالات السلبية التي تم التنبؤ بها بشكل خاطئ على أنها إيجابية.
- الإيجابيات المفقودة (FN): عدد الحالات الإيجابية التي تم التنبؤ بها بشكل خاطئ على أنها سلبية.
- معدل الخطأ (Error Rate): نسبة النصوص التي تُصنَّف بشكل خاطئ.
- متوسط مربع الخطأ (Mean Square Error): متوسط الفرق بين النتائج المتوقعة والحقيقية، ويُستعمل لتقييم أداء نماذج الانحدار.
أبحث
- يوجد مقاييس أخرى يمكن استعمالها في تقييم النموذج، وتعتمد على طبيعة المشكلة المراد حلها.
- أبحثُ في المصادر الإلكترونية الموثوقة عن هذه المقاييس وأدوّنها في مستند Google Docs وأشارك النتائج على اللوح الرَّقمي التفاعلي للصف.
- تطبيق النموذج على مجموعة الاختبار: استخدام النموذج المدّرب لتصنيف النصوص أو معالجتها في مجموعة الاختبار.
- حساب المقاييس: هو مقارنة النتائج المتوقعة مع النتائج الفعلية، وحساب المقاييس المختارة؛ وذلك بتجريب على بيانات التحقق (Test Set) غير المرئية للنموذج، والتي أشرنا لها مسبقًا في الخطوة الثالثة؛ حيث تعكس نتائج الاختبار على مجموعة الاختبار دقة أداء النموذج وقابليته للاستخدام في الواقع الحقيقي.
أبحث
أستخدم موقع الذكاء الاصطناعي Gemini للبحث عن الفرق بين مقاييس التقييم، وأدوّن ما أتوصل إليه في ملف Google docs، وأشاركه على اللوح الرَّقمي التفاعلي للصف.
9. تحسين النموذج
- بعد الانتهاء من الخطوة السابقة، قد تحتاج أحياناً إلى تحسين النموذج قدر الإمكان.
- ويمكننا عمل ذلك عن طريق إعادة ضبط الخصائص/المعاملات Hyperparameters Tuning التي تدرّب عليها النموذج مُسبقًا.
- ومن هنا قد تنتجُ لنا عدداً من التجارب كل واحدة منها بدقة مختلفة؛ تبعاً للعامل الذي تم تغييره.
10. نشر النموذج (Publishing)
- بعد الانتهاء من بناء النموذج، نقوم بتثبيته ونشره على الخوادم؛ حتى يكون متاحًا للاستعمال.
- عادةً تُطوَّر واجهة مثل موقع إلكتروني، أو تطبيق ما؛ حتى يتمكن المستخدم من التعامل مع النموذج بفعالية وسهولة.
- يجب مراقبة النموذج باستمرار للتأكد من فعالية أدائه، وأنه ما زال متاحاً للمستخدمين، وإجراء الصيانة اللازمة للخوادم إذا لزم.
- مع مرور الوقت قد نحتاج إلى إعادة تدريب النموذج على بيانات جديدة، أو باستخدام خوارزميات أحدث قد تعطي نتائج أفضل.
أدوات بناء نموذج التعلّم الآلي
هناك عديدٌ من الأدوات التي يمكن استخدامها لبناء أنظمة تعلّم الآلة، ويمكن تصنيف هذه الأدوات إلى قسمين:
- أدوات لديها واجهة للمستخدم وأيقونات، يمكن للمستخدم سحبها ووضعها على مساحة العمل. وتربطُ هذه الأيقونات بعضها مع بعض بتسلسل معين لإنجاز مهمة معينة. ومن الأمثلة عليها أداة Orange Data Mining وأداة KNIME.
- باستخدام لغة برمجة معينة لكتابة البرامج مثل python، واستعمال مكتبات تحليل البيانات وخوارزميات تعلّم الآلة لإنجاز مهمة معينة. تعدُّ Sklearn من أهم المكتبات المستخدمة في هذا المجال.
سنتعلّم فيما يأتي إحدى الأدوات لبناء نموذج تعلّم آلي بشكل تطبيقي:
استكشاف أداة
- تعدُّ أداة (Orange Data Mining) منصة مفتوحة المصدر ومجانية، يمكن استخدامها في مجموعة متنوعة من التطبيقات، من تحليل البيانات البسيط إلى بناء نماذج التعلّم الآلي المتقدم والتعلّم العميق.
- وتعدُّ من أهم البرمجيات التي توفر بيئة مستخدم سهلة لبناء نماذج تعلّم الآلة عن طريق ربط القطع (Widgets) بعضها ببعض.
تتميز هذه الأداة بعدد من المميزات نذكر منها:
- واجهة رسومية: تُسهّل بناء نماذج التحليل والتعلّم الآلي من دون الحاجة لكود برمجي.
- التعلّم الآلي: تدعم العديد من خوارزميات التعلّم الآلي مثل التصنيف، والتجميع، والانحدار.
- التحليل البصري: توفر أدواتٍ لعرض البيانات بصريًا، وتساعد في اكتشاف الأنماط.
- التكامل: يمكن دمجها مع أدوات أخرى مثل Python لزيادة القدرة على التحليل.
واجهة المستخدم والأيقونات
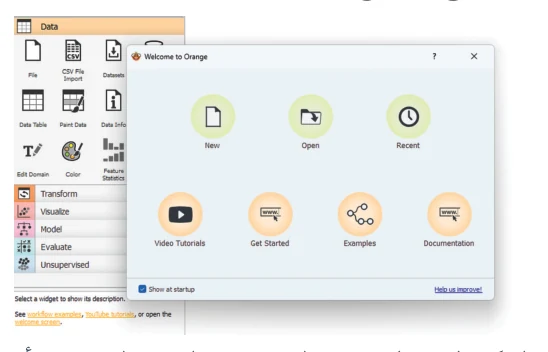
تظهر الشاشة الترحيبية عند تشغيل هذه الأداة كما يظهر في الشكل (2-21)، والتي يُمكن عن طريقها بدء مشروع جديد، أو فتح مشروع سابق، أو مشاهدة فيديوهات تعليمية، أو أمثلة، أو غيرها.
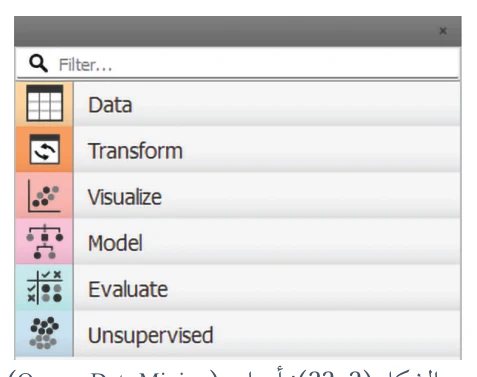
في الجهة اليسرى من الشاشة تظهر الأدوات (Widget) كما يظهر في الشكل (2-22) المصنّفة بحسب طبيعة عملها. وفي ما يأتي توضيح لكلّ منها:
- مجموعة البيانات (Data): تحتوي على مجموعة من الأيقونات، تمكّننا من قراءة البيانات وعرضها وتخزينها.
- مجموعة التحويل (Transform): تحتوي على مجموعة من الأيقونات التي تمكّننا من معالجة البيانات وتجهيزها.
- مجموعة عرض البيانات (Visualize): تحتوي على مجموعة من الأيقونات لعرض البيانات والنتائج على شكل رسومات، قد تتضمن معلومات إحصائية لتسهيل فهمها.
- مجموعة النماذج (Model): تحتوي على مجموعة من الأيقونات لخوارزميات تعلّم الآلة المختلفة التي يمكن تدريبها.
- مجموعة التقييم (Evaluate): تحتوي على مجموعة من الأيقونات لتقييم أداء النماذج المدّربة وعرضها.
- مجموعة خوارزميات التعلّم غير القابل للإشراف (Unsupervised): تحتوي على مجموعة من الأيقونات لخوارزميات مختلفة ضمن التعلّم غير الخاضع للإشراف.
الشكل (2-23) يبين الأيقونات التي تظهر عند الضغط على مجموعتي Data و Visualize. وعند التأشير على أي أيقونة سيظهرُ أسفلها الوصف الخاص بها.
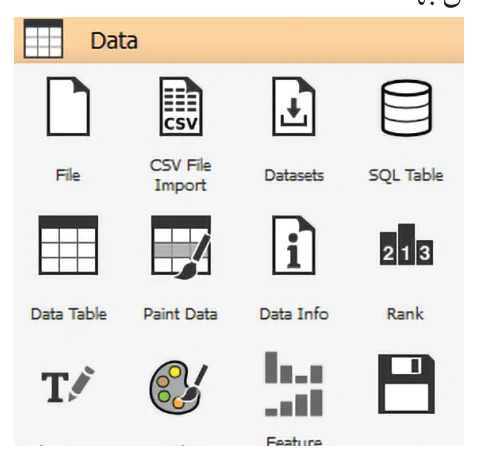
والجدول (2-1) يبين الأيقونات ووظائفها:
| الأيقونة | المجموعة | الوظيفة |
|---|---|---|
| مجموعة البيانات. | تُستخدم لقراءة الملف الذي يحتوي البيانات. |
|---|---|
| مجموعة البيانات. | عرض البيانات على شكل جدول بعد قراءتها عن طريق أيقونة الملف. |
|---|---|
| مجموعة البيانات. | تقسيم البيانات لمجموعة تدريب وتحقق. |
|---|---|
| مجموعة التحويل. | ملء الحقول التي ليس لديها قيم. |
|---|---|
| مجموعة التحويل. | ترميز الحقول التي تحتوي على قيم فئوية. | |
|---|---|---|
| الأيقونة | المجموعة | الوظيفة |
| مجموعة عرض البيانات. | عرض البيانات على شكل رسم متشتت. |
|---|---|
| مجموعة عرض البيانات. | عرض البيانات الشجرية. |
|---|---|
| مجموعة النماذج. | تطبق خوارزمية شجرة القرار على المدخلات. |
|---|---|
| مجموعة النماذج. | تطبق خوارزمية الانحدار الخطي على المدخلات. |
|---|---|
| مجموعة التقييم. | تقييم النموذج المدّرب. المدخلات هي النموذج المدّرب والبيانات التي سيتم الفحص عليها (مجموعة التدريب والاختبار). |
|---|---|
| مجموعة التقييم. | حساب معايير تقييم أداء النموذج. |
|---|---|
| مجموعة خوارزميات التعلّم غير الخاضع للإشراف. | تطبيق خوارزمية التجميع على المدخلات. |
|---|
الجدول (2-1): أيقونات أداة
- لإضافة أيقونة؛ أنقر عليها باستخدام الفأرة أو يُمكن سحبها وإفلاتها داخل حيز العمل، أو النقر باستخدام زر الفأرة الأيمن في حيز العمل واختيار الأداة المراد إضافتها.
- ولتغيير اسم أداة مختارة داخل حيز العمل أنقر عليها باستخدام زر الفأرة الأيمن وأختار تغيير الاسم Rename، وكتابة الاسم الجديد، ثم أنقر على مفتاح Enter.
تحميل أداة واستخدامها
- أفتح المتصفح وانتقل إلى الموقع الرسمي لـ Orange Data Mining.
https://orangedatamining.com/download
- أختارُ نظام التشغيل الخاص بجهازي.
- بعد اختيار نظام التشغيل، اضغط علي زر "Download".
- إذا كنتُ أستخدم نظام Windows، سأطالبُ بتنزيل ملف التثبيت (.exe).
- إذا كنتُ أستخدم macOS، سأطالبُ بتنزيل حزمة التثبيت (.dmg).
- أفتحُ ملف التثبيت الذي تم تنزيله، وأتَّبعُ التعليمات الظاهرة على الشاشة.
- ملحوظة: في أثناء عملية التثبيت، قد يُطلب تثبيت بعض التطبيقات الخاصة ببايثون.
يجب قبول هذه الطلبات ومتابعة التثبيت لضمان عمل الأداة بشكل صحيح.
- بعد اكتمال التثبيت، افتح برنامج Orange Data Mining.
- ستظهر واجهة المستخدم الخاصة بالأداة.
استكشاف المجموعات والأيقونات
- في واجهة المستخدم، ألاحظُ مجموعة من الأيقونات والأدوات المصنفة في مجموعات.
- أحاول سحب أيقونة File من مجموعة Data إلى مساحة العمل (Workspace).
- أضغطُ على أيقونة File واختر ملف بيانات جاهز لتحليله.
- أصلُ أيقونة File بأيقونة Scatter Plot من مجموعة Visualize لرؤية البيانات في شكل رسم بياني.
- أستكشفُ المجموعات والأيقونات في واجهة المستخدم.
ملحوظة: يُمكن أن تُطلب في أثناء التنزيل تطبيقات خاصة ببايثون يجب قبولها، ثم متابعة خطوات التحميل.
أُشغّلُ أداة Orange Data Mining وأنفّذُ الآتي:
- أضيف أيقونة ملف، ومن ثم أغير اسمها إلى My First Tool، ثم أكررها عن طريق النقر على زر الفأرة الأيمن، واختيار Duplicate، ومن ثم أعيد تسميتها إلى My Second Tool.
- أنقرُ بزر الفأرة على مكان فارغ في حيز العمل، ثم أكتب في مربع البحث Data، وأختار Data Table من مجموعة الخيارات الظاهرة.
- للربط بين الأيقونات، أنقر على الخط المتقطع المحيط بالأيقونة وأسحبُ إلى الأيقونة الثانية.
- أعرض ما توصلت إليه أمام الزملاء.
البيانات وعرضها
تُعد البيانات العمود الفقري للذكاء الاصطناعي وعلم البيانات، فهي الأساس الذي يُبنى عليه. ولربطها داخل المشروع أقوم بما يأتي:
- إضافة أيقونة File إلى حيز العمل، ثم النقر مزدوجًا لتحديد الملف الذي يُراد أخذ البيانات منه كما يظهر في الشكل (2-24).
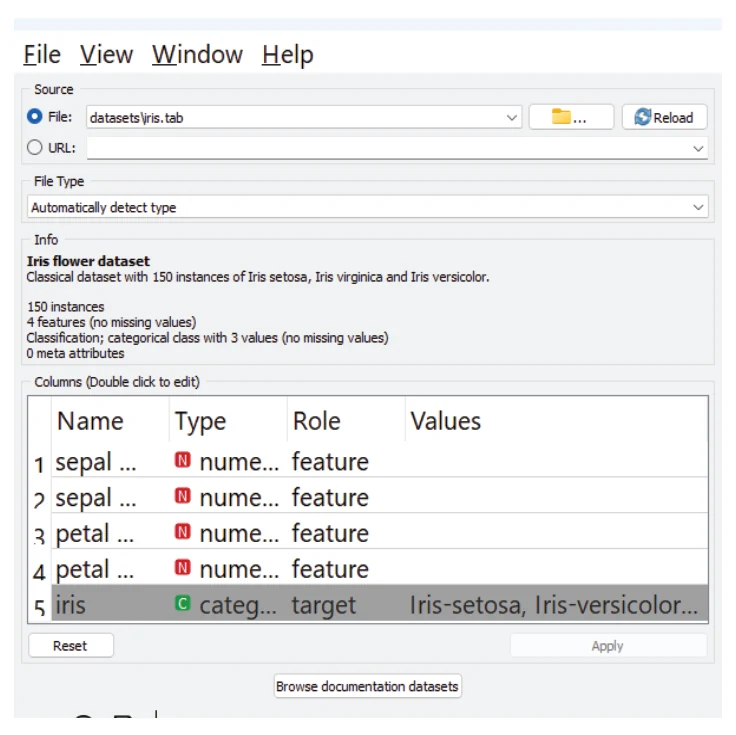
ويُمكن اختيار البيانات عن طريق النقر على زر استعراض [...] والانتقال إلى المكان الذي يحتوي الملف الذي سيُحمَّلُ منه ويُختارُ. وفي هذا المشروع سيُختارُ iris.tab.
- تظهر معلومات خاصة بالبيانات التي اختيرت في الجزء الثاني والثالث من مربع الحوار، وهي اسم مجموعة البيانات، وعدد السجلات المدخلة، والخصائص. وفي هذا المثال تم التعامل مع زهرة السوسنة Iris لتحديد النوع الذي تنتمي له الزهرة عن طريق طول كل من البتلات والسبلات وعرضها؛ حيث ستُصنَّفُ إلى (Iris-setosa, Iris-versicolor, Iris-virginica) بناءً على أطوال البتلات والسبلات، ثم يُنقر على زر Apply.
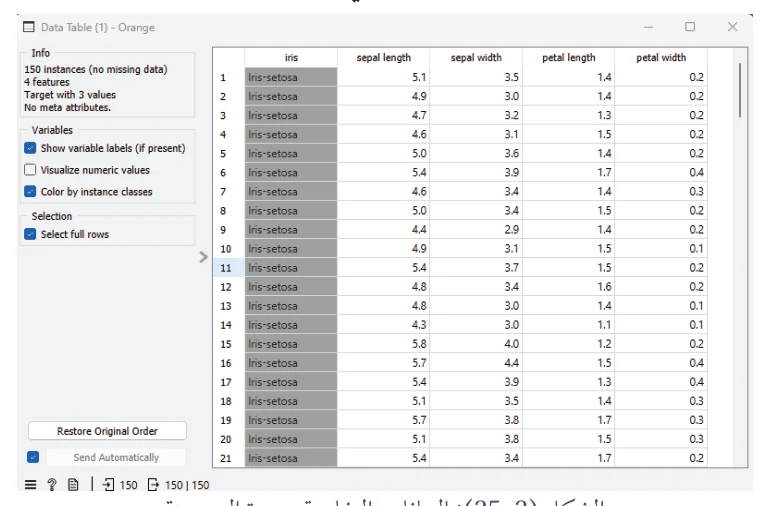
لمشاهدة البيانات الخاصة بزهرة السوسنة Iris، تُربط أيقونة File بأيقونة Data Table، ثم يُنقر على أيقونة Data Table نقرًا مزدوجًا كما يظهر في الشكل (2-25).
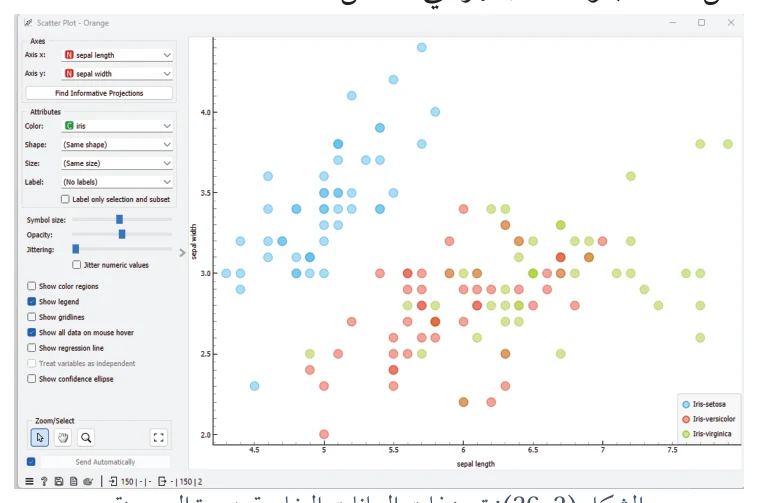
لعرض هذه البيانات، تُربط أيقونة Data Table بأيقونة Scatter Plot؛ حيث يتم إظهارها بحسب التصنيفات؛ كل صنف بلون كما يظهر في الشكل (2-26).
أنفّذُ خطوات ربط الأيقونات لربط أيقونة Data Table بأيقونة Bar Plot، وألاحظ الفرق بينها وبين أيقونة Scatter Plot. ثم أربط أيقونة Data Table بأيقونة Distributions وألاحظ الفرق. أناقش ما توصلت إليه مع الزملاء. إثراء تعدُّ السوسنة السوداء من أندر الأزهار في العالم، وتتميز بألوانها التي تمثل مزيجًا فريدًا من اللونين الأسود والأرجواني الداكن مع بقعة بيضاء في منتصفها، وعلى الرغم من جمال هذه الأزهار ومظهرها الرقيق الواضح، فإنها تتصف بصلابتها وقدرتها على البقاء في أقسى البيئات مثل الصحراء العربية. وتعدُّ هذه الزهرة رمزًا وطنيًا للمملكة الأردنية الهاشمية، ويمكن العثور عليها في المناطق البرية؛ فالتربة الرملية الجافة في الأردن مناسبة تمامًا لنمو هذه الزهرة البرية النادرة.
تدريب خوارزمية شجرة القرار
لنتمكن من بناء نموذج التعلّم الآلي، يجب اتباع الخطوات التي ذُكرت مسبقًا ضمن بند "خطوات بناء نموذج تعلّم الآلة". في ما يأتي توضيح لخطوات تدريب خوارزمية شجرة القرار على البيانات باستخدام أداة (Orange Data Mining)، وتقييم النتائج وعرضها:
- جمع البيانات واستكشافها: عن طريق أيقونة الملف (File) تُختارُ البيانات المطلوبة وتُعالجُ. تُستعرضُ الخصائص المتاحة لكل سمة أو متغير في البيانات، بالإضافة إلى تفاصيل كل خاصية (Feature). تُختارُ أيضًا الخاصية المستهدفة (الوسم) التي سيُبنى النموذج بناءً عليها.
- تجهيز البيانات: حتى نتمكن من تجهيز البيانات، يجب اتباع عدد من الخطوات التي تعتمد على البيانات نفسها. ومن هذه الخطوات:
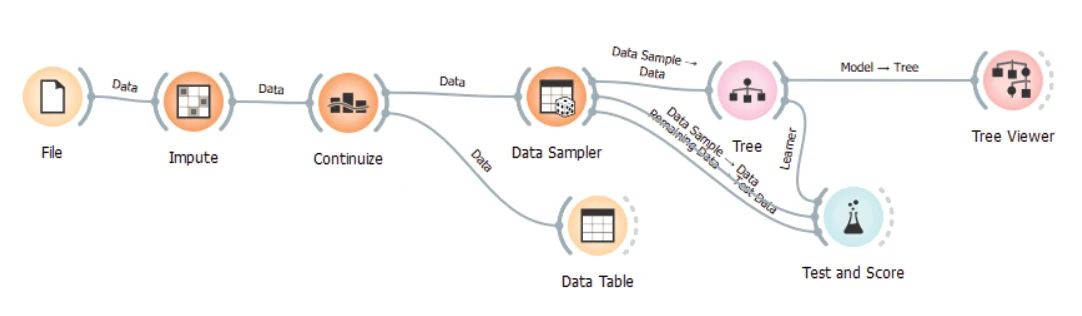
- أ. ربط البيانات الصادرة من أيقونة (File) بالمدخل للأيقونة (Impute) حتى نتمكن من إعطاء قيم للحقول ذات القيم المفقودة. تُختارُ الآلية عن طريق النقر بشكل مزدوج على الأيقونة.
- ب. ربط المخرج من الأيقونة (Impute) مع مدخل أيقونة (Continuize) والتي بدورها تقوم بتحويل الخصائص التي تمتلك قيماً نصية إلى أرقام. النقر المزدوج على هذه الأيقونة يمكننا من اختيار الطريقة الأنسب للبيانات.
- ج. تقسيم البيانات عن طريق أيقونة (Data Sampler) إلى مجموعة التدريب ومجموعة الاختبار بحسب نسبة معينة. ولأنَّ هذه الأيقونة تنتج مجموعتين، سنجد هناك رابطتين بين (Data Sampler) و (Test and score). والهدف من الرابطتين هو توجيه مجموعة التدريب والاختبار بين الأيقونتين. يمكن استعراض التوجيه وتعديله بالضغط على أي من الرابطتين.
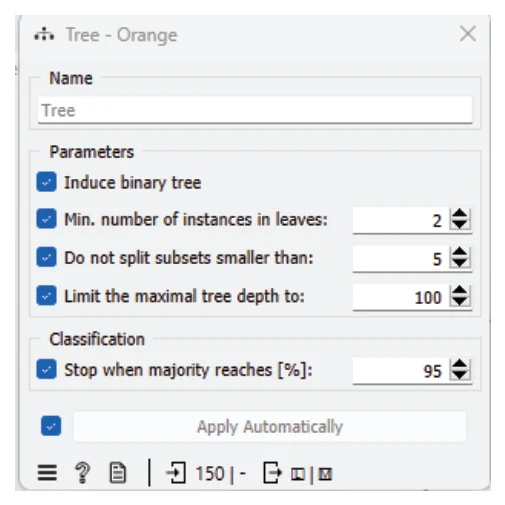
- اختيار النموذج: توضَعُ الأيقونة الخاصة بالنموذج المراد تدريبه (وهي في حالتنا شجرة القرار) وتوجيه البيانات الصادرة من أيقونة (Data Sampler) إلى النموذج المراد تدريبه وهو (Decision Tree). يمكن تعديل الخصائص والمعاملات للخوارزمية عن طريق النقر على أداة النموذج. على سبيل المثال عند النقر نقرًا مزدوجًا على أيقونة (Tree) لمشاهدة الخيارات، تظهر كما في الشكل (2-27) ويُمكن تغييرها بما يتناسب والمطلوب وهي كما يأتي:
- أ. الحد الأدنى لعدد الحالات في الأوراق (Min. number of instances in leaves)، والخيار المحدد في الشكل هو 2.
- ب. لا تقسم المجموعات الفرعية الأصغر من (Do not split subsets smaller than)، والخيار المحدد هنا هو 5.
- ج. حدّد الحد الأقصى لعمق الشجرة (Limit the maximal tree depth to)، والخيار المحدد هنا هو 100.
- التدريب وتقييم النتائج: عند ربط الأيقونات بعضها مع بعض، يتم تدريب النموذج وحساب النتائج. هناك طرق عدة لتقييم النتائج، منها استعمال أداة (Test and Score) التي تستقبل المخرج من النموذج المدّرب وأيقونة (Data Sampler) لتقييم نتائج النموذج، بالإمكان ربط أكثر من نموذج على أيقونة (Test and Score)، فتقوم هذه الأيقونة باختيار أدوات القياس المناسبة بحسب طبيعة الوسم للبيانات قيد الدراسة، ويمكن استعراض النتائج بالنقر المزدوج على الأداة.
- عرض النتائج: أيقونة (Tree Viewer) تعرض نموذج شجرة القرار على شكل شجرة كما يظهر في الشكل (2-28).
تدريب النماذج باستخدام مجموعات بيانات مختلفة
أنفّذُ الخطوات السابقة على بيانات (Iris.tab) التي تهدف إلى التنبؤ بنوع السوسنة. أبدأ بتحميل البيانات من الملف (Iris.tab)، وأنفّذُ خطوات إعداد البيانات وتدريب خوارزمية شجرة القرار. استعرض النتائج وأقارنها مع الزملاء.
إضاءة
مجموعة بيانات (Iris.tab) هي واحدة من أكثر مجموعات البيانات المستخدمة شيوعاً في تعلّم الآلة وتعلّم البيانات. يمكنك الحصول عليها من مصادر عدة. هنا بعض الخطوات للحصول على Iris.tab واستخدامها؛ يأتي (Orange Data Mining) مثبتاً مسبقاً مع مجموعة من مجموعات البيانات المدمجة، بما في ذلك بيانات (Iris.tab). عند تشغيل البرنامج، انتقل إلى أيقونة الملف (File)، وهناك يمكنك اختيار (Iris.tab) مباشرة من القائمة إذا كانت مثبتة مع البرنامج. أو تحميل ملف Iris.tab من الإنترنت: إذا كنت بحاجة إلى تحميل مجموعة البيانات بشكل مستقل، يمكنك العثور عليها على الموقع التالي: https://archive.ics.uci.edu/dataset/53/iris أو مسح رمز الاستجابة السريع المجاور.
تدريب نموذج شجرة القرار على بيانات (heart_disease)
أتعاون مع الزملاء في المجموعة لتنفيذ خطوات تدريب خوارزمية شجرة القرار على بيانات (heart_disease) التي تهدف إلى التنبؤ بأمراض القلب باستخدام خوارزمية شجرة القرار، وأتبع الخطوات الآتية:
- استخدم خاصية (Diameter Narrowing) كوسم.
- ترميز البيانات الفئوية باستخدام (One-Hot Encoding).
- الاحتفاظ بالبيانات الرَّقميّة كما هي.
- تدريب النموذج ومقارنة النتائج مع مجموعات أخرى.
إضاءة
للوصول لبيانات (heart_disease)، يمكنك زيارة الموقع الإلكتروني (https://www.kaggle.com) والبحث عن Heart Disease Dataset أو استخدام الرابط الآتي مباشرة: https://www.kaggle.com/datasets/jithu10/heart-disease-uci-dataset أو مسح رمز الاستجابة السريع المجاور. بعد تحميل مجموعة البيانات بصيغة CSV أو Excel، يمكنك إضافتها يدويًا إلى Orange Data Mining باستخدام أيقونة الملف (File)؛ لتحميل البيانات والعمل عليها.
بناء نموذج انحدار على بيانات (Housing.csv)
أتعاون مع الزملاء في المجموعة لبناء نموذج انحدار على البيانات الموجودة بملف (Housing.csv) التي تهدف إلى التنبؤ بأسعار المنازل. باتباع الخطوات الآتية:
- فتح الملف ببساطة برمجية (Microsoft Excel) واستعراض محتوياته والخصائص التي سيُعتمد عليها لتوقّع سعر البيت.
- إضافة أيقونة الملف وضبطها لتحميل الملف (Housing.csv) من الجهاز.
- ضبط أيقونة الملف ليصبح عمود (Price) هو الوسم.
- إضافة الأيقونة المناسبة لملء القيم المفقودة إن وجدت.
- إضافة الأيقونة المناسبة لتحويل القيم غير العددية إلى قيم عددية تبدأ قيمها من 0.
- تقسيم البيانات إلى مجموعة التدريب ومجموعة اختبار؛ بحيث تشكل مجموعة التدريب 80% من البيانات.
- تدريب خوارزميات (Decision Tree)، (Random Forest) و (SVM) على البيانات.
- استعراض نتائج النماذج على مجموعة الاختبار، ومقارنة النتائج مع المجموعات الأخرى.
إضاءة
مجموعة بيانات (Housing.csv) هي واحدة من مجموعات البيانات الشائعة المستخدمة في تحليل البيانات وبناء نماذج التعلّم الآلي لتوقُّع أسعار المنازل. يمكنك الحصول عليها من مصادر عدة. يمكنك زيارة الموقع الإلكتروني (https://www.kaggle.com) والبحث عن Housing Dataset أو Boston Housing Dataset أو استخدام الرابط الآتي مباشرة: https://www.kaggle.com/datasets/altavish/boston-housing-dataset أو مسح رمز الاستجابة السريع المجاور. بعد تحميل مجموعة البيانات والعثور على مجموعة البيانات وتحميلها (عادة بصيغة CSV)، يمكنك إضافتها يدويًا إلى Orange Data Mining باستخدام أيقونة الملف (File) لتحميل البيانات والعمل عليها. إثراء بناء نظام تعلّم آلي لتمييز الخطوط باستخدام (ChatGPT) استخدم برنامج (ChatGPT) لإنشاء كود (Python) لنظام تعلّم آلي، يقوم بتمييز الأرقام المكتوبة بخط اليد. أقارن النتائج التي حصلت عليها مع نتائج المجموعات الأخرى. هل اختلفت النتائج؟ أبرّر إجابتي.
- هل أستطيع تطبيق البرنامج في بيئة بايثون؟
- أسأل برنامج (ChatGPT) عن متطلبات تنفيذ البرنامج في بيئة بايثون، وأجرب تطبيقه.
أشارك نتائج ما توصلت إليه مع الزملاء.
أبحث
أبحث في المواقع الإلكترونية الموثوقة عن تطبيقات التعلّم الآلي في التعليم، ثم أعدُّ عرضًا تقديمِيًّا باستخدام (Google Slides)، وأشاركه على اللوح الرَّقمي التفاعلي للصف.
المواطنة الرَّقميّة
- السلامة: يجبُ أن أعي أهمية تصميم أنظمة تعلّم آلي آمنة، والتفكير في العواقب الأخلاقية لاستخدامها.
- الخصوصية وحماية البيانات: تعتمد أنظمة التعلّم الآلي على جمع كميات كبيرة من البيانات الشخصية وتحليلها. ويجب إدراك أهمية حماية خصوصية الأفراد، وعدم استخدام البيانات بطرق غير قانونية أو غير أخلاقية.
- المسؤولية والمساءلة: يجبُ أن أعي المسؤولية والمساءلة عن القرارات التي تتخذها أنظمة الذكاء الاصطناعي، خاصة إذا كانت هذه القرارات تؤثر في حياة الناس تأثيرًا كبيرًا.
- العدالة الاجتماعية والمسؤولية الاجتماعية: يجدر بي التفكير عند تصميم أنظمة التعلّم الآلي بكيفية استخدام التكنولوجيا لدعم الإنسان بدلاً من استبداله بالكامل.
المشروع: بناء نظام خبير لاختيار السيارة المناسبة بناءً على طبيعة الاستخدام، وتطبيق خوارزميات التعلّم الآلي والنمذجة ومعالجة اللغات الطبيعية /المهمة 2. أتعاون مع زملائي على استكمال المشروع وتنفيذ المهمة الثانية التي تتطلب تحليل البيانات التي جُمعت حول استخدام السيارة باستخدام أداة Orange Data Mining، وتطبيق خوارزمية شجرة القرار (Decision Tree) لتحديد نوع السيارة المناسب (بنزين، كهرباء، هايبيرد) بناءً على طبيعة الاستخدام. وسيُقيَّمُ أيضًا أداء النموذج باستخدام مقاييس الدقة باتباع الخطوات الآتية:
- أنظمُ البيانات التي جُمعت في المهمة الأولى في جدول بيانات (Excel) وأحفظه بصيغة (.csv)، وأتأكد من أن كل خاصية لها صلة بالاستخدام، مثل عدد الكيلومترات المقطوعة، ونوع الوقود المفضل. إن نوع الاستخدام (طبيعة الرحلة أو المسافة)، ونوع الطريق المستخدم (طرق سريعة، مدن، تضاريس وعرة)، وتكلفة التشغيل وتكلفة الصيانة التقريبية، وتفضيلات المستخدم تكون موجودة ومنظمة بشكل صحيح.
- أُشغّلُ برنامج (Orange Data Mining) وأستردُّ البيانات من ملف (Excel) الذي أُنشئ. أبدأ بربط أيقونة الملف (File) في (Orange Data Mining) مع بيانات (Excel).
- استعرض البيانات في (Orange Data Mining) وأتأكد من أن جميع القيم والميزات قد أُدخلت على نحو صحيح.
- اختارُ أيقونة (Decision Tree) ضمن الأدوات في (Orange Data Mining).
- أتأكد من تحديد المتغير المستهدف (الوسم) وهو نوع السيارة المناسب (بنزين، كهرباء، هايبيرد) بناءً على طبيعة الاستخدام.
- أربط البيانات بالخوارزمية وأشغل تدريب شجرة القرار على البيانات.
- بعد تدريب النموذج، أستخدمُ أيقونة (Test & Score) لتقييم أداء النموذج عن طريق مقاييس، مثل الدقة (Accuracy).
- أستعرضُ النتائج لتحديد دقة النموذج في اختيار نوع السيارة المناسب بناءً على طبيعة الاستخدام.
- بعد الانتهاء من التدريب والتحليل، أعدُّ تقريرًا يتضمن:
النتائج: مثل نسبة الدقة، والبيانات التي أثرت بشكل أكبر في نوع السيارة المختار. التحديات: أي صعوبات واجهتها في أثناء التطبيق، مثل معالجة القيم المفقودة أو ترتيب البيانات. الحلول: كيف تم التغلّب على هذه التحديات مثل إعادة صياغة البيانات أو تعديل إعدادات الخوارزمية. أشارك التقرير الذي أعددناه كمجموعة مع المجموعات الأخرى عن طريق اللوح الرَّقمي التفاعلي والمجموعة الرَّقميّة الخاصة بالصف. أناقش مع زملائي التحديات التي واجهتها وأي تحسينات ممكنة للنموذج.
أقيّم تعلّمي
المعرفة: أوظف في هذا الدرس ما تعلّمته من معارف في الإجابة عن السؤال الآتي: السؤال الأول: أعرّف تعلّم الآلة، وأوضّح كيف يمكن أن نعرف أن نموذجاً معيّناً قد تعلّم بشكل جيد. السؤال الثاني: ما الفرق بين نماذج التصنيف ونماذج الانحدار في التعلّم الآلي؟ السؤال الثالث: أوضح أهمية اكتشاف القيم المتطرفة أو الشاذة في البيانات وأثر ذلك في أنظمة التعلّم الآلي.
المهارات: أوظف مهارات التفكير الناقد والتواصل الرَّقمي والبحث الرَّقمي في الإجابة عن الأسئلة الآتية: السؤال الأول: أبين الفرق بين الأنظمة الخبيرة وأنظمة تعلّم الآلة من حيث: التعريف، والمتطلبات، والقدرة على التعامل مع المعرفة المتغيرة. السؤال الثاني: لماذا تعدُّ البيانات الضخمة عالية الجودة مهمة لبناء نموذج تعلّم الآلة؟ أفسر إجابتي. السؤال الثالث: أبين خطوات بناء نموذج آلي للتنبؤ بمرض السكري. (يمكن الاستعانة ببرامج الذكاء الاصطناعي).
القيم والاتجاهات
أصمّم مع زملائي "بوسترًا" يبين الجوانب الأخلاقية المتعلقة بأنظمة التعلّم الآلي باستخدام أحد برامج الذكاء الاصطناعي، وأنشره على الموقع الإلكتروني للمدرسة، ثم أطبعه وأعلّقه في أحد أروقة المدرسة.