شرح الدرس
الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
تطوير حل الذكاء الاصطناعي لتلبية احتياجات محددة
الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
تطوير حل الذكاء الاصطناعي لتلبية احتياجات محددة
بعد التخطيط والإعداد لإنشاء حل للذكاء الاصطناعي، يقدم لك هذا الموضوع الإجراءات اللازمة للمضي قدمًا بالخطة وتطوير الحل رسميًا. في هذا الجزء، ستستكشف مجموعة من الخوارزميات المكتوبة بلغة بايثون.
ج1 نماذج الذكاء الاصطناعي
- نقطة البداية في النقاش حول تطوير حلول الذكاء الاصطناعي هي مفهوم نموذج الذكاء الاصطناعي.
- يتم إنشاء نموذج الذكاء الاصطناعي من خلال عملية تسمى التعلم الآلي (ML).
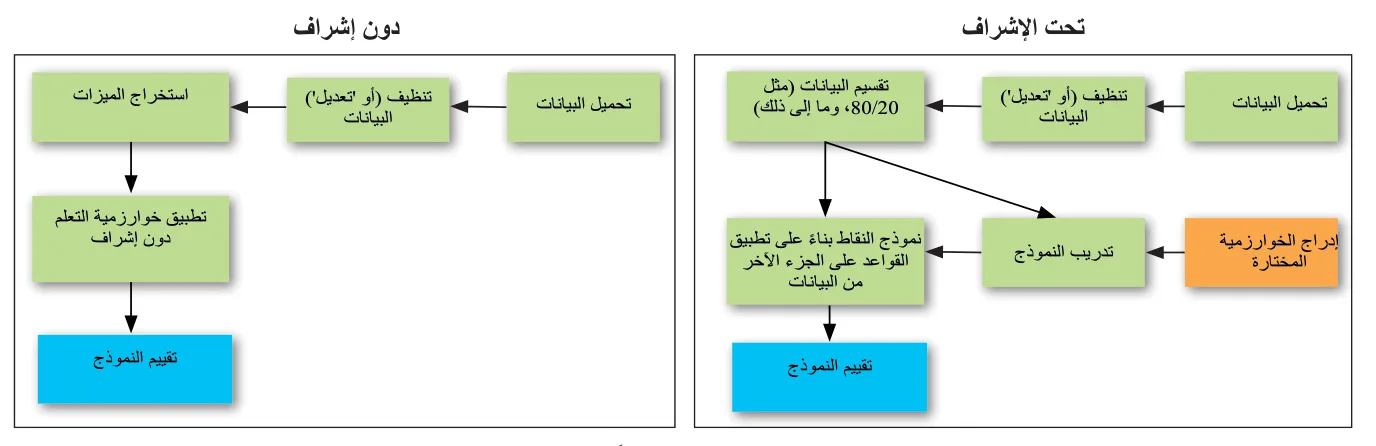
- هناك طريقتان مختلفتان: التعلم تحت الإشراف والتعلم الآلي دون إشراف.
التعلم تحت الإشراف
- في التعلم الآلي تحت الإشراف، يتم اختيار خوارزمية مناسبة لحل المشكلة المطروحة ويستخدم جزء من البيانات المتاحة (عادة 80 في المائة، ولكن يمكن أن يختلف) لتدريبها.
- بمجرد تدريب النموذج بشكل مناسب، يجب اختباره قبل استخدامه.
- وعادة ما ينطوي ذلك على استخدام نسبة 20 في المائة المتبقية من البيانات وتقييم النتيجة (على سبيل المثال، تقييم الدقة الإجمالية للتنبؤات).
التعلم دون إشراف
في المقابل، يعتمد التعلم الآلي دون إشراف على تطبيق الخوارزميات (مثل التجميع أو تقليل الأبعاد) للكشف عن الأنماط أو الهياكل أو العلاقات المخفية في البيانات. يقارن الشكل 21.23 العمليات المعممة لكل من التعلم تحت الإشراف ودون إشراف، وكلاهما يبدأ بتحميل البيانات، وكلاهما ينتهي بتقييم النموذج الذي تم إنشاؤه، لكن تختلف طريقة تقدمهم قليلاً.
المصطلحات الرئيسية
خوارزمية التجميع - تستخدم لتحديد ما إذا كان هناك أي مجموعات في مجموعة البيانات. خوارزمية تقليل الأبعاد - تُستخدم لتقليل عدد الميزات في مجموعة البيانات دون المساس بخصائص البيانات الأصلية. معاملات الضبط - قيم إضافية ليست جزءًا من مجموعة البيانات نفسها لكن يمكن تكوينها وستغير طريقة عمل عملية التعلم الآلي.
- قد لا تؤدي المحاولات الأولية لإنشاء نموذج ذكاء اصطناعي من خلال عملية التعلم الآلي إلى تنبؤات شديدة الدقة.
- إذا كانت هذه هي الحالة، سيحتاج عالم البيانات إلى تعديل عملية التعلم عن طريق تعديل اختيار ميزات النموذج أو الأوزان، أو عن طريق تغيير معاملات الضبط التي تتحكم في الخوارزمية نفسها.
- بمجرد القيام بذلك، يمكنه تشغيل عملية التدريب مرة أخرى، على أمل أن تكون النتائج أفضل.
247 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
الميزات الرئيسية - الميزات المحددة الشائعة في العديد من المثيلات من نوع الكائن نفسه. الدقة العامة - مقياس يصف فعالية النموذج بشكل عام عند التنبؤ بالبيانات أو الاختبار، فإذا خضع أحد النماذج للتدريب على اكتشاف البريد الإلكتروني العشوائي وتمكن من تحديد 45 رسالة من أصل 50 رسالة بريد إلكتروني بوصفها محتوى غير مرغوب فيه بشكل صحيح، فستكون دقته العامة 90 في المائة (وهي في الواقع منخفضة بعض الشيء).
لمساعدتك على الفهم، عليك مراعاة السيناريو الآتي؛ تخيل أنك عالم بيانات، وقد جمعت الكثير من الصور وحددت الميزات الرئيسية التي ستعتبرها مؤشرًا بصريًا للقطط:
- شكل عيونها
- وجود شوارب
- شكل آذانها
- وجود فراء
- نسيج الفراء الخاص بها.
يمكنك تعرف هذه الميزات بوضوح من الصور التي حددتها. تمثل هذه الصور (والميزات الرئيسية التي تحتوي عليها) بيانات التدريب. هدفك هو استخدامها لإنشاء نظام ذكاء اصطناعي يمكنه تصنيف الصورة بشكل صحيح (أو لا). أنت تختار الخوارزمية الخاصة بك ونهج تعلم الآلة الخاص بك. قد تتضمن المعلمات الفائقة لنظام تعلم الآلة الخاص بك:
- مدى سرعة تعلم الخوارزمية (معدل التعلم)
- عدد الصور التي تغذي الخوارزمية دفعة واحدة (حجم الدفعة).
ستشغل عملية التعلم الآلي الخاصة بك وستحصل على نتيجة أولية. ستبدأ بعد ذلك في تعديل الميزات المحددة والمعايير الفائقة المستخدمة، ما يترتب عليه إمكانية تحسن الدقة العامة لتوقعات نموذج الذكاء الاصطناعي الخاص بك (ومن الوارد أن تتدهور)، وستواصل إجراء المزيد من التجارب حتى تصل إلى أفضل تركيبة. بمجرد أن يتم تدريب النموذج الخاص بك بنجاح، يمكنك عرض صور جديدة عليه عما إذا كانت الصورة تحتوي على قطة (أم لا). من الناحية النظرية، إذا كان معدل الدقة العامة للنموذج مرتفعًا، فيجب أن يكون قادرًا على الإجابة على السؤال بنجاح.
لا يمكن للذكاء الاصطناعي الإجابة على كل سؤال. ومع ذلك، يمكن تدريب الذكاء الاصطناعي (وعملية التعلم الآلي الأساسية) بنجاح للإجابة بسرعة عن العديد من الأسئلة التي ستستغرق من الإنسان وقتًا وجهدًا كبيرين. نوع السؤال سيحدد أنواع نماذج الذكاء الاصطناعي التي تريد إنشاؤها. مفتاح ذلك هو فهم الأنواع المختلفة من الخوارزميات التي يمكن استخدامها لإنشاء أنواع مختلفة من النماذج. يستكشف هذا الجزء الأنواع الأكثر شيوعًا. يرد في ما يأتي بعض الأمثلة على الأسئلة التي يمكن تدريب الذكاء الاصطناعي على الإجابة عنها.
- هل يحتوي هذا الملف على فيروس يمكن تعرفه؟
- ما لوحة تسجيل هذه السيارة المسرعة؟
- متى يجب أن أستثمر في الأسهم والحصص في النشاط التجاري X؟
- إذا استثمرت 1000 دولار الآن، فما العائد المحتمل على استثماري في غضون خمس سنوات؟
للإجابة عن هذه الأسئلة باستخدام الذكاء الاصطناعي، يجب عليك تحديد:
- نوع المشكلة، وسيترتب عليه تحديد الخوارزمية التي سيتم استخدامها.
- نوع تقنية (تقنيات) التعلم التي يجب استخدامها.
تصنيف النموذج بحسب الإدخال
يمكنك تصنيف النموذج المطلوب بناءً على مدخلاته، حيث يحدد ذلك طريقة تعلمه. يمكن عادة تحقيق ذلك باستخدام التعلم تحت الإشراف أو التعلم دون إشراف (كما هو موضح أعلاه). يسلط الجدول 21.8 الضوء على الخصائص الرئيسية لهذين النهجين.
248 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
الجدول 21.8 التعلم تحت الإشراف مقارنةً بالتعلم دون إشراف، يقارن النهجين والخصائص الرئيسية في كل حالة
| التعلم تحت الإشراف | التعلم دون إشراف |
|---|---|
| • مدخلات بيانات التدريب معنونة يدويًا | • مدخلات البيانات غير معنونة |
| • مقترن بمخرجات متطابقة | • يتم تحديد الأنماط داخل مدخلات البيانات |
| • يمكن أن يكون مستهلكًا للوقت ومكلفًا | • الهدف هو تحديد الأنماط أو الهياكل المخفية في البيانات؛ واكتشاف أوجه التشابه والاتجاهات وما إلى ذلك. |
| • الهدف هو التنبؤ بمخرجات البيانات غير الموجودة في مجموعة التدريب الخاصة بها من خلال علاقات التعلم بين المدخلات والمخرجات. | • أقل تكلفة مع انخفاض التفاعل البشري |
| • تشمل الخوارزميات الكلاسيكية التصنيف والانحدار | • تشمل الخوارزميات الكلاسيكية التجميع وتقليل الأبعاد |
| • التطبيقات الشائعة: تصفية البريد الإلكتروني أو تعرف الصور أو الصوت وما إلى ذلك. | • التطبيقات الشائعة: تحليل السوق واكتشاف الحالات الشاذة وما إلى ذلك. |
خوارزمية الانحدار - تعثر هذه الخوارزمية على أفضل خط أو منحنى لملاءمة نقاط البيانات باستخدام ثلاثة مقاييس رئيسية (التباين، والخطأ، والتحيز). خوارزمية التصنيف - هي خوارزمية تقيم وزن خصائص البيانات المختلفة بناءً على أهميتها للنتائج المطلوبة.
يؤثر نوع البيانات وطبيعة النتيجة التي تحاول تحقيقها مع مشروعك للذكاء الاصطناعي في نوع خوارزمية التعلم الآلي المستخدمة في النموذج. في بعض الأحيان يكون هذا الأمر اختيارًا سهلاً، فعلى سبيل المثال، إذا كنت تجري تنبؤًا بسيطًا (لديك فئة متغير مستقل وتريد التنبؤ بمتغير تابع)، فقد يُحل هذا الأمر باستخدام خوارزمية الانحدار الخطي (على سبيل المثال، إذا أدخلت القيمة 'x'، فستتنبأ بالقيمة 'y'). في مواقف أخرى، ليس من السهل دومًا فهم خوارزمية تعلم الآلة التي ستزيد استخدامها بناءً على البيانات المتاحة التي ترغب في إدخالها، فعلى سبيل المثال، قد تحين أوقات يكون فيها استخدام المصنف (خوارزمية التصنيف) أكثر ملاءمة من استخدام تقنيات التجميع (خوارزمية التجميع). يعتمد النهج الأفضل إلى حد كبير على ما إذا كنت تستخدم بيانات منظمة أو غير منظمة، أو تفكر في تقنيات التعلم تحت الإشراف أو دون إشراف. لمعرفة أمثلة محددة عن كيفية تأثير المدخلات المختلفة في اختيار خوارزمية التعلم الآلي لاستخدامها في النموذج، راجع أمثلة الأكواد في هذا الجزء. والتي توضح ميزات مجموعات البيانات التي تم استخدامها كخوارزميات التعلم الآلي المرتبطة التي قامت بمعالجتها لإنشاء نموذج عملي. يجب أن تلاحظ أن الأمور نادرًا ما تنجح في المرة الأولى عند بناء مشاريع الذكاء الاصطناعي وقد تحتاج إلى إعادة المحاولة لعدة مرات قبل تحقيق مستويات دقة مرضية.
تصنيف النموذج بحسب المخرجات المطلوبة
من الممكن أيضًا تصنيف النموذج بحسب نوع المخرجات التي يُطلب من الذكاء الاصطناعي توليدها. تشمل أنواع المخرجات:
- الرقم - يتم تحقيق ذلك باستخدام خوارزمية الانحدار
- الفئة - يتم تحقيق ذلك باستخدام خوارزمية التصنيف
- باقة من المجموعات - يتم تحقيق ذلك باستخدام خوارزمية التجميع
- الميزات الرئيسية في البيانات المعقدة - يتحقق ذلك باستخدام تقليل الأبعاد (أي باستخدام خوارزمية تقليل الأبعاد).
ستدرس في الجزء الآتي كلاً منها بمزيد من التفصيل.
الانحدار الخطي
قد تكون على دراية بالانحدار الخطي والمعادلة: وذلك عندما:
- x متغير مستقل يمثل المدخلات
- y يمثل المخرجات المتوقعة، وهو متغير تابع
- m يمثل ميل خط الانحدار
- c يمثل نقطة تقاطع المحور y لخط الانحدار (ببساطة، قيمة y عندما تكون x تساوي 0).
على سبيل المثال، رسم يعطي الرسم البياني في الشكل 21.24.
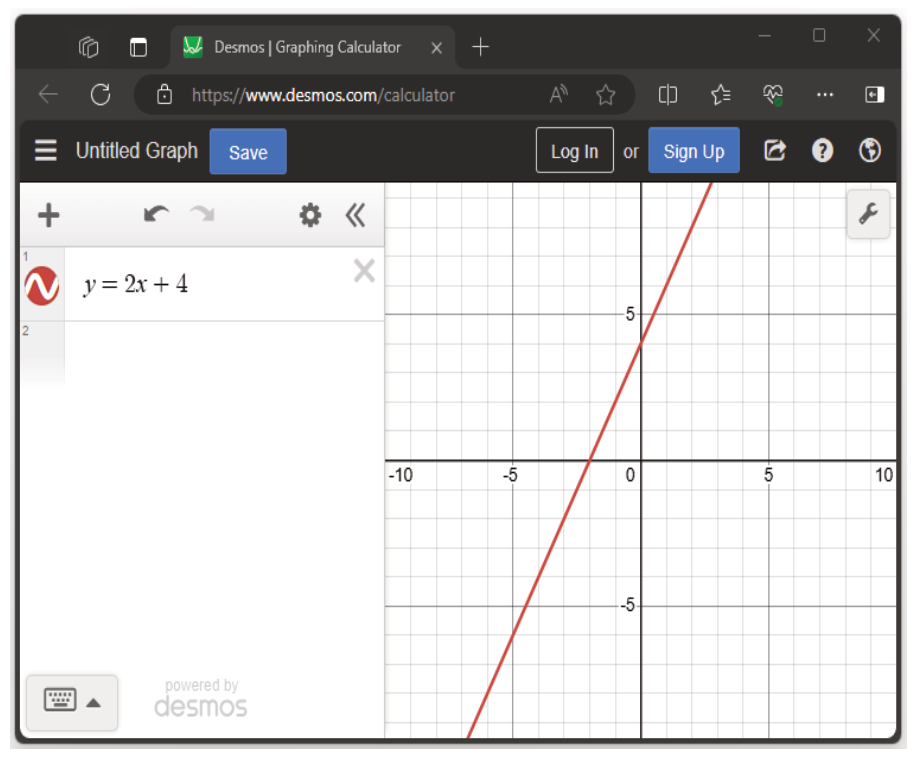
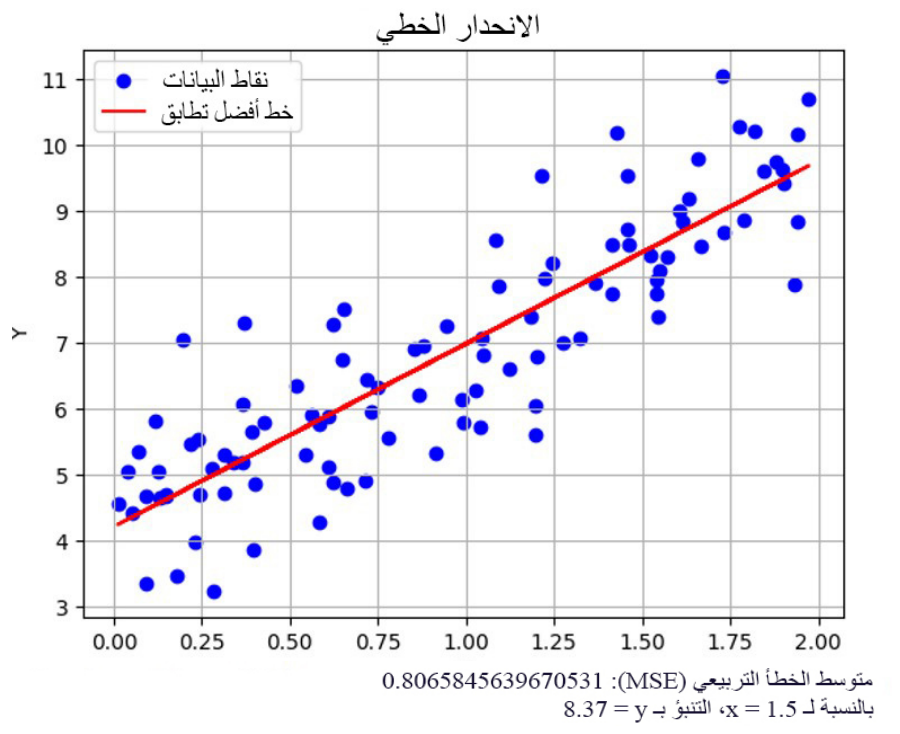
باستخدام هذه التقنية، يجب أن يكون من الممكن أخذ أي قيمة للمحور x والعثور على قيمتها التابعة (المتوقعة) للمحور y. يمكن تحقيق ذلك بصريًا عن طريق رسم خط عمودي من القيمة المختارة على المحور x والتوقف عند مواجهة التدرج ثم رسم خط أفقي من تلك النقطة إلى المحور y وقراءة القيمة الناتجة. في الذكاء الاصطناعي، يمكنك استخدام التعلم الآلي لرسم الخط الأنسب من البيانات المحددة، بدلاً من استخدام معادلة بسيطة. يتم ذلك عن طريق تقليل دالة الخسارة، عادةً متوسط الخطأ التربيعي (MSE). بشكل عام، يشير متوسط الخطأ التربيعي إلى أداء أفضل للنموذج، على الرغم من أن الرقم الدقيق يختلف بناءً على عوامل مختلفة (على سبيل المثال، طبيعة البيانات، معرفتك الأساسية بالبيانات في هذا المجال، وما إلى ذلك). في الشكل 21.25، يمكنك رؤية هذا مطبقًا في بايثون باستخدام مكتبة scikit-learn ومجموعة بيانات تركيبية.
المصطلح الرئيسي
متوسط الخطأ التربيعي (MSE) - يقيس متوسط الفرق التربيعي بين القيم المتوقعة والقيم الفعلية.
250 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
```python import numpy as np import matplotlib.pyplot as plt from sklearn.linearmodel import LinearRegression from sklearn.metrics import meansquared_error
Generate synthetic data
np.random.seed(42) X = 2 np.random.rand(100, 1) # Generate 100 random values between 0 and 2 y = 4 + 3 X + np.random.randn(100, 1) # y = 4 + 3x + random noise
Train linear regression model
lrmodel = LinearRegression() lrmodel.fit(X, y)
Plot the data points
plt.scatter(X, y, color='blue', label='Data Points')
Plot the best-fit line
plt.plot(X, lr_model.predict(X), color='red', label='Best-Fit Line')
Plot settings
plt.xlabel('X') plt.ylabel('Y') plt.title('Linear Regression') plt.legend() plt.grid(True) plt.show()
Calculate Mean Squared Error (MSE)
ypred = lrmodel.predict(X) mse = meansquarederror(y, y_pred) print(f'Mean Squared Error (MSE): {mse}')
Test of x to find y
testx = 1.5 # Test x value testy = lrmodel.predict([[testx]]) # Predict corresponding y value print(f'For x = {testx}, predicted y = {testy[0][0]:.2f}') ```
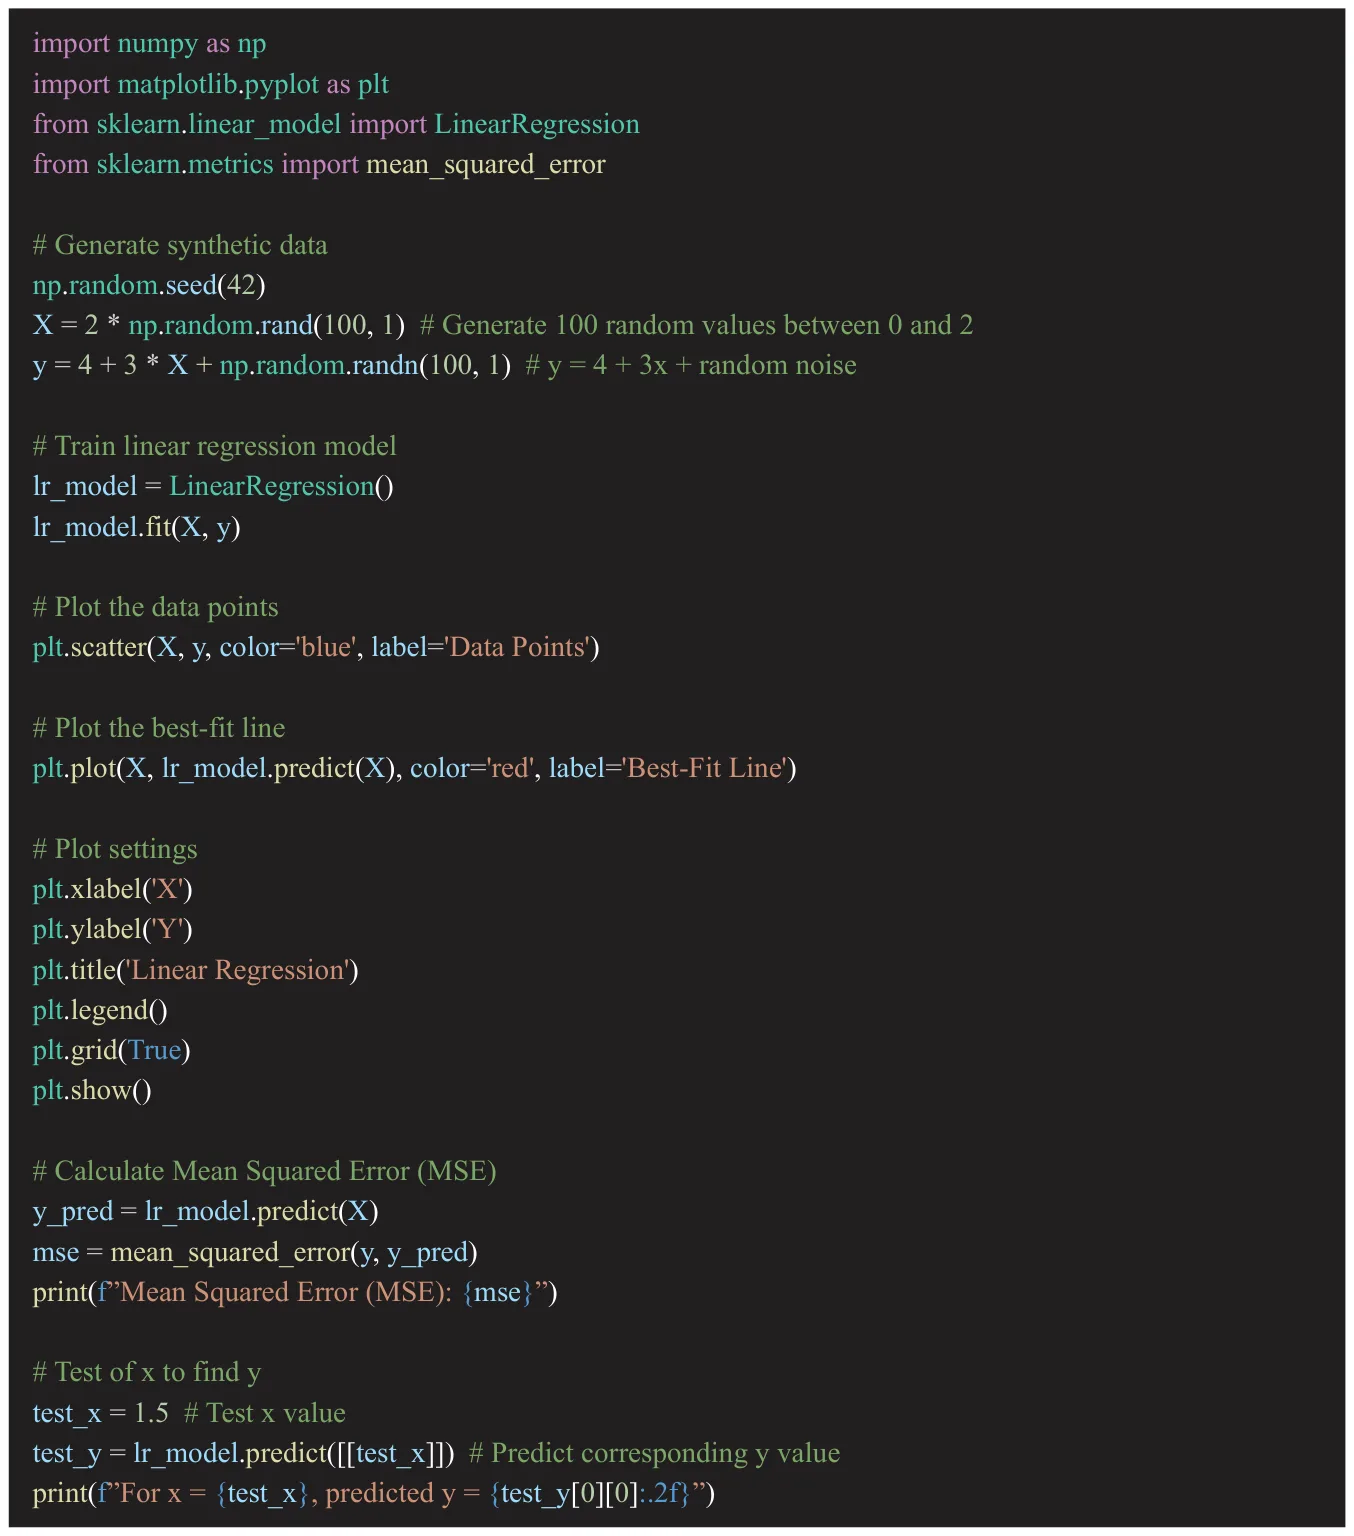
كما ترى، من أجل كتابة هذا البرنامج النصي، كان من الضروري تضمين وحدات معينة في الجزء العلوي من نص بايثون (على سبيل المثال، numpy وmatplotlib وsklearn). في بعض الأحيان تكون الوحدات التي تقوم بتضمينها جزءًا من مكتبة بايثون القياسية وسيتم تثبيتها بالفعل على جهاز الحاسب الخاص بك. في حالات أخرى، تكون هذه مكتبات تابعة لجهات خارجية (أي لم يتم إنشاؤها بواسطة مصممي بايثون) ويجب تثبيتها بشكل منفصل. عادةً ما يتم تحقيق ذلك في بايثون باستخدام أداة 'pip'، التي تقوم بتنزيل الحزم من فهرس حزم بايثون المعتمد (pypi.org).
251 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
إذا حاولت تشغيل برنامج بايثون النصي الذي لا يتضمن الوحدات الصحيحة وما إلى ذلك، فمن المحتمل أن يحدث خطأ، على سبيل المثال:
``python Traceback (most recent call last): File "<pyshell#0>", line 1, in <module> mean([1, 2, 4]) NameError: name 'mean' is not defined ``
ستحتاج إلى تحديد الوحدة المفقودة، (ربما) تثبيتها، ثم تضمين سطر (في الجزء العلوي من البرنامج النصي الخاص بك) لاستخدامها. كما ترى، سيؤدي ذلك إلى حل المشكلة.
من متوسط الإحصاءات الواردة
المتوسط [1، 2، 4]
2.3333333333333335
يظهر المخرج الناتج في الشكل 21.26.
كما ترى، تم تدريب النموذج ورسم الخط الأفضل ملاءمة واختباره باستخدام قيمة عينة للمحور x، ما أدى إلى توليد قيمة تنبؤية للمحور y. يجب أن تكون قادرًا على التحقق من ذلك تقريبًا من خلال العمل من المحور x (للمحور x المستقل) إلى الخط الأكثر ملاءمة ثم عبر المحور y (للمحور y التابع). تستخدم نماذج الانحدار الخطي عادةً للإجابة عن الأسئلة المستندة إلى الأرقام، كما يأتي:
- إذا استثمرت X دولار، فماذا سيكون عائدي المالي في غضون 10 سنوات؟
- إذا اشتريت منزلاً مقابل X دولار، فما قيمته المحتملة في غضون 20 عامًا؟
- إذا خصصت 5 في المائة من راتبي الإجمالي للحصول على معاش شخصي، فما القيمة المحتملة عندما أتقاعد في غضون X سنوات؟
252 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
الانحدار اللوجستي
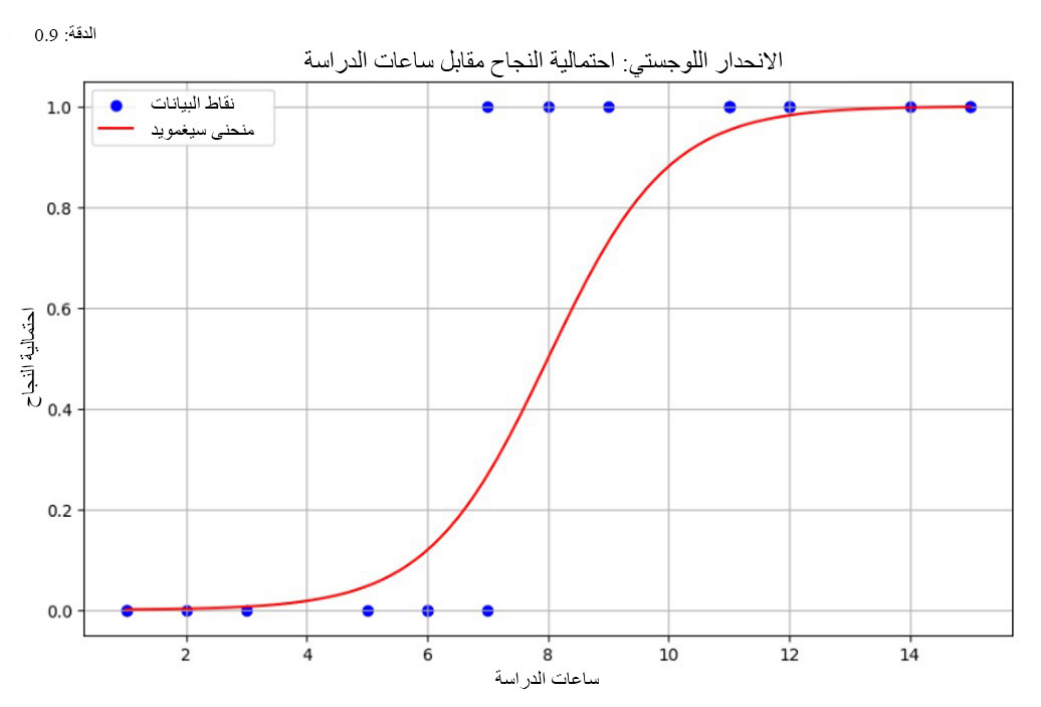
في بعض الأحيان، لا يكون تحديد علاقة خطية بين x وy هو أفضل نهج دائمًا. على سبيل المثال، تخيل أنك تفترض أن هناك علاقة مباشرة بين عدد الساعات التي تخطط للدراسة والعلامة المئوية التي ستحصل عليها للاختبار. يمكنك بالتأكيد تدريب تلك البيانات، ورسم نقاط البيانات المتناثرة، ورسم خط أفضل ملاءمة ومحاولة استخدامه بوصفه تنبؤًا. لكنها تفترض أن النتيجة ستزداد مع كل ساعة إضافية من الدراسة - وهو أمر قد لا يكون صحيحًا في الواقع. قد يتخذ الانحدار اللوجستي نهجًا مختلفًا قليلاً، فسيسألك عما إذا كنت أكثر عرضة للنجاح أو الفشل، بناءً على ساعات الدراسة والنتائج الناتجة. هذا الخط المنحني سيساعدك ببساطة على فهم احتمال النجاح أو الفشل. تقع هذه الاحتمالية في مكان ما بين 0 (أقل احتمالاً) و1 (أكثر احتمالاً). هذا يعني أن الانحدار اللوجستي هو انحدار فئوي (أي، يحدد الفئات 'نجح' أو 'فشل') بدلاً من تقديم قيمة مستمرة (مثل نسبة التنبؤ) كما يفعل الانحدار الخطي. يضرب الشكل 21.27 مثالاً باستخدام بايثون لإظهار هذا النموذج في العمل. يظهر مخطط الدقة والتصنيف الناتج في الشكل 21.28.
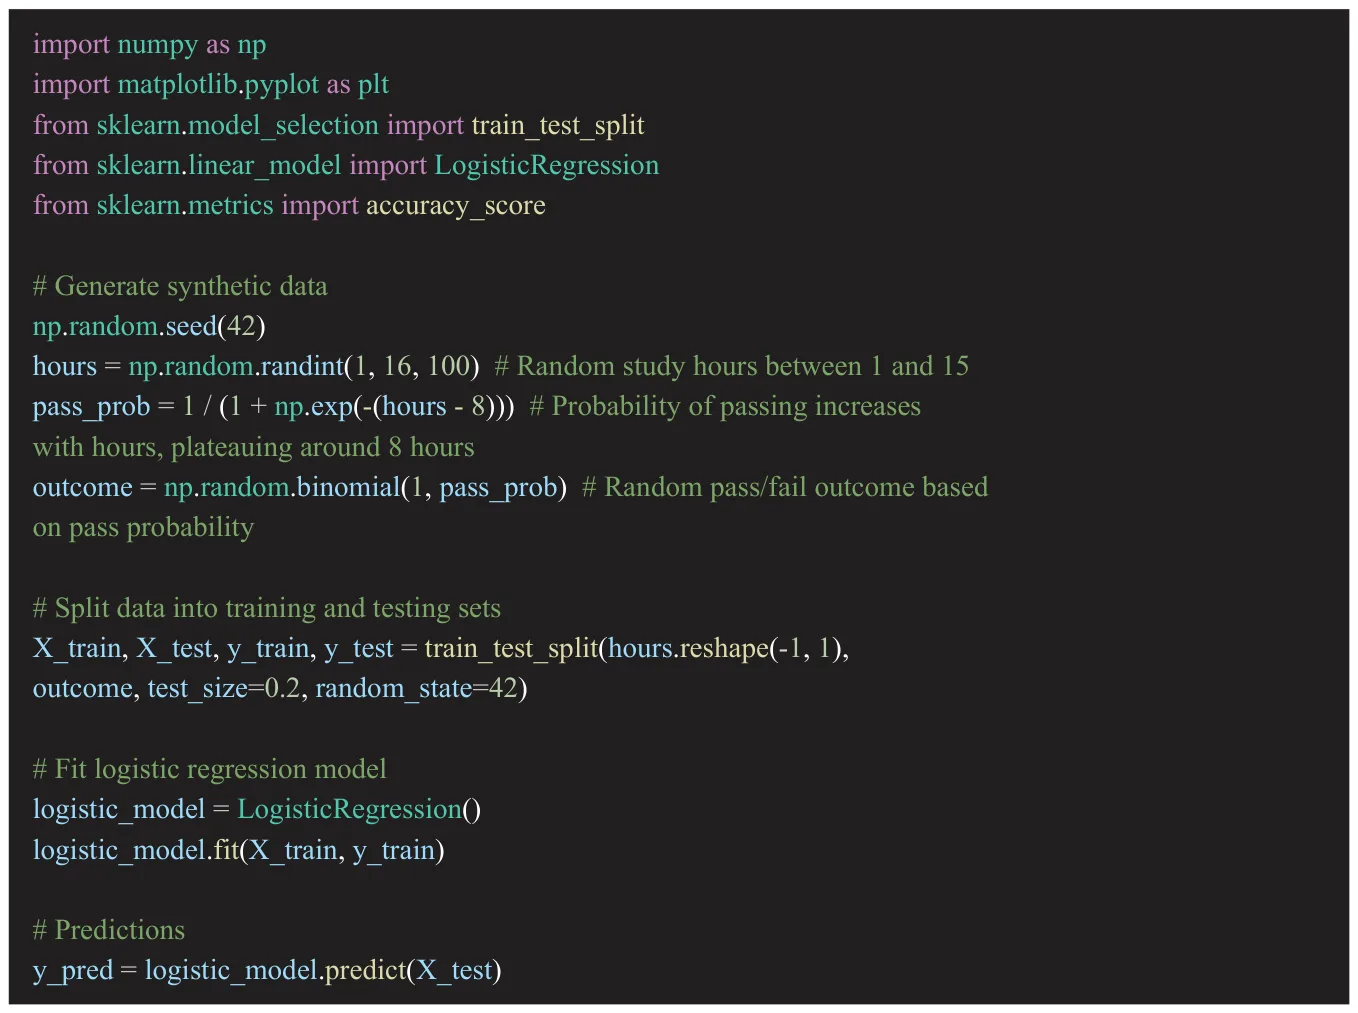
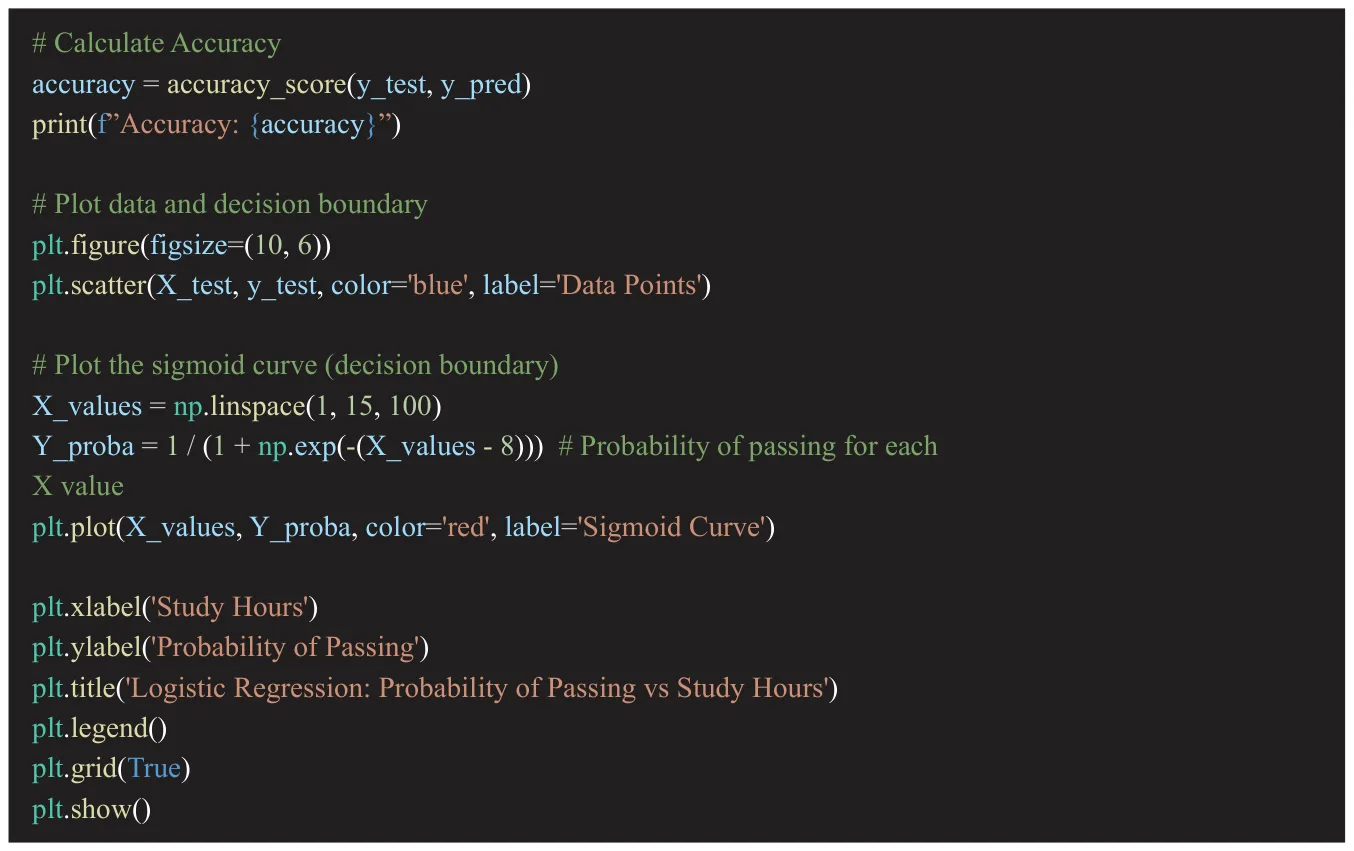
```python import numpy as np import matplotlib.pyplot as plt from sklearn.modelselection import traintestsplit from sklearn.linearmodel import LogisticRegression from sklearn.metrics import accuracy_score
Generate synthetic data
np.random.seed(42) hours = np.random.randint(1, 16, 100) # Random study hours between 1 and 15 passprob = 1 / (1 + np.exp(-(hours - 8))) # Probability of passing increases with hours, plateauing around 8 hours outcome = np.random.binomial(1, passprob) # Random pass/fail outcome based on pass probability
Split data into training and testing sets
Xtrain, Xtest, ytrain, ytest = traintestsplit(hours.reshape(-1, 1), outcome, testsize=0.2, randomstate=42)
Fit logistic regression model
logisticmodel = LogisticRegression() logisticmodel.fit(Xtrain, ytrain)
Predictions
ypred = logisticmodel.predict(X_test) ```
الشكل 21.27 (متابعة)
253 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
```python
Calculate Accuracy
accuracy = accuracyscore(ytest, y_pred) print(f'Accuracy: {accuracy}')
Plot data and decision boundary
plt.figure(figsize=(10, 6)) plt.scatter(Xtest, ytest, color='blue', label='Data Points')
Plot the sigmoid curve (decision boundary)
Xvalues = np.linspace(1, 15, 100) Yproba = 1 / (1 + np.exp(-(Xvalues - 8))) # Probability of passing for each X value plt.plot(Xvalues, Y_proba, color='red', label='Sigmoid Curve')
plt.xlabel('Study Hours') plt.ylabel('Probability of Passing') plt.title('Logistic Regression: Probability of Passing vs Study Hours') plt.legend() plt.grid(True) plt.show() ```
الشكل 21.27 (متابعة) كود الانحدار في بايثون الذي يحسب احتمال اجتياز الامتحان مقابل عدد ساعات الدراسة.
254 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
- كما ترى، يصبح احتمال النجاح شبه مؤكد (1.0) عندما تصل إلى 12 ساعة من الدراسة للامتحان، ثم ينخفض.
- يتم رسم التحسين منحنى على شكل حرف S لتمثيل العلاقات في العالم الحقيقي (وقت الدراسة مقابل احتمال النجاح) الموضح هنا.
- ومع ذلك، من الممكن مرة أخرى البحث عن أي قيمة x (ساعات الدراسة) والتحقق من احتمالية النجاح، على الرغم من أنه يُرجى ملاحظة أن دقة النموذج تبلغ 90 في المائة فقط.
هذه تقنية قوية تستخدم في تحليل بيانات السلاسل الزمنية. يتم استخدامها للتنبؤ بالقيم المستقبلية بناءً على الملاحظات السابقة أو القيم (المتأخرة). ومع ذلك، يمثل اسمها الميزات الثلاث التي تجعلها تقنية شائعة - الانحدار الذاتي والمتكامل والمتوسط المتحرك (كما هو موضح في الجدول 21.9).
الجدول 21.9 مقارنة بين تقنيات AR (الانحدار الذاتي) وI (التكامل) وMA (المتوسط المتحرك)، مع توضيح ميزات كل منها.
| AR | I | MA |
|---|---|---|
| • = الانحدار الذاتي |
- نماذج العلاقة بين الملاحظة والقيمة السابقة
- يفترض أن القيمة تعتمد على قيمها السابقة | • = متكامل
- يستخدم تقنية تسمى التمييز
- يتضمن ذلك محاولة إزالة الاتجاهات والفترات من البيانات (والتي تسبب تقلبات)
- يهدف إلى جعل السلسلة أكثر ثباتًا وقابلية للتنبؤ
- يُستخدم مصطلح 'الثبات' لوصف هذا المعنى | • = المتوسط المتحرك
- تقنية تُستخدم "للتسوية"
- التقلبات أو الضوضاء في مجموعات البيانات من خلال تحديد الاتجاهات الأساسية
- تستخدم (نافذة) متحركة لنقاط البيانات
- بيانات جديدة تحل محل البيانات القديمة لمنع تأثر المتوسط بالقمم العليا والدنيا غير العادية، على سبيل المثال، تأثيرات موسمية مثل زيادة مبيعات الآيس كريم في الصيف |
مثال عملي
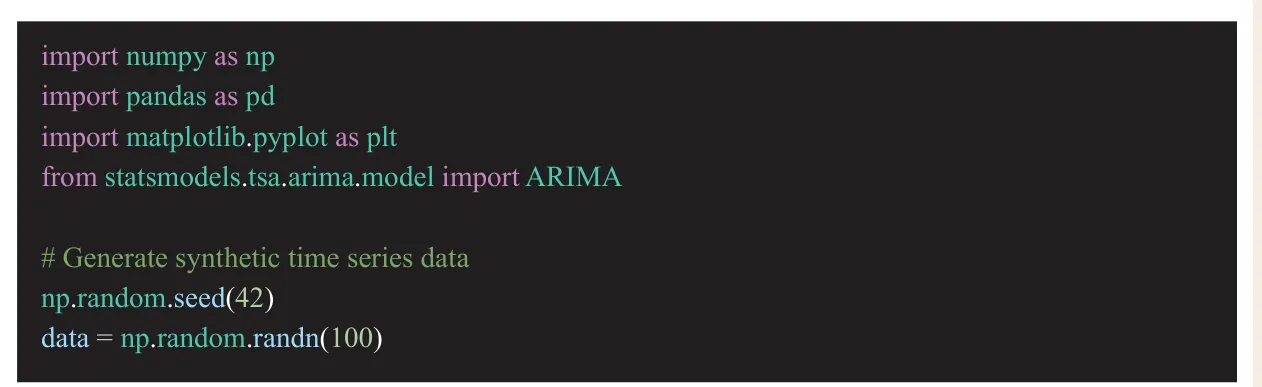
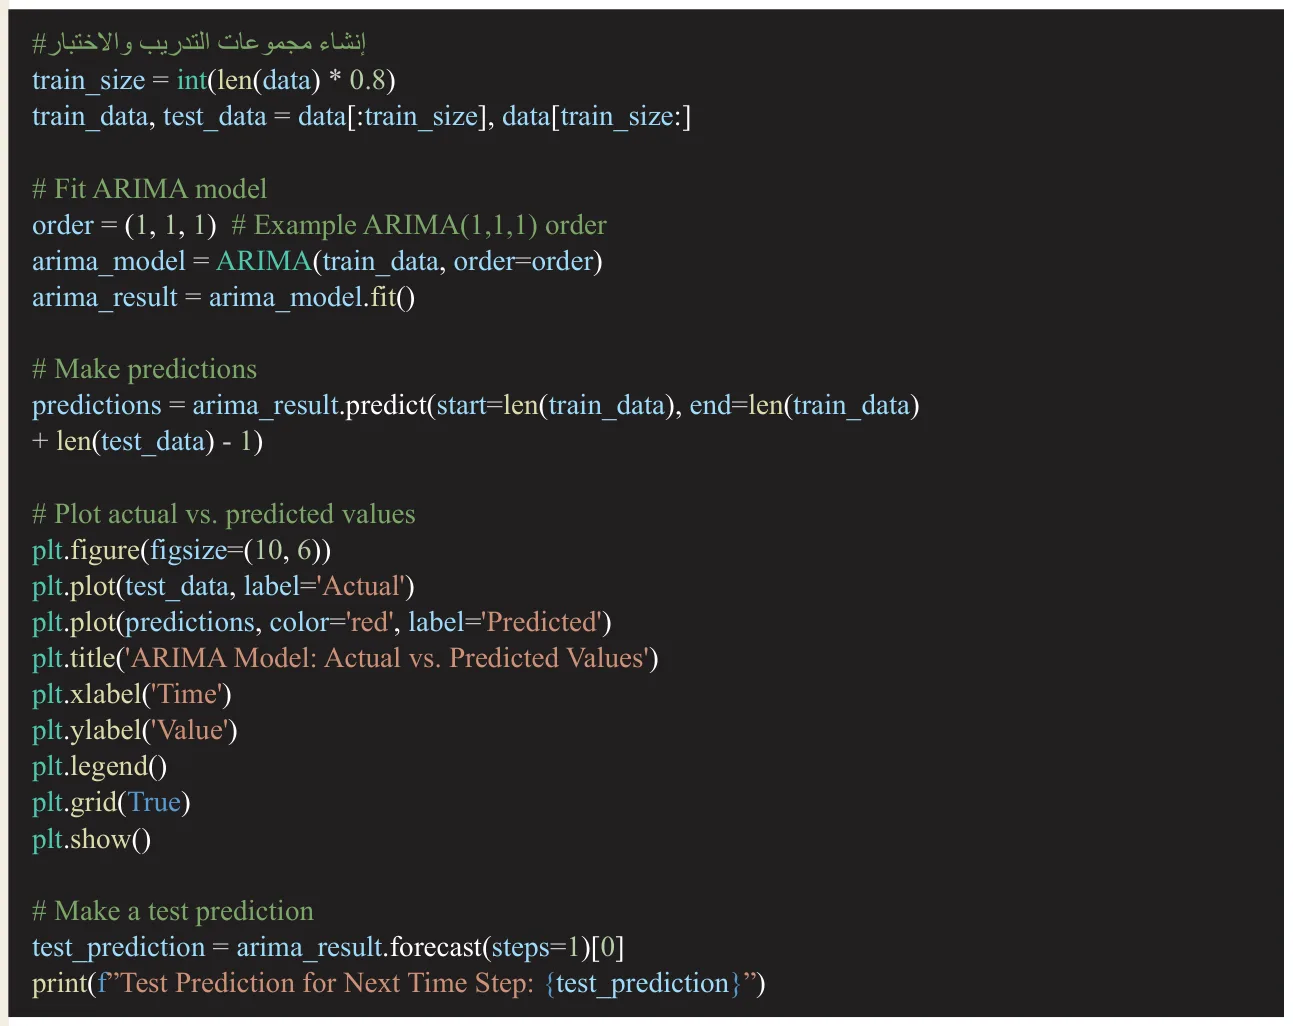
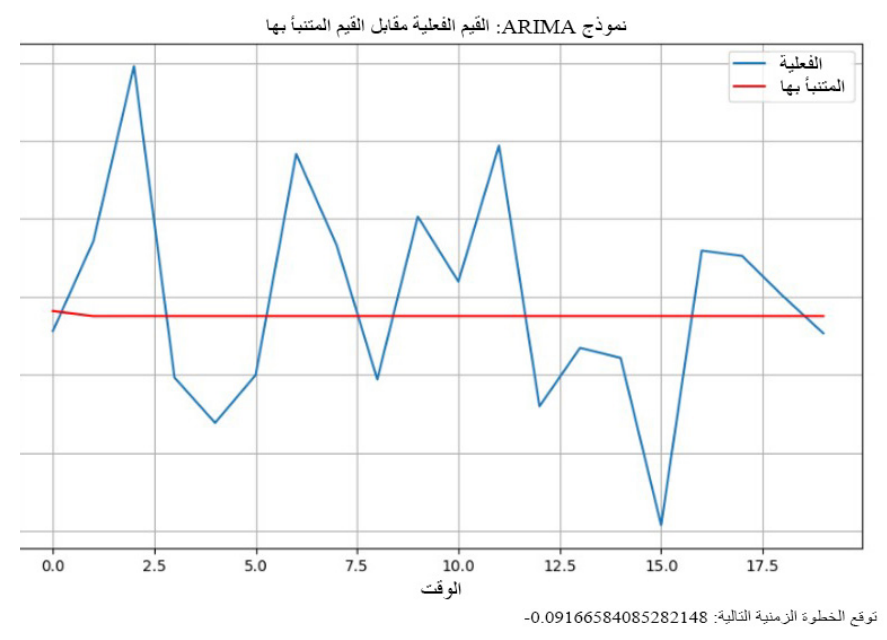
يُحاكي كود بايثون في الشكل 21.29 نموذج من نوع ARIMA باستخدام بعض البيانات الزمنية الاصطناعية. يظهر الإخراج الناتج في الشكل 21.30. يمكنك أن ترى تأثير التسوية الذي قلل التقلبات والضوضاء الموجودة في مجموعة البيانات.
```python import numpy as np import pandas as pd import matplotlib.pyplot as plt from statsmodels.tsa.arima.model import ARIMA
Generate synthetic time series data
np.random.seed(42) data = np.random.randn(100) ```
الشكل 21.29 (متابعة)
255 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
```python
إنشاء مجموعات التدريب والاختبار
trainsize = int(len(data) * 0.8) traindata, testdata = data[:trainsize], data[train_size:]
Fit ARIMA model
order = (1, 1, 1) # Example ARIMA(1,1,1) order arimamodel = ARIMA(traindata, order=order) arimaresult = arimamodel.fit()
Make predictions
predictions = arimaresult.predict(start=len(traindata), end=len(traindata) + len(testdata) - 1)
Plot actual vs. predicted values
plt.figure(figsize=(10, 6)) plt.plot(test_data, label='Actual') plt.plot(predictions, color='red', label='Predicted') plt.title('ARIMA Model: Actual vs. Predicted Values') plt.xlabel('Time') plt.ylabel('Value') plt.legend() plt.grid(True) plt.show()
Make a test prediction
testprediction = arimaresult.forecast(steps=1)[0] print(f'Test Prediction for Next Time Step: {test_prediction}') ```
الشكل 21.29 (متابعة) كود بايثون لمحاكاة نموذج من نوع ARIMA باستخدام بيانات سلسلة زمنية اصطناعية.
256 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
SVM (آلات المتجه الداعم)
SVM هو نموذج تعلم آلي قوي ومتعدد الاستخدامات للغاية. يمكنه إجراء تصنيفات خطية أو غير خطية لمجموعات البيانات المعقدة والصغيرة والمتوسطة الحجم.
المهارات
مهارات التواصل الشخصي: أخلاقيات العمل/الضمير:
- المسؤولية
- الإنتاجية
مثال عملي
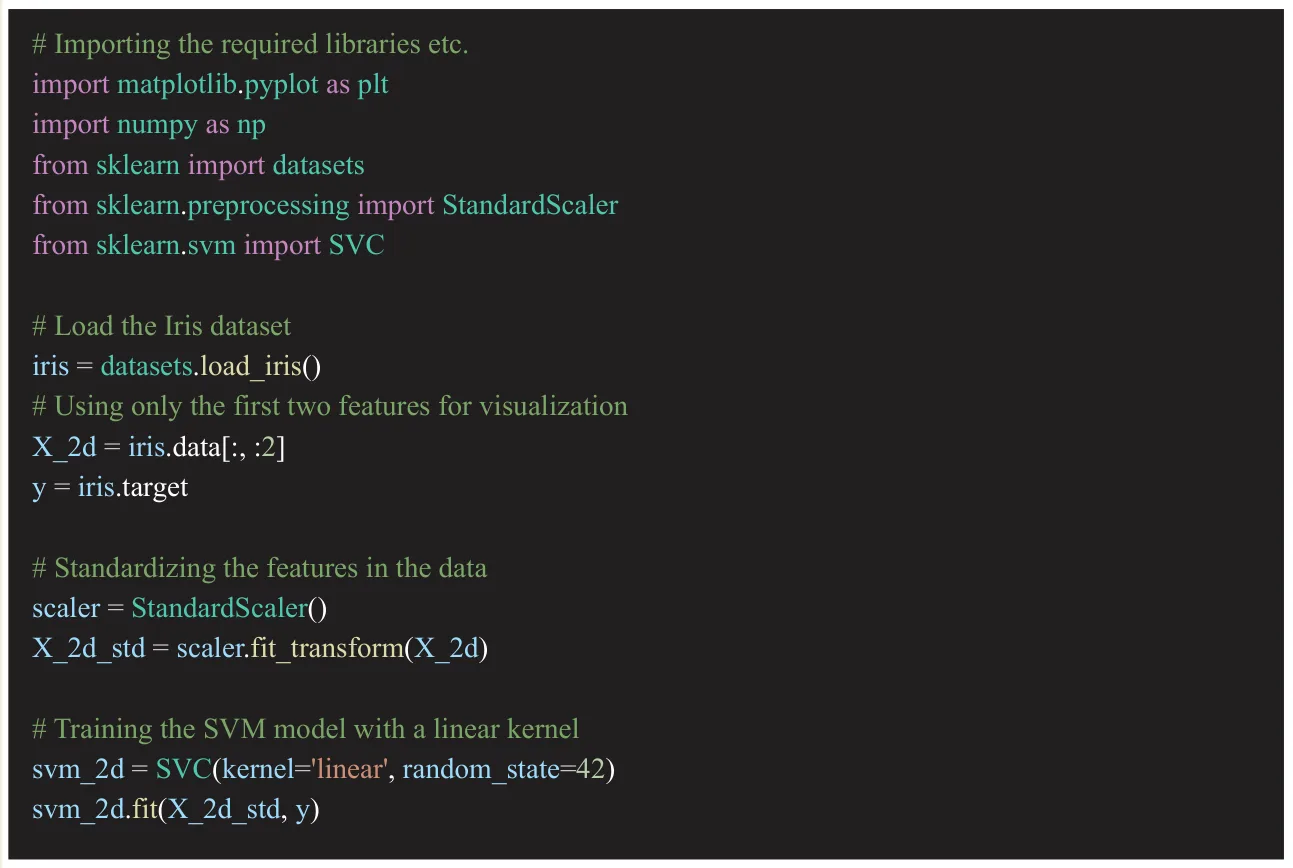
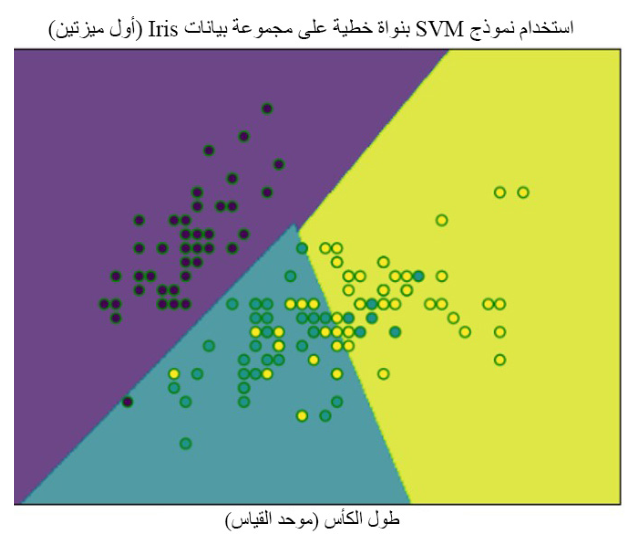
الكود البرمجي في الشكل 21.31 يحاكي آلة الدعم النقطية (SVM) باستخدام تصنيف المتجهات الداعمة (SVC) - نوع من آلات الدعم خصيصًا لمهام التصنيف في مكتبة scikit-learn. يستخدم الكود مجموعة بيانات Iris، وهي مورد شائع ومعروف جدًا في مجال علم البيانات وتعلم الآلة، وغالبًا ما يستخدمه الطلاب عند ممارسة مهاراتهم في مشكلات التصنيف وتصور البيانات. تحتوي مجموعة البيانات على قياسات محددة بالسنتيمتر لأربعة ميزات رئيسية لنباتات سيتوزا، وفيرسيكلور وفيرجينكا من فصيلة نيات السوسن:
- طول الكأس
- عرض الكأس
- طول البتلة
- عرض البتلة.
يمكن استخدام مزيج هذه الميزات (بشكل موثوق إلى حد ما) للتنبؤ بخصائص زهرة القزحية. يُرسم التصنيف الناتج في الشكل 21.32.
مشكلة التصنيف - هي مشكلة تقيس متوسط الفرق التربيعي بين القيم المتوقعة والفعلية.
```python
Importing the required libraries etc.
import matplotlib.pyplot as plt import numpy as np from sklearn import datasets from sklearn.preprocessing import StandardScaler from sklearn.svm import SVC
Load the Iris dataset
iris = datasets.load_iris()
Using only the first two features for visualization
X_2d = iris.data[:, :2] y = iris.target
Standardizing the features in the data
scaler = StandardScaler() X2dstd = scaler.fittransform(X2d)
Training the SVM model with a linear kernel
svm2d = SVC(kernel='linear', randomstate=42) svm2d.fit(X2d_std, y) ```
الشكل 21.31 (متابعة)
257 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
```python
Creating a mesh to plot
xmin, xmax = X2dstd[:, 0].min() - 1, X2dstd[:, 0].max() + 1 ymin, ymax = X2dstd[:, 1].min() - 1, X2dstd[:, 1].max() + 1 xx, yy = np.meshgrid(np.arange(xmin, xmax, 0.02), np.arange(ymin, ymax, 0.02))
Predicting each point on the mesh
Z = svm2d.predict(np.c[xx.ravel(), yy.ravel()]) Z = Z.reshape(xx.shape)
Plotting the decision boundaries (as two-dimensional)
plt.contourf(xx, yy, Z, alpha=0.8) plt.scatter(X2dstd[:, 0], X2dstd[:, 1], c=y, edgecolors='g') plt.xlabel('Sepal length (standardized)') plt.ylabel('Sepal width (standardized)') plt.xlim(xx.min(), xx.max()) plt.ylim(yy.min(), yy.max()) plt.xticks(()) plt.yticks(()) plt.title('SVM Linear Kernel on Iris Dataset (First 2 Features)') plt.show() ```
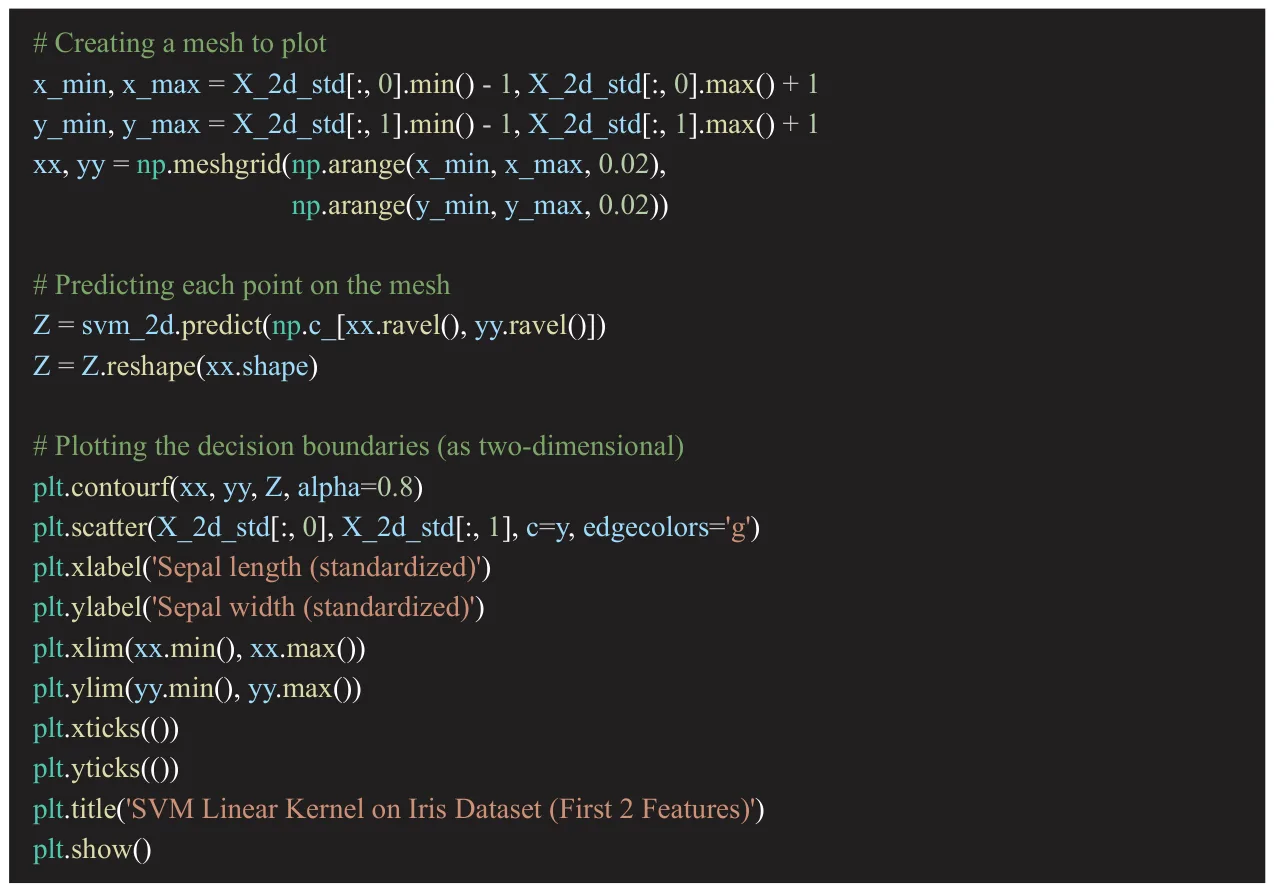
الشكل 21.31 (متابعة): كود بايثون لمحاكاة SVM باستخدام تصنيف الدعم المتجه (SVC).
كما يمكنك أن ترى، تم فصل الفئات الثلاثة المختلفة من زهرة السوسن بشكل عام باستخدام الميزتين المختارتين (عرض الكأس وطول الكأس للزهرة). توفر الحدود الملونة تمثيلاً مرئيًا واضحًا لمكان وجود الفئات الثلاث المختلفة (بشكل عام) في مجموعة البيانات بناءً على توزيع هذه الميزات.
258 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
الأشجار والغابات
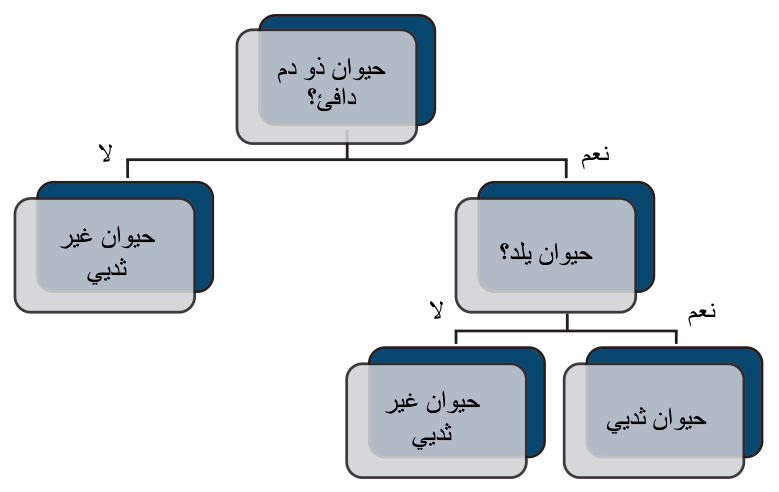
في سياق التعلم الآلي للتصنيف، يشير المصطلحان "الأشجار" و"الغابات" إلى أشجار القرار والغابات العشوائية. شجرة القرار هي هيكل هرمي تمثل فيه كل "عقدة" منفصلة اختبارًا من نوع ما (على سبيل المثال: هل تمطر؟). يمثل كل فرع من فروع الشجرة نتيجة مختلفة لهذا الاختبار (نعم) أو (لا)). تمثل العقد الورقية (تلك التي لا تحتوي على عقد فرعية) تسمية الفئة - وهو قرار يتم اتخاذه. يوفر لك اتباع المسارات من العقدة الجذرية (العلوية) إلى الورقة قواعد يمكنك استخدامها لاتخاذها للتصنيف. توفر شجرة القرارات في الشكل 21.33 نظرة ثاقبة حول كيفية إجراء سلسلة من الاختبارات لتحديد ما إذا كان المخلوق من الثدييات أو غير الثدييات.
شجرة القرار - هي هيكل هرمي حيث تمثل فيه كل 'عقدة' منفصلة اختبارًا من نوع ما (على سبيل المثال: هل تمطر؟). يمثل كل فرع من فروع الشجرة نتيجة مختلفة لهذا الاختبار (نعم) أو (لا)). الغابة العشوائية - مجموعة من أشجار القرارات التي تنشأ لتحسين دقة تصنيفاتها.
يشار إلى الغابة العشوائية عادةً باسم أسلوب التعلم (الجماعي). هذا لأنه يبني أشجار قرارات متعددة (حرفيًا غابة) لتحسين دقة تصنيفاتها. ويقوم بذلك عن طريق تدريب كل شجرة على مجموعة فرعية عشوائية من البيانات المتاحة. ثم يقوم بحساب متوسط هذه التوقعات للحصول على نتيجة أكثر دقة. تحظى هذه النوعية من تقنيات التعلم بشعبية بسبب فعاليتها العامة عبر مجموعة واسعة من أنواع البيانات المختلفة ومشكلات العالم الحقيقي، مثل التصنيف والانحدار واكتشاف الحالات الشاذة. والأهم من ذلك أنها سهلة التفسير نسبيًا.
259 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
مثال عملي
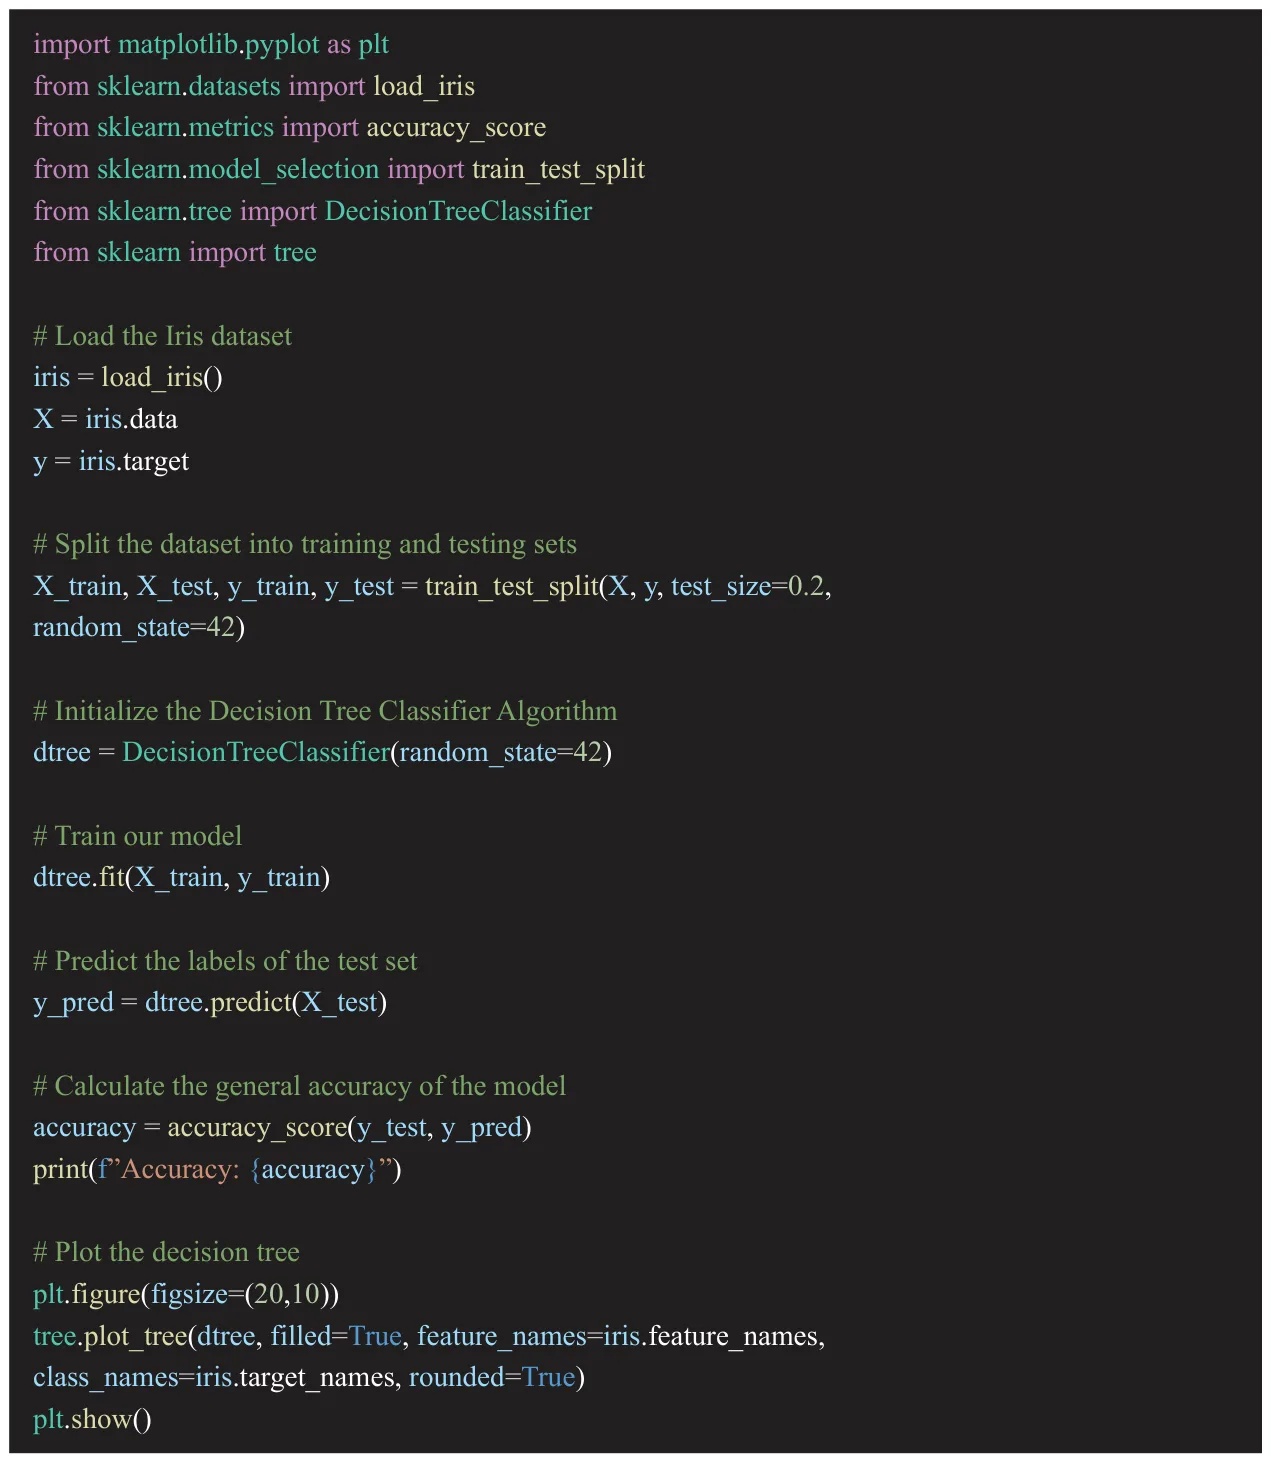
يوضح كود بايثون في الشكل 21.34 استخدام مصنف شجرة القرار. الدقة وشجرة القرار التي يولدها الكود موضحة في الشكل 21.35.
```python import matplotlib.pyplot as plt from sklearn.datasets import loadiris from sklearn.metrics import accuracyscore from sklearn.modelselection import traintest_split from sklearn.tree import DecisionTreeClassifier from sklearn import tree
Load the Iris dataset
iris = load_iris() X = iris.data y = iris.target
Split the dataset into training and testing sets
Xtrain, Xtest, ytrain, ytest = traintestsplit(X, y, testsize=0.2, randomstate=42)
Initialize the Decision Tree Classifier Algorithm
dtree = DecisionTreeClassifier(random_state=42)
Train our model
dtree.fit(Xtrain, ytrain)
Predict the labels of the test set
ypred = dtree.predict(Xtest)
Calculate the general accuracy of the model
accuracy = accuracyscore(ytest, y_pred) print(f'Accuracy: {accuracy}')
Plot the decision tree
plt.figure(figsize=(20,10)) tree.plottree(dtree, filled=True, featurenames=iris.featurenames, classnames=iris.target_names, rounded=True) plt.show() ```
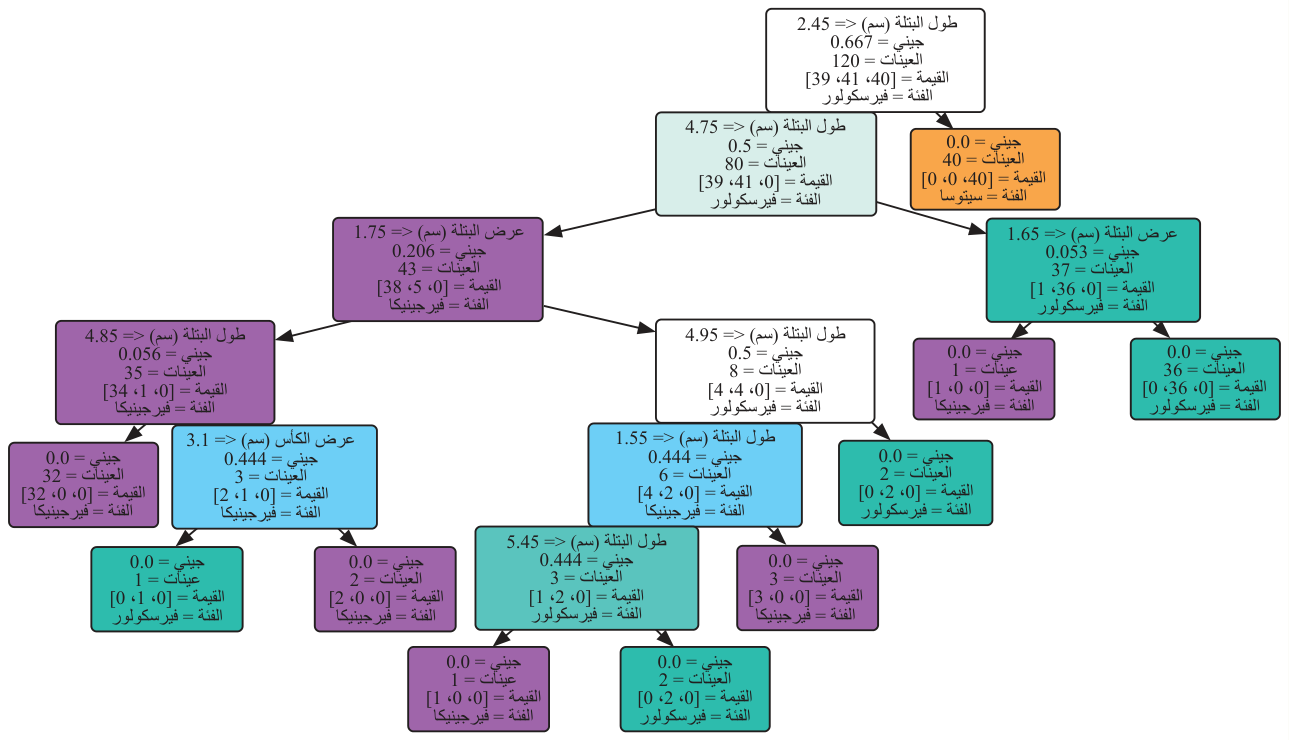
- شجرة القرار المنتجة لمجموعة بيانات السوسن تستخدم عدة مسارات مختلفة.
- يُحدد كل مسار بواسطة مجموعة من قيم البيانات المختلفة، التي تساعد على تحديد احتمالية كون السوسن من فئة معينة (إما سيتوزا، فيرسيكلور وإما فيرجينكا).
- إذا أخذت الآن عينة جديدة من زهرة السوسن، واستخدمت قياسات البيانات المناسبة، يجب أن تكون قادرًا على اتباع المسار المناسب وتحديد فئتها الأكثر احتمالاً.
طرق بايزي
هذه مجموعة من الأساليب الإحصائية، تعتمد على نظرية بايز، التي تصف احتمال حدوث حدث بناءً على المعرفة السابقة بالأحداث السابقة التي قد تكون ذات صلة. يمكن تلخيصها باستخدام ثلاثة مصطلحات:
- P - يشير إلى الاحتمال اللاحق (احتمال وقوع حدث)
- H - يشير إلى الفرضية
- E - يشير إلى الدليل
هذا يؤدي إلى عدد من الصيغ الرياضية المختلفة - على سبيل المثال، على سبيل المثال، P(H|E) هو الاحتمال اللاحق للفرضية H، بالنظر إلى الدليل E. قد يحدث تطبيق بسيط لطرق بايزي في قطاع الصحة. تخيل طبيبًا يحاول تشخيص مرض مريضه بناءً على مجموعة من الأعراض.
- من المرجح أن يستخدم الطبيب خبرته ومعرفته لتحديد احتمالية الإصابة بأمراض مختلفة قد تسبب أعراض المريض. سيكون هذا هو (الاحتمال المسبق) والفرضية التي يبدأ بها الطبيب.
- بمجرد إبداء ملاحظات جديدة حول الأعراض، ومقارنة احتمالية رؤية هذه الأعراض مع كل من الأمراض التي نظروا فيها في الأصل، يمكنهم جمع أدلة جديدة.
الاحتمال اللاحق - هي الحالة التي يُعاد فيها حساب احتمالية أحد الأشياء بناءً على معلومات جديدة. الفرضية - هي فكرة أو تخمين ناتج تم التوصل إليه بالقليل من الأدلة، ويحتاج إلى اختبار لمعرفة صحته من عدمها.
261 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
- وهذا الأمر يسمح لهم بتحديث فرضياتهم والحصول على احتمال لاحق - احتمال محدث لكل مرض - ما يسمح لهم بمراجعة تشخيصهم.
قد تحتاج هذه الطريقة إلى التكرار عدة مرات قبل الوصول إلى تشخيص صحيح. بالنسبة للذكاء الاصطناعي، فإن هذا النهج الإحصائي هو المفتاح لمحاكاة الذكاء البشري وتوفير صنع القرار السليم. في حالة المثال الطبي، قد يتم استخدامه في أداة استشارة عبر الإنترنت في قطاع الصحة.
على عكس مشكلة التعلم الخاضع للإشراف، ستحتاج هذه الخوارزمية المختارة لمشكلات التجميع إلى تحديد الأنماط أو أوجه التشابه من مجموعة البيانات، والتي تمثل بشكل أساسي الميزات المحددة التي تمثل بشكل أفضل كل مجموعة طبيعية (محتملة). هذا يعني أن التدريب باستخدام أمثلة معنونة ليس مطلوبًا فعليًا، وهذا يساعد عادةً على تقليل التكاليف. تشمل الأنواع الشائعة من المشكلات الواقعية التي يمكن أن يساعد التجميع على حلها:
- تحليل البيانات الاستكشافي - العثور على الأنماط أو العلاقات المخفية في البيانات.
- التسويق المخصص للعملاء - تقسيم العملاء إلى مجموعات مختلفة بناءً على عادات التسوق أو التركيبة السكانية وجعل عروضهم أكثر استهدافًا وأكثر جاذبية.
- اكتشاف الانحرافات - العثور على نقاط البيانات غير العادية والتي تنحرف بشكل كبير عن المجموعات أو الأنماط المحددة.
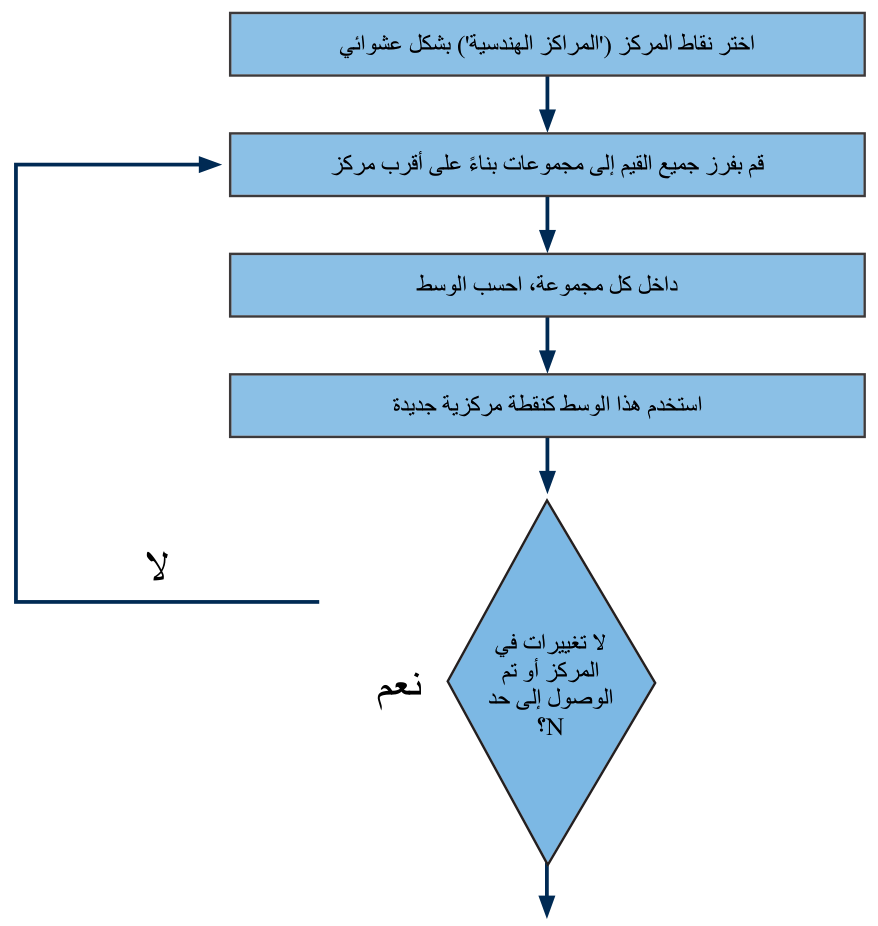
- K-means هي واحدة من خوارزميات التجميع الأكثر شيوعًا لتنفيذ هذا النوع من المهام.
- والتي تعمل بشكل أساسي باستخدام خوارزمية سهلة الفهم نسبيًا. تمثل خوارزمية K ببساطة عدد المجموعات التي يشتبه في وجودها في البداية.
- عند تنفيذه، يمثل N الحد الأقصى لعدد التكرارات التي سيتم تنفيذها.
- يتم تمثيل هذه الخوارزمية بشكل أفضل في شكل مخطط انسيابي، كما هو موضح في الشكل 21.36.
المهارات المعرفية: العمليات والاستراتيجيات المعرفية:
- التفكير الناقد
- حل المشكلات
الإبداع:
- الابتكار
262 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
مثال عملي
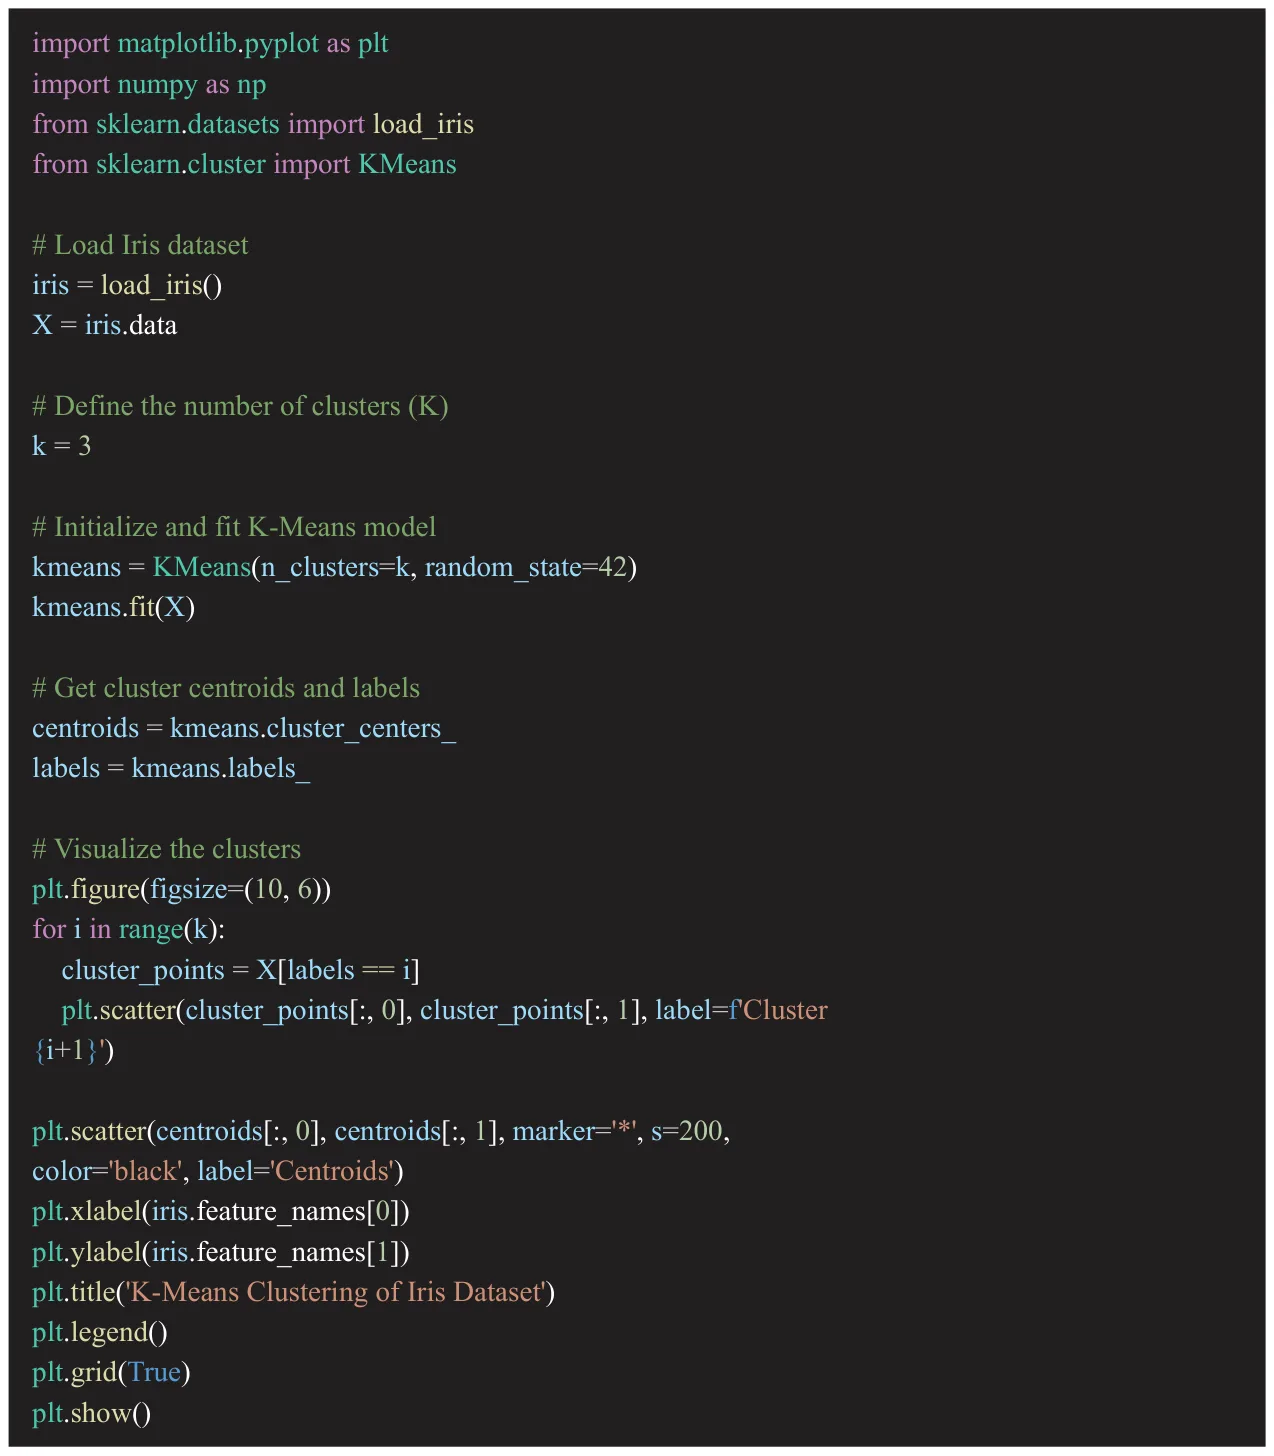
المثال في الشكل 21.37 يستخدم بايثون لتوضيح عملية K-means هذه. إنه يعيد النظر في مجموعة بيانات السوسن التي تمت مشاهدتها سابقًا ويستخدم تقنيات التجميع لمعرفة ما إذا كان ممكنًا استخدام القيم المختارة لتحديد أنواع السوسن المختلفة. الناتج البياني للمجموعات المحددة موضح في الشكل 21.38.
```python import matplotlib.pyplot as plt import numpy as np from sklearn.datasets import load_iris from sklearn.cluster import KMeans
Load Iris dataset
iris = load_iris() X = iris.data
Define the number of clusters (K)
k = 3
Initialize and fit K-Means model
kmeans = KMeans(nclusters=k, randomstate=42) kmeans.fit(X)
Get cluster centroids and labels
centroids = kmeans.clustercenters labels = kmeans.labels_
Visualize the clusters
plt.figure(figsize=(10, 6)) for i in range(k): clusterpoints = X[labels == i] plt.scatter(clusterpoints[:, 0], cluster_points[:, 1], label=f'Cluster {i+1}')
plt.scatter(centroids[:, 0], centroids[:, 1], marker='*', s=200, color='black', label='Centroids') plt.xlabel(iris.featurenames[0]) plt.ylabel(iris.featurenames[1]) plt.title('K-Means Clustering of Iris Dataset') plt.legend() plt.grid(True) plt.show() ```
263 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
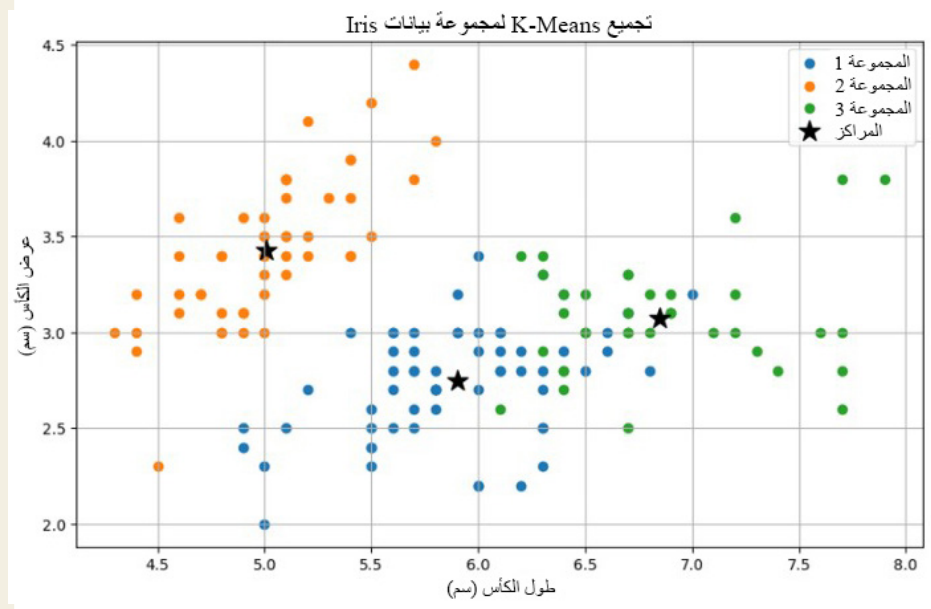
في الشكل 21.38 يمكنك تحديد ثلاث مجموعات مختلفة بناءً على تجميع ميزاتها المختارة:
- عرض الكأس (بالسنتيمترات)
- طول الكأس (بالسنتيمتر).
تمثل النجوم المراكز الهندسية التي تختارها خوارزمية K-means، وتمثل كل مجموعة إحدى الفئات الثلاث المختلفة للسوسن والتي سبق تحديدها بتقنية التصنيف. مع ذلك، كما ترى في المخطط، يوجد بعض الغموض بين المجموعتين 1 و3، كما يتضح من تداخل بعض النقاط البيانية، فقد تستدعي الحاجة المزيد من التحليل لتحسين أي توقعات.
تحليل المكونات الرئيسية (PCA)
يرمز PCA إلى تحليل المكونات الرئيسية، وهو نوع شائع من تقليل الأبعاد الخطية الإحصائية الذي يستخدم التعلم دون إشراف. تقليل الأبعاد الخطية هو خوارزمية تهدف إلى تقليل عدد ميزات البيانات مع الاحتفاظ بأكبر قدر ممكن من المعلومات الأساسية، والأنماط، والعلاقات. يشار إلى المخرجات من تقليل الأبعاد على أنها مكونات رئيسية، ومن هنا جاء اسم تحليل المكونات الرئيسية (PCA). عند تقليله بشكل صحيح، يحتوي المكون الأساسي على معلومات أكثر أهمية من الثاني، والثاني أكثر أهمية من الثالث وهكذا. مع دمج كل ميزة، تصبح الأهمية النسبية والوزن أكبر، لذلك فإن تقليل الميزات من أربعة إلى اثنتين (إذا تم بشكل صحيح) لا يفقد أي بيانات مهمة وقد يكون في الواقع يُكسب بعض البيانات. يعد تقليل الأبعاد أمرًا مهمًا، لأنه كلما زاد كلما زاد عدد ميزات البيانات المستخدمة، زادت التباديل الممكنة، وزادت صعوبة معالجة البيانات بسرعة وكفاءة.
المركز الهندسي - هو النقطة التي تمثل مركز الكتلة لمجموعة من النقاط في الفضاء الهندسي، ويمكن اعتباره متوسط إحداثيات النقاط في المجموعة. المجموعة - مجموعة من أجهزة الحاسوب المتصلة بالشبكة أو "العقد" التي تعمل معًا لتنفيذ مهام المعالجة كما لو كانت جهازًا واحدًا، وتتشارك الموارد مثل: الذاكرة، وقوة المعالجة، والبيانات.
264 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
مثال عملي
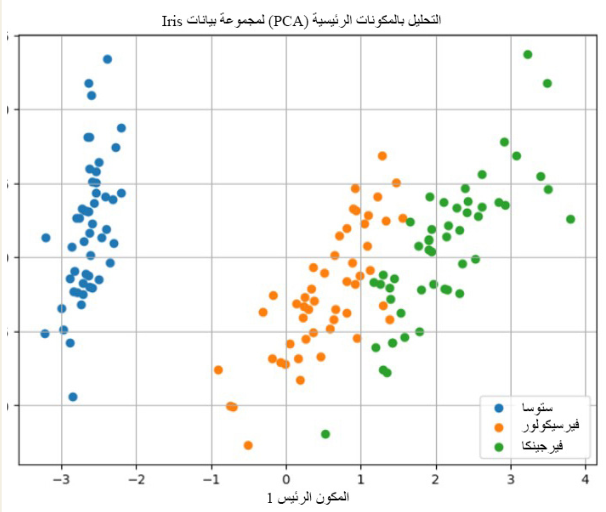
يوضح الشكل 21.39 مثالاً على استخدام تحليل المكونات الرئيسية (PCA) في بايثون لتقليل أربعة ميزات من مجموعة بيانات السوسن (طول الكأس، عرض الكأس، طول البتلة، عرض البتلة) ليصبحا مكونين رئيسيين. يظهر الإخراج الناتج في الشكل 21.40.
```python import numpy as np import matplotlib.pyplot as plt from sklearn.datasets import load_iris from sklearn.decomposition import PCA
Apply PCA to reduce dimensionality to 2 principal components
pca = PCA(ncomponents=2) Xpca = pca.fit_transform(X)
Plot the data in the reduced-dimensional space
plt.figure(figsize=(8, 6)) for i in range(len(np.unique(y))): plt.scatter(Xpca[y == i, 0], Xpca[y == i, 1], label=iris.target_names[i])
plt.title('PCA of Iris Dataset') plt.xlabel('Principal Component 1') plt.ylabel('Principal Component 2') plt.legend() plt.grid(True) plt.show() ```
دون تقليل عدد الميزات من أربعة إلى اثنين، كان من الصعب رسم البيانات في فضاء ثنائي الأبعاد.
265 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
كما تمت مناقشته، يمكن استخدام نماذج الذكاء الاصطناعي لاكتشاف الحالات الشاذة في البيانات. قد تتضمن أمثلة الحالات الشاذة البريد الإلكتروني العشوائي بدلاً من البريد الإلكتروني العادي، أو (في الطب) شذوذ الأنسجة الخبيث وليس الحميد. يمكن استخدام العديد من خوارزميات التعلم الآلي تحت الإشراف والتعلم الآلي دون إشراف لأداء هذا النوع من المهام، لكن ربما يكون الجيران الأقرب (kNN) هم النهج الأكثر بساطة وفعالية للاستخدام.
الجيران الأقرب (kNN)
تعمل هذه الخوارزمية عن طريق حساب المسافة بين نقطة البيانات وأقرب جيرانها k في مجموعة بيانات التدريب. إذا كانت النقطة النقطة البيانية أبعد بكثير من جيرانها الأقربين وفقًا لحد مفضل، يتم تصنيفها على أنها انحرافًا. يمكن أن يختلف الحد الفعلي المستخدم، ويتم تحديده من خلال مزيج من المعرفة الإحصائية ومعرفة المجال.
المهارات المعرفية: الإبداع:
- الإبداع
مهارات التواصل الشخصي: أخلاقيات العمل/الضمير:
- المسؤولية
مثال عملي
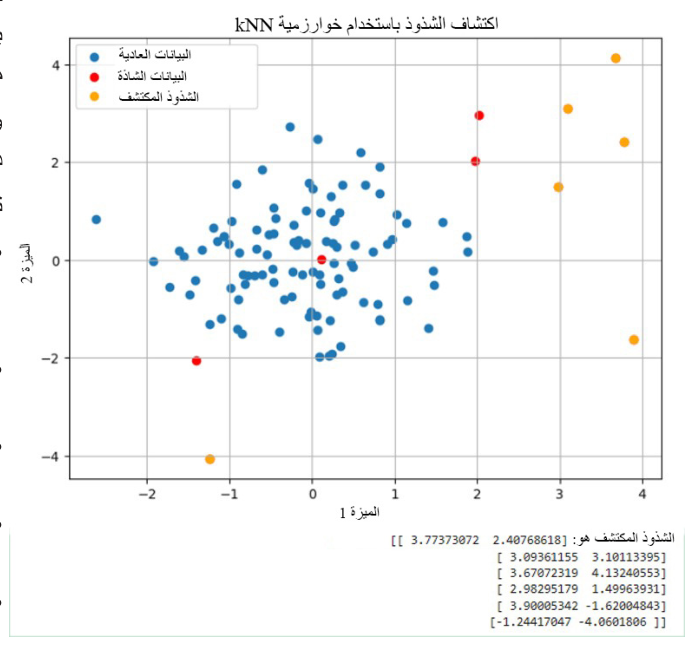
المثال البرمجي في الشكل 21.41 ينشئ بيانات اصطناعية، بما في ذلك بعض البيانات التي يمكن اعتبارها انحرافات. ثم يحاول ملاءمة نموذج kNN فقط لنقاط البيانات العادية. ثم يتم حساب المسافات لجميع النقاط إلى أقرب نقاط k. أي نقاط تكون فوق نسبة 95% تعتبر انحرافًا. يظهر الإخراج الناتج في الشكل 21.42.
```python import numpy as np import matplotlib.pyplot as plt from sklearn.neighbors import NearestNeighbors
Generate synthetic data (normal and anomaly)
np.random.seed(42) normaldata = np.random.randn(100, 2) # Normal data points anomalydata = np.random.uniform(low=-5, high=5, size=(10, 2)) # Anomaly data points
Concatenate normal and anomaly data
data = np.vstack((normaldata, anomalydata))
Fit kNN model
k = 5 # Number of neighbors knnmodel = NearestNeighbors(nneighbors=k) knnmodel.fit(normaldata) # Fit to normal data only
Calculate distances to k nearest neighbors for all data points
distances, indices = knn_model.kneighbors(data) ```
الشكل 21.41 (متابعة)
266 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
```python
Define threshold for anomaly detection
threshold = np.percentile(distances[:, -1], 95) # 95th percentile of distances to k nearest neighbors
Identify anomalies
anomalies = data[distances[:, -1] > threshold]
Plot data points and anomalies
plt.figure(figsize=(8, 6)) plt.scatter(normaldata[:, 0], normaldata[:, 1], label='Normal Data') plt.scatter(anomalydata[:, 0], anomalydata[:, 1], color='red', label='Anomaly Data') plt.scatter(anomalies[:, 0], anomalies[:, 1], color='orange', label='Detected Anomalies') plt.title('Anomaly Detection with kNN Algorithm') plt.xlabel('Feature 1') plt.ylabel('Feature 2') plt.legend() plt.grid(True) plt.show()
print("Detected anomalies are:", anomalies) ```
الشكل 21.41 (متابعة) كود بايثون لاكتشاف الجيران لأقرب الجيران باستخدام بيانات اصطناعية.
كما ترى، هذه العملية ليست مثالية - في حين تم تحديد النقاط البعيدة بشكل صحيح، لم يتم تحديد بعضها الأقرب إلى المركز (أي هربت من الاكتشاف). وبالتالي، سيكون من الضروري تحسين النموذج بشكل أكبر (وزيادة دقته العامة) قبل استخدامه بشكل موثوق في بيئة الإنتاج. تشمل التقنيات الشائعة لتحسين الدقة:
- هندسة الميزات - استخدام المعرفة بالمجال (الفهم الخاص بالموضوع) لتحسين اختيار الميزات المستخدمة في النموذج.
- استخدام خوارزمية أو نموذج مختلف لاكتشاف التأثير في دقة الكشف.
- ضبط النموذج عن طريق تعديل النسب أو الحدود (على سبيل المثال، 95 في المائة في المائة المستخدمة في هذا المثال).
- استخدام التحليل الزمني (المعتمد على الوقت) لتطبيق خوارزميات مثل المتوسطات المتحركة لتسوية البيانات بمرور الوقت.
- استخدام واحدة أو أكثر من هذه التقنيات معًا، وتكرارها عبر العديد من الاختبارات. يمكن أن يؤدي ذلك إلى تعزيز دقة (وبالتالي فعالية) اكتشاف الحالات الشاذة لتطبيق معين.
267 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
استخدامات وفوائد وعيوب الشبكات العصبية
هناك العديد من الاستخدامات المختلفة للشبكات العصبية. تشمل أربعة تطبيقات رئيسية لهذه التقنية ما يأتي:
- تعرف الأنماط (على سبيل المثال، معالجة الكلام والصورة واللغة الطبيعية (NLP))
- أنظمة التوصية (على سبيل المثال، منتجات التجارة الإلكترونية ومنصات البث ومنصات التواصل الاجتماعي)
- اكتشاف حالات الانحراف
- أنظمة التحكم المعقدة في الوقت الفعلي (على سبيل المثال، الروبوتات الصناعية والسيارات ذاتية القيادة وما إلى ذلك).
الفوائد الخمس الأساسية لاستخدام الشبكات العصبية موضحة بوضوح أدناه.
- القدرة على التعلم من كميات هائلة من البيانات دون برمجة صريحة. وهذا يمكنها من اكتشاف الأنماط والروابط المخفية في البيانات.
- إمكانية إجراء معالجة متوازية للبيانات. هذا يجعلها فعالة للغاية من الناحية الحسابية وقادرة على التوسع بسرعة.
- القابلية الكبيرة للتكيف، لا سيما عند العمل مع علاقات البيانات المعقدة وغير الخطية.
- القدرة على استخراج الميزات الجديدة تلقائيًا من البيانات. هذا يقلل الهندسة اليدوية للميزات التي يجب أن يقوم بها عالم البيانات.
- إمكانية تعميمها جيدًا على البيانات الجديدة. هذا يعني أن نموذجهم يعمل بدقة تامة على البيانات التي لم يتم التدريب عليها.
ومع ذلك، فإن الشبكات العصبية تمثل بعض التحديات التشغيلية.
- شدة التعقيد، ما يجعل من الصعب تفسيرها وبالتالي تحقيق الذكاء الاصطناعي القابل للتفسير (XAI).
- استهلاك قدر كبير من موارد الحوسبة (على سبيل المثال، GPU، وحدات معالجة الرسومات والذاكرة والأجهزة المتخصصة الأخرى).
- احتمالية تطلبها كميات هائلة من البيانات المعنونة للتدريب الأولي، وهو ما سيكون غالبًا نشاطًا مكلفًا.
- بالإضافة إلى ذلك، قد لا تتوفر كميات كافية من البيانات ذات الجودة المناسبة بسهولة.
- تتعرض في بعض الأحيان لمشكلة التمام للملاءمة ما يمكن أن يمثل مشكلة عند معالجة بيانات جديدة.
لذلك، من الواضح أن هناك مشكلة تتعلق بالتوازن عند التفكير في الشبكات العصبية. إنها توفر فرصًا رائعة للذكاء الاصطناعي، ولكنها تمثل أيضًا العديد من التحديات الصعبة في الإعداد والتدريب وقابلية الشرح.
ومن الجدير بالذكر أيضًا أن الشبكات العصبية يمكن أن تكون عرضة تحديدًا للهجمات العدائية. في بعض الأحيان يتم تنفيذ الهجمات العدائية ببساطة لتعطيل العمليات، وأحيانًا لخلق نتائج أكثر ملاءمة للمهاجم، وأحيانًا لتحقيق ميزة تجارية. الطبيعة الغامضة لعملية اتخاذ القرار في الشبكة العصبية ووجود مثل هذه الثغرات يمكن أن يؤدي إلى مخاوف بشأن العدالة والتحيز والتأثيرات الاجتماعية. هذا يمكن أن يؤدي إلى تآكل الثقة العامة والثقة بشكل عام. ومصدر قلق خاص بالنظر إلى الاستخدام المتزايد لهذه الأنظمة في قطاعات التمويل والرعاية الصحية والعدالة الجنائية.
الهجمات العدائية - تقع هذه الهجمات عندما يصيغ المخربون مدخلات ضارة يمكن أن 'تسمم' بيانات تدريب الشبكة ما ينجم عنه عدم صحة التنبؤات التي يقدمها النموذج.
268 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
ج2 أدوات تطوير حلول الذكاء الاصطناعي
إن مشهد أدوات الذكاء الاصطناعي واسع ومعقد على حد سواء، ويضم مجموعة واسعة من المنصات التجارية والمفتوحة المصدر والتطبيقات والمكتبات والأطر، وتقدم مجموعة من الخيارات لأولئك الذين يرغبون في حل مشكلات معقدة في العالم الحقيقي.
جمع البيانات وتصنيفها
تتضمن هذه العملية جمع وتصنيف البيانات (التي قد تكون مجمعة من مصادر متعددة) لإنشاء مجموعة بيانات يمكن استخدامها بواسطة نماذج التعلم الآلي. Labelbox تعد أحد الأمثلة على أداة لهذا النوع من التطبيقات.
استكشاف البيانات وتمثيلها
تتضمن هذه المرحلة تحليل البيانات المجمعة لإجراء التجارب واكتساب الأفكار. تشمل الأدوات النموذجية لهذه المرحلة ما يأتي:
- دفتر جوبتر (Jupyter Notebook)
- الباندا (Pandas)
- ماتبلوتليب (Matplotlib)
- سيبورن (Seaborn)
- تابلو (Tableau)
التدريب النموذجي والاختبار والتقييم
تتضمن هذه المرحلة تدريب النموذج باستخدام الميزات المحددة والخوارزمية التعلم الآلي المحددة والمعلمات الفائقة المرتبطة بها. تشمل الأدوات النموذجية:
- سايكيت - ليرن (scikit-learn)
- تنسرفلو (TensorFlow)
- بايتورتش (PyTorch)
- كيراس (Keras)
نشر النموذج
بمجرد تدريب النموذج بنجاح إلى مستوى مقبول من الدقة، يتم نشره في بيئات الإنتاج حيث يمكنه عمل تنبؤات بشأن البيانات الجديدة. من الممارسات الشائعة توفير واجهة برمجة تطبيقات قائمة على الويب للخدمات والتطبيقات الأخرى للتفاعل معها مباشرة. تشمل الأدوات النموذجية:
- دوكر (Docker)
- كوبرنيتيس (Kubernetes)
- خدمة تينسرفلو (TensorFlow Serving)
- سيلدون (Seldon)
- فاست إيه بي أي (FastAPI)
المهارات المعرفية: العمليات والاستراتيجيات المعرفية:
- التفكير الناقد
- حل المشكلات
- اتخاذ القرار
بحث
اختر أداة واحدة من كل مرحلة من مراحل تطوير الذكاء الاصطناعي واكتشف:
- ما أنظمة التشغيل التي تعمل عليها (على سبيل المثال، Microsoft Windows, Linux, Mac, OS وغيرها)
- ما المهام التي يؤدونها فعليًا
- كيف يمكن استخدامها (على سبيل المثال، يدويًا أو برمجيًا)
- تكلفة البرنامج (أي ما إذا كان مفتوح المصدر، ترخيص تجاري، وما إلى ذلك)
- مدى تكاملها مع الأدوات الأخرى (على سبيل المثال، scikit-learn مع Matplotlib، وما إلى ذلك).
269 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
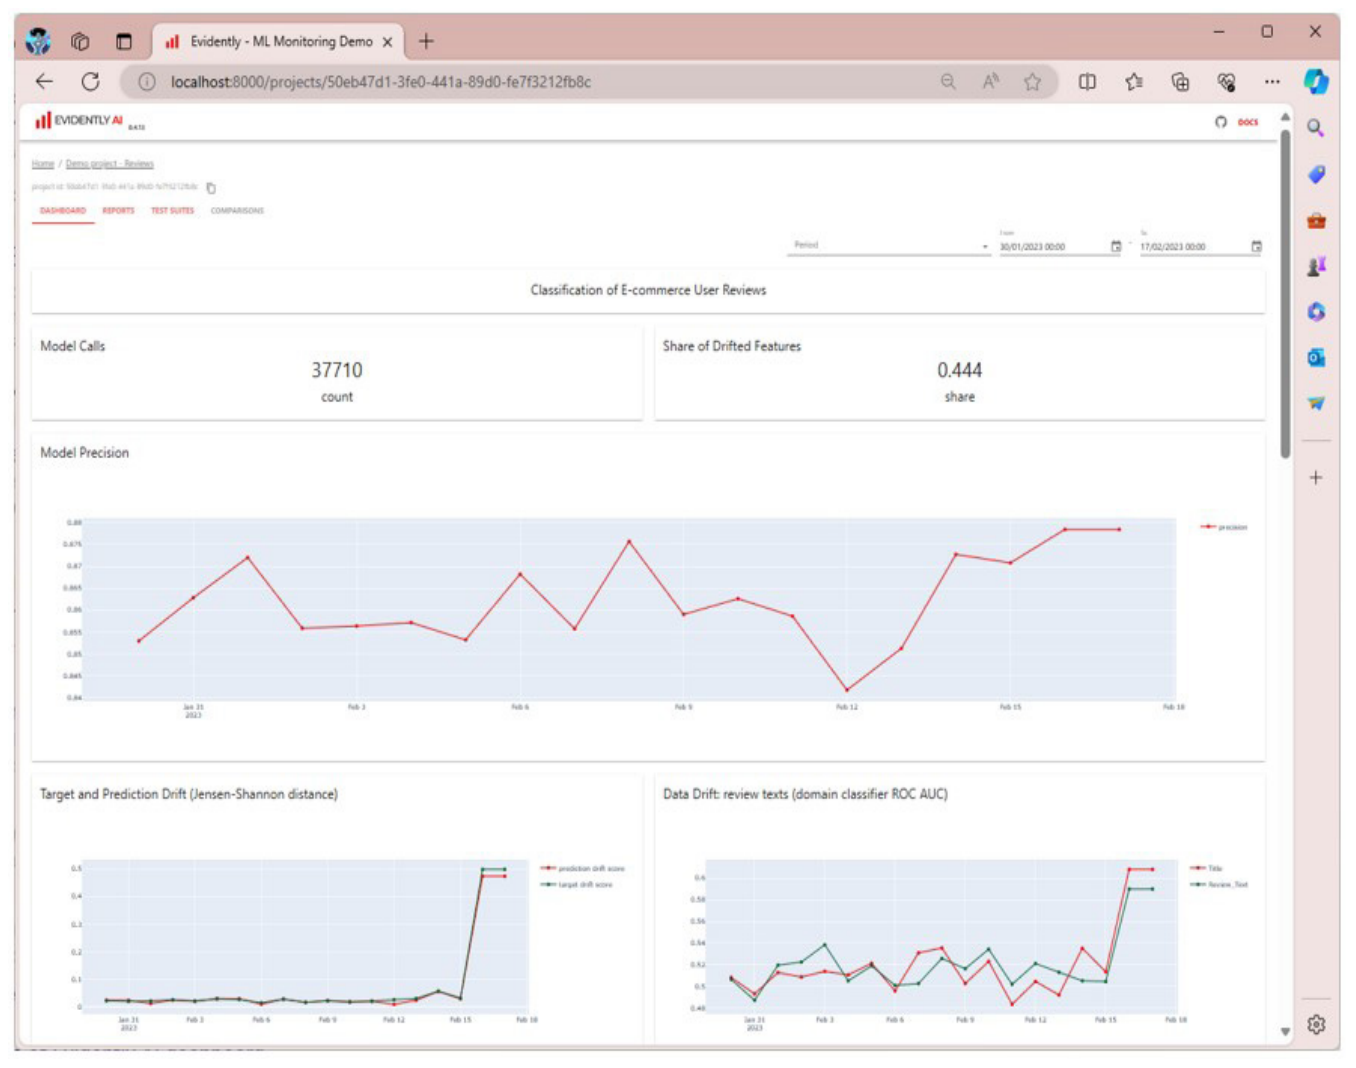
مجال آخر للتركيز على الأدوات هو الذكاء الاصطناعي القابل للتفسير (XAI). يعد استخدام الوسائل المرئية وأدوات لوحة التحكم طريقة مثالية لتقديم النتائج وعمليات الذكاء الاصطناعي بطريقة شفافة وذات مغزى. يوجد العديد من المنتجات التجارية مفتوحة المصدر التي تسمح لعالم البيانات بما يأتي:
- تحديد المقاييس الشائعة (على سبيل المثال، الدقة العامة، التغييرات في جودة النموذج، وما إلى ذلك)
- تسجيل هذه المقاييس بانتظام
- إنشاء مكون مرئي (على سبيل المثال، مخطط أو رسم بياني، وما إلى ذلك) لهذه المقاييس
- إنشاء لوحة معلومات تحتوي على عدد من المكونات المرئية المختلفة.
- من الواضح أن (https://docs.evidentlyai.com) هي أداة مفتوحة المصدر مصممة خصيصًا لمراقبة نماذج التعلم الآلي وتحليلها في أثناء تشغيلها في الإنتاج.
- بالإضافة إلى ذلك، تدعم Evidently AI تنبيهات قابلة للتخصيص يمكنها تفعيل الإشعارات عندما تنخفض المقاييس عن (أو تتجاوز) مستويات التسامح المحددة.
270 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
برمجة الحاسب ولغات البرمجـة لحلول كتابة الكود
يمكن استخدام العديد من لغات البرمجة المختلفة لتطوير وبرمجة الخوارزميات التي تشكل جوهر معظم حلول الذكاء الاصطناعي. وتشمل هذه اللغات بايثون وآر وجافا.
بايثون
بايثون هي واحدة من أكثر اللغات شعبية في العالم وغالبًا ما تشكل مقدمة المتعلم للبرمجة. بدلاً من تفضيل نهج واحد، فإنه في الواقع مزيج من نماذج البرمجة المختلفة، بما في ذلك البرمجة الإجرائية والوظيفية والبرمجة الموجهة للكائنات. إنها لغة مفسرة، إذ يُترجم أولاً كل توجيه وارد في التعليمات إلى بايت كود بايثون ثم إلى كود الآلة المستهدف ليُنفذ بوحدة المعالجة المركزية الأصلية. على الرغم من أن هذا النهج لا يجعلها أسرع لغة في الاستخدام، إلا أن طبيعتها ذات الأغراض العامة مناسبة للعديد من الأنشطة المختلفة، بما في ذلك علم البيانات والعمل على الذكاء الاصطناعي. كما أنها مناسبة بشكل استثنائي للتعامل مع البيانات. بفضل طبيعتها القابلة للتوسعة وقدرتها على استيراد حزم إضافية (العديد منها مكتوب بلغة C عالية السرعة)، يمكن لبايثون توفير أدوات وأطر لحل التحديات الرياضية والإحصائية والخوارزمية المعقدة. تتضمن الحزم المعروفة (مجموعة الوحدات) ما يأتي:
- نامباي (NumPy): حزمة أساسية وقوية للحوسبة العددية في بايثون تستخدمها العديد من اللغات الأخرى. توفر دعمًا للمصفوفات الكبيرة متعددة الأبعاد، إلى جانب مجموعة من الدوال الرياضية للعمل عليها بكفاءة.
- الباندا (Pandas): مكتبة أساسية وقوية لتحليل البيانات ومعالجتها لبايثون. إنها توفر هياكل بيانات مثل DataFrames وSeries لتسهيل التعامل مع البيانات المنظمة وتحليلها.
- ماتبلوتليب (Matplotlib): مكتبة رسم تستخدم لإنشاء تصورات ثابتة وتفاعلية ومتحركة في بايثون.
موضوعات ذات صلة
الوحدة 4: البرمجة تركز على عدد من لغات البرمجة المختلفة، بما في ذلك بايثون. يجب أن تساعد هذه الوحدة على تعزيز فهمك لتركيبات تلك اللغة. يجب أن يبرز الاختلافات البنيوية مع اللغات الأخرى في قطاع تكنولوجيا المعلومات.
مثال عملي
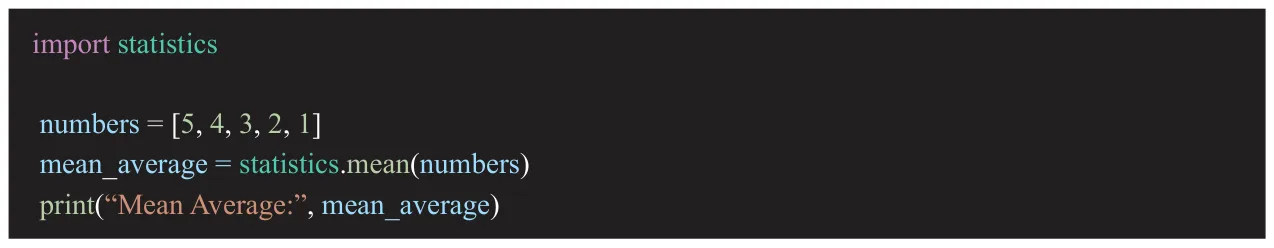
يقوم برنامج بايثون الموضح في الشكل 21.44 بحساب وإخراج متوسط قائمة قيم الأعداد الصحيحة (العدد الصحيح) - وهي عملية إحصائية شائعة. يظهر الناتج في الشكل 21.45.
``python import statistics numbers = [5, 4, 3, 2, 1] mean_average = statistics.mean(numbers) print("Mean Average:", mean_average) ``
الشكل 21.44 استخراج بايثون لحساب متوسط قائمة من خمسة أعداد صحيحة.
``text Mean Average: 3 ``
الشكل 21.45 توضح مخرجات الكود أن المتوسط الحسابي للأرقام 1، 2، 3، 4 و5 هو 3.
271 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
تستخدم بايثون الرموز للإشارة إلى أنواع مختلفة من هياكل البيانات - على سبيل المثال، يُستخدم الرمز [ ] للإشارة إلى القائمة. ستلاحظ أنه من الضروري استيراد دالة 'mean' من وحدة تسمى 'statistics'. على الرغم من أن هذه الوحدة جزء من مكتبة بايثون القياسية، إلا أنها ليست دالة (مضمنة)، ما يعني أنه يجب استيرادها يدويًا قبل الاستخدام. يمكن تنزيل مجموعة واسعة من الحزم والوحدات الأخرى باستخدام مدير حزم بايثون 'pip' من مستودع الحزم عبر الإنترنت: pypi.org.
جافا
من المثير للدهشة أن جافا التي تم تطويرها في عام 1995، هي في الواقع أصغر من بايثون، التي ظهرت لأول مرة في عام 1991. منذ ذلك الحين، شهدت كلتا لغتي البرمجة تطورًا كبيرًا. يُنظر إلى جافا على أنها لغة برمجة قائمة على الفئة وموجهة للكائنات (OOP). نظرًا لتجميع جزء من كود المصدر الخاص به إلى بايت كود جافا، من الناحية النظرية، من الممكن كتابة البرامج مرة واحدة وتشغيلها في أي مكان: وهو مفهوم يسمى WORA. يتم تنفيذ كود جافا فعليًا على آلة جافا الافتراضية (أو JVM) وهي متوفرة لمعظم بنى الحواسيب. هذا يجعل لغة جافا قابلة للنقل بشكل كبير وخيارًا شائعًا للمشاريع المتعلقة بالذكاء الاصطناعي. على عكس اللغات مثل بايثون التي تكون ذات طابع ديناميكي، فإن جافا ذات طابع قوي وثابت، ما يعني أساسًا أنه بمجرد إعلان المتغير بشكل رسمي، لا يمكن تعيين أي قيم لا تتطابق مع نوع بياناته في أثناء مدة تنفيذه.
مثال عملي
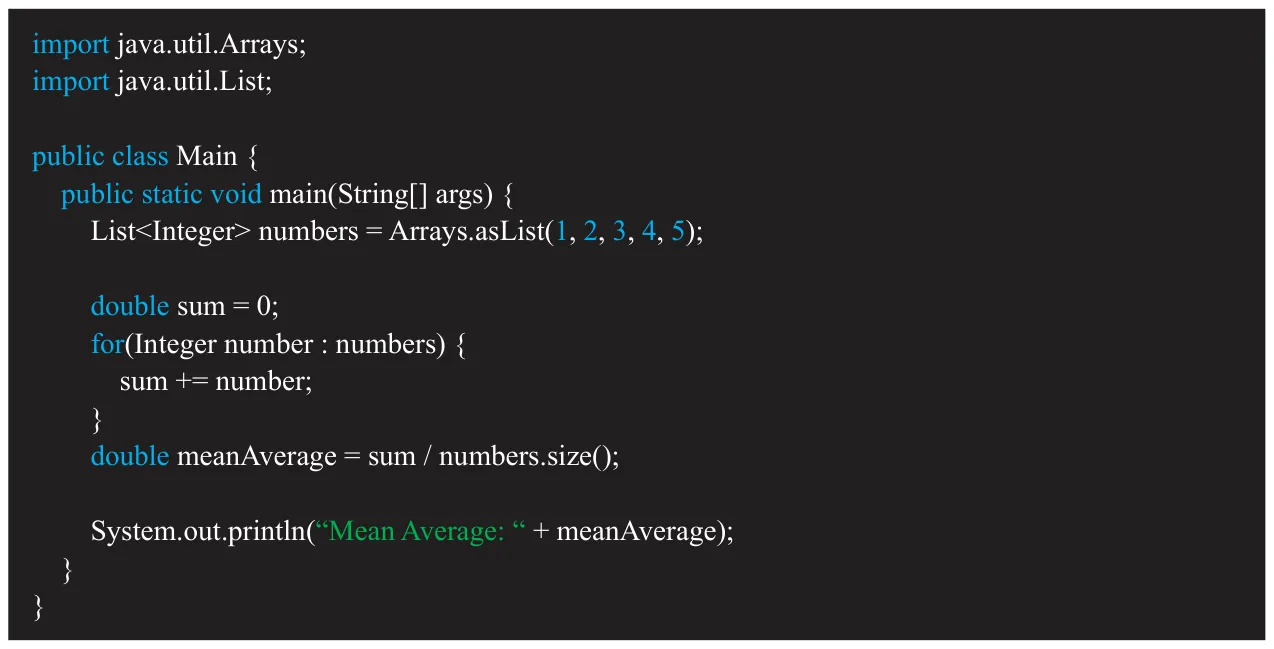
يوضح الشكل 21.46 المشكلة نفسها من مثال بايثون، والتي حلت باستخدام لغة جافا. النتيجة موضحة في الشكل 21.47.
``java import java.util.Arrays; import java.util.List; public class Main { public static void main(String[] args) { List<Integer> numbers = Arrays.asList(1, 2, 3, 4, 5); double sum = 0; for(Integer number : numbers) { sum += number; } double meanAverage = sum / numbers.size(); System.out.println("Mean Average: " + meanAverage); } } ``
الشكل 21.46 برنامج جافا لحساب متوسط قائمة من خمسة أعداد صحيحة.
``text Mean Average: 3.0 ``
الشكل 21.47 نتيجة من كود جافا بحسب المتوسط الحسابي للأرقام 1، 2، 3، 4 و5 على أنه 3.0.
272 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
- كما ترى في المثال العملي، فإن حلول الكود في جافا يتطلب بعض الجهد أكثر من بايثون أو ليسب (انظر إلى قسم ليسب، الذي يتبع جزء R، أدناه)، إذ يستخدم فئة، ودالة، وكتل متعددة محاطة بأقواس معقوفة (طريقة لتجميع العبارات موروثة من لغة البرمجة C) وحلقة 'for' محسنة، ولكن هذه مقاربة بسيطة نسبيًا.
- فهي معقدة إلى حد ما وربما أكثر رهبة للمبتدئين مقارنة بلغة بايثون ما يفسر بالتأكيد نمو بايثون وارتفاع شعبيتها في السنوات العشر الأخيرة.
R
لغة R هي لغة عامة، على عكس بايثون، مُصممة خصيصًا للتعامل مع الحوسبة الإحصائية والرسوم، وهي بارعة تحديدًا في التعامل مع هياكل البيانات المسماة (على سبيل المثال، المصفوفات، والمصفوفات الثنائية، والمتجهات، وإطارات البيانات، والقوائم). إحدى مزايا لغة R هي قدرتها على دعم العمليات المتجهة، وهي عمليات تجعل معالجة البيانات وتحليلها أمرًا بسيطًا للغاية. وتجدر الإشارة إلى أن العديد من وحدات المعالجة المركزية تدعم التعليمات التي يمكنها تطبيق العملية نفسها في وقت واحد على أجزاء متعددة من البيانات (خاصة قائمة القيم). تعمل هذه العمليات الموجهة على تقليل التكرارات إذ تُشغَّل التعليمات بشكل متزامن، ما يؤدي إلى تقليل أوقات المعالجة بشكل كبير (وأكثر كفاءة).
مثال عملي
الشكل 21.48 يوضح أحد مشتقات R يقوم بحساب المتوسط الحسابي بالطريقة نفسها. يظهر الإخراج الناتج في الشكل 21.49. في هذا المثال، تحتوي R على دالة 'mean' مدمجة يمكن استخدامها فورًا في الكود دون الحاجة إلى استيرادها من مكتبة.
``R numbers <- c(1, 2, 3, 4, 5) mean_average <- mean(numbers) cat("Mean Average:", mean_average, "\n") ``
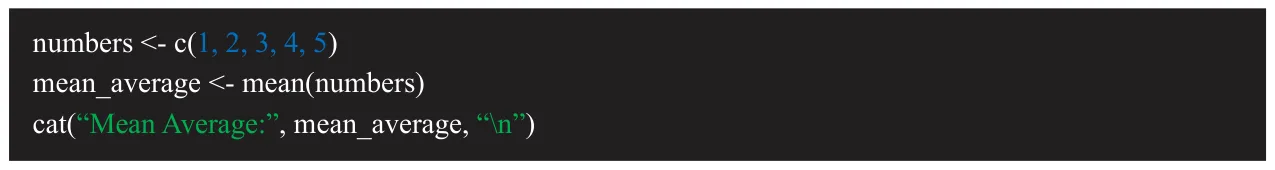
الشكل 21.48 أحد مشتقات R الذي يقوم بحساب المتوسط الحسابي لخمسة أرقام.
الشكل 21.49 الناتج من برنامج R يوضح أن متوسط 1، 2، 3، 4 و5 هو 3.
ليسب (Lisp)
ليسب هو اختصار لمعالجة القوائم. إنها واحدة من أقدم لغات البرمجة عالية المستوى (الشبيهة باللغة الطبيعية)، حيث تم تطوير النسخة الأصلية في عام 1958. نتيجة لذلك، كان للغة ليسب تاريخ غني مع الذكاء الاصطناعي وتطوراته لعدة عقود. في الواقع، لغة ليسب هي في الحقيقة أكثر من مجرد لغة واحدة؛ فهي في الواقع مجموعة من اللغات. ليسب العادية هي واحدة من أكثر لغاتها شهرة، جنبًا إلى جنب مع كلوجر. تتمثل إحدى نقاط قوتها الخاصة في قدرتها على إجراء العمليات الحسابية الرمزية، ما يمكنها من التلاعب بهذه الرموز بطريقة يمكن لعلماء الرياضيات تعرفها بسهولة باعتبارها تعبيرات جبرية. إن هذه الخاصية، إلى جانب دعمها للدوال العودية، تجعل اللغة مناسبة بشكل خاص للذكاء الاصطناعي، وإثبات النظريات، ومعالجة اللغة الطبيعية.
273 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
تسمح الدالة العودية، وهي ميزة في العديد من لغات البرمجة، للوظائف بالاتصال بنفسها لمعالجة أنواع معينة من الخوارزميات (على سبيل المثال، العوامل ومتتالية فيبوناتشي والبحث الثنائي).
مثال عملي
يوضح الشكل 21.50 برنامج ليسب يقوم بحساب المتوسط الحسابي بالطريقة نفسها. يظهر الناتج في الشكل 21.51.
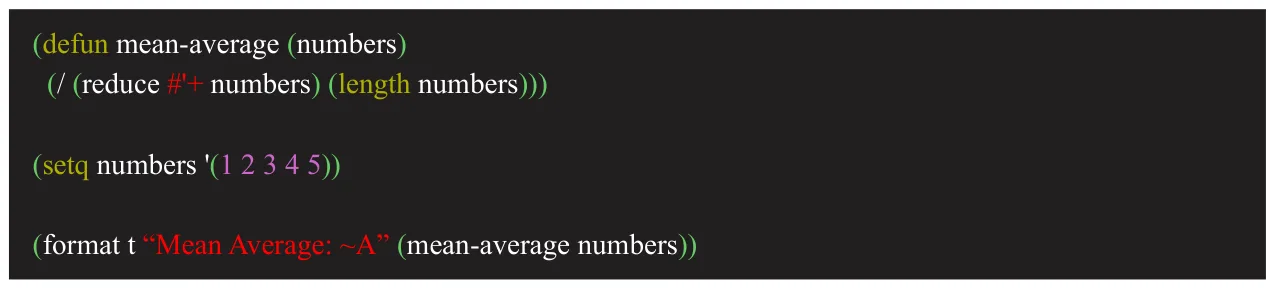
```lisp (defun mean-average (numbers) (/ (reduce #'+ numbers) (length numbers)))
(setq numbers '(1 2 3 4 5))
(format t "Mean Average: ~A" (mean-average numbers)) ```
الشكل 21.50 برنامج ليسب يقوم بحساب المتوسط الحسابي لخمسة أرقام.
الشكل 21.51 ناتج من ليسب يوضح أن متوسط 1، 2، 3، 4 و5 هو 3.
- يمكن أن تكون صياغة لغة ليسب مربكة للوهلة الأولى، نظرًا لاستخدامها الأقواس للإشارة إلى كل من الكود وهياكل البيانات.
- في هذا المثال، يتم حساب متوسط المتوسط يدويًا (عن طريق حساب مجموع جميع العناصر في القائمة ثم تقسيمها على طولها).
- يتم تنفيذ العمل الفعلي من خلال دالة (المتوسط) التي تم الإعلان عنها، ويتم استدعاؤها من داخل وظيفة (التنسيق)، والتي توجه متوسط الدالة الذي تم إرجاعه إلى الإخراج القياسي (عادة، جهاز العرض الخاص بك).
المكتبات والأطر
المكتبات والأطر عبارة عن طرود قابلة لإعادة الاستخدام من أكواد خارجية (عادة) تساعد مطوري البرامج في المهام الشائعة. وعلى الرغم من استخدام هذين المصطلحين غالبًا بالتبادل، إلا أن هناك تمييزًا دقيقًا بينهما. بشكل عام، فإن الطريقة التي يتم بها دمجها في المشاريع هي التي تساعد على تمييزها.
- باستخدام مكتبة، يمكن لمطور البرامج أو عالم البيانات اختيار عناصر الكود التي يرغبون في استخدامها، كما أن بنية الحل تخصهم أيضًا.
- باستخدام إطار العمل، يتم توفير الهيكل بشكل عام بواسطة البرنامج ويقوم مطور البرامج أو عالم البيانات بإضافة رمز إليه - الهيكل ليس تصميمهم الخاص.
الجدول 21.10 مكتبة مقابل إطار عمل، يوضح الخصائص الرئيسة لكل نوع
| مكتبة | إطار العمل |
|---|---|
| مجموعة من الفئات، والدوال، والثوابت، وما إلى ذلك. | يوفر هيكلاً يمكن للمطور بناء مشروعه عليه |
| يقوم المطور بتضمين هذه العناصر بحسب الحاجة | يتم ربط كود المطور واستدعاؤه بحسب الحاجة من الإطار |
| يستدعي المطور هذه العناصر بحسب الحاجة | يحدد الإطار إلى حد كبير هيكل المشروع |
| يتحكم المطور في بنية الحل البرمجي |
274 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
تشمل المكتبات والأطر المشتركة التي تهم أبحاث ومطوري الذكاء الاصطناعي ما يأتي.
- Scikit-learn هي مكتبة مفتوحة المصدر شهيرة لبايثون مبنية على وحدات بايثون الموجودة مثل NumPy وSciPy وmatplotlib. تشتهر ببساطتها وسهولة استخدامها، ولهذا السبب تحظى بشعبية لدى طلاب علوم البيانات.
- وتدعم مجموعة كبيرة من خوارزميات التعلم الآلي تحت الإشراف والتعلم الآلي دون إشراف وهي خيار مثالي لاستكشاف البيانات وتحليلها.
- سترى استخدام scikit-learn في كل من الأوساط الأكاديمية والصناعية ببساطة لأنها قوية ومتعددة الاستخدامات.
- TensorFlow هي مكتبة مفتوحة المصدر تم تطويرها بواسطة Google. يتم استخدامها للحساب العددي والتعلم الآلي (ML).
- وتساعد على بناء شبكات عصبية تكشف وتفك رموز الأنماط والارتباطات.
- تُستخدم بشكل أساسي مع بايثون وC++ (للسرعة)، وتدعم واجهة برمجة التطبيقات (API) للغات Go وJava وSwift وJavaScript.
- OpenNN تعني الشبكات العصبية المفتوحة (المكتبة).
- هذه مكتبة برامج تمت كتابتها للغة C++ وهي مصممة لتنفيذ الشبكة العصبية، وهو مفهوم أساسي للتعلم العميق.
- يتم استخدامها بشكل أساسي لتطوير النماذج التنبؤية وتتمتع بسمعة طيبة لأدائها العالي وتعدد استخداماتها.
OpenCV تعني رؤية الحاسب مفتوحة المصدر (المكتبة). طورتها شركة Intel في البداية، كما تدعمها الأنظمة الأساسية (على سبيل المثال، Windows وLinux وmacOS). وتدعم لغات برمجة متعددة بما في ذلك C++ وبايثون وJava، ما يوفر مجموعة شاملة من الخوارزميات والأدوات لرؤية الحاسب والتعلم الآلي. تم تصميم OpenCV لمساعدة علماء البيانات والمطورين والباحثين على إنشاء تطبيقات يمكنها معالجة البيانات المرئية وفهمها. تشمل تطبيقات OpenCV الاستخدام في أنظمة CCTV (تلفزيون الدائرة المغلقة) للكشف عن الحركات المشبوهة والسيارات ذاتية القيادة وأنظمة تمييز الوجوه.
- Weka تعني بيئة Waikato لتحليل المعرفة وقد تم تطويرها في جامعة Waikato في نيوزيلندا.
- إنها مكتبة برامج تعلم آلي مفتوحة المصدر مكتوبة بلغة Java. توفر أدوات لتحليل البيانات والنمذجة التنبؤية والتصور.
- كما أنها أداة تمهيدية جيدة وقادرة على إنشاء نماذج معقدة.
- تتضمن واجهة المستخدم الرسومية سهلة الاستخدام (GUI) التي تُتيح إمكانية إنشاء أنواع نماذج مختلفة دون الحاجة إلى كتابة أي كود. وتستفيد من التوثيق الجيد ودعم المجتمع.
- Apache Hadoop هو إطار مفتوح المصدر تم إنشاؤه بواسطة Apache وهو مصمم لتخزين ومعالجة البيانات الضخمة عبر المجموعات.
- يتمتع بسمعة طيبة بسبب قابليته للتطوير والمرونة في مواجهة الأعطال.
- يستخدم أباتشي هادوب HDFS - نظام الملفات الموزع Hadoop. وهو نظام تخزين قابل للتطوير ويتحمل الأخطاء بدرجة كبيرة ويمكنه تقسيم البيانات عبر أجهزة متعددة.
- كما يستخدم نموذج MapReduce الشهير الذي يعالج مجموعات البيانات الكبيرة باستخدام خوارزمية موزعة. يقوم نظام آخر يُعرف باسم YARN (مفاوض موارد آخر) بجدولة وإدارة الموارد في المجموعة.
المعالجة العنقودية
- تعد المعالجة العنقودية (باستخدام شبكة من أجهزة الحاسب أو العقد المتصلة) مفيدة بشكل خاص لتطبيقات الذكاء الاصطناعي والتطوير.
- إنه نهج يمكن توسيع نطاقه أو تقليله بسرعة اعتمادًا على الأحمال الحالية، دون الحاجة إلى تعديل الأكواد أو النماذج أو البيانات الأساسية. توزيع المهام يعني أيضًا أن هذا النهج
275 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
متسامح جدًا مع الأخطاء. هذا لأن فشل العقد الفردية ليس كارثيًا، حيث يمكن للآخرين متابعة المعالجة دون توقف أو فقدان الخدمة.

استخدام الأدوات التي توفرها بيئات التطوير المتكاملة وأدوات تطوير الأكواد ذات الصلة
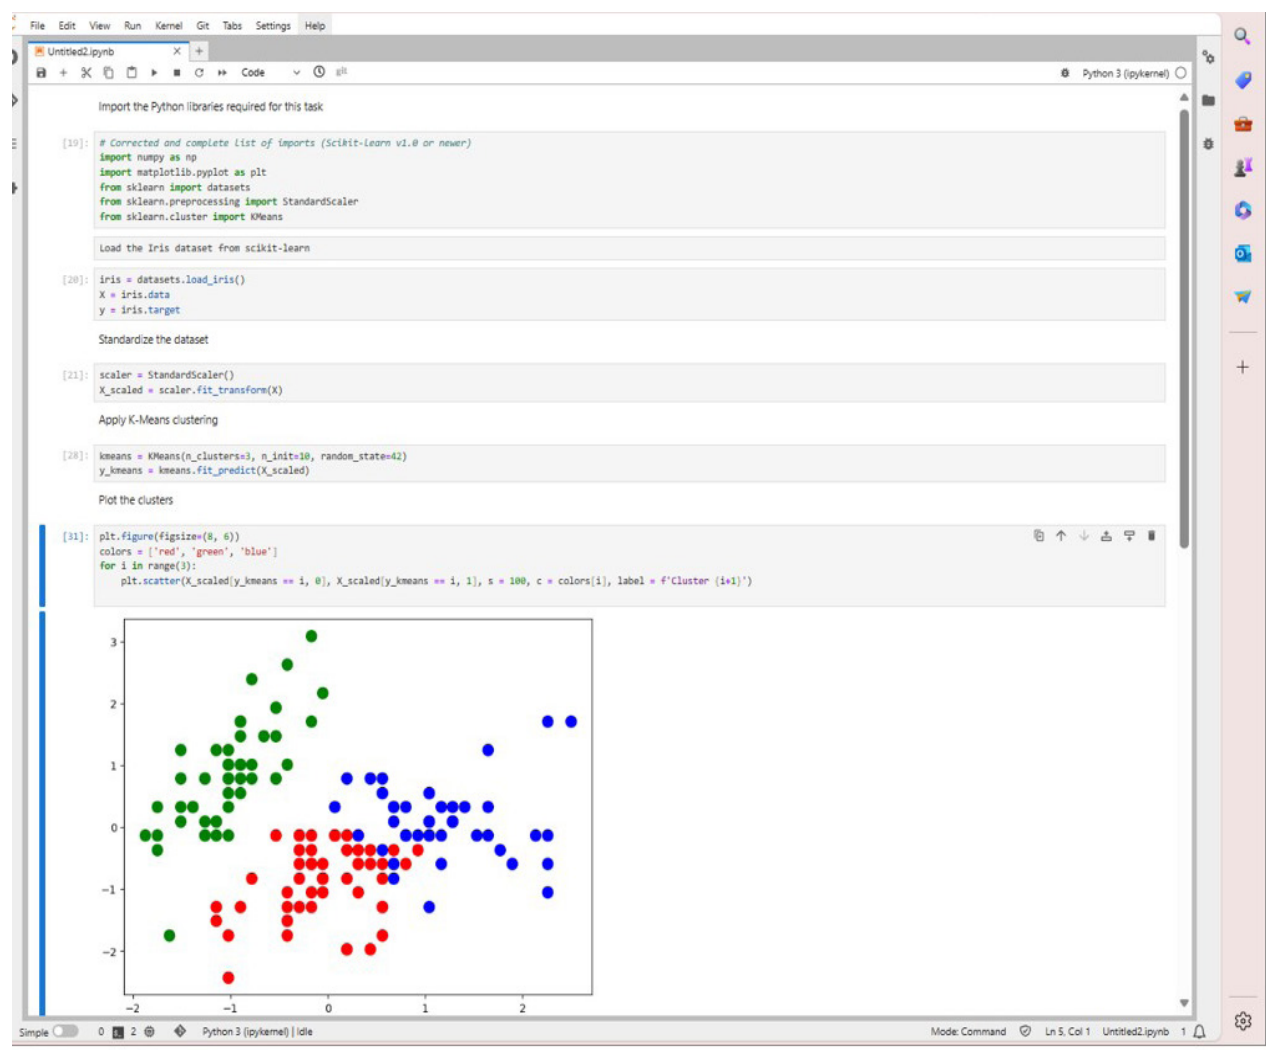
عند تطوير أنظمة الذكاء الاصطناعي، يتعين على علماء البيانات استكشاف البيانات وإجراء العديد من التجارب لإثبات أفكارهم ومفاهيمهم. على الرغم من أنه يمكن استخدام بيئات التطوير المتكاملة التقليدية (على سبيل المثال، PyCharm وMicrosoft VS Code وما إلى ذلك)، إلا أنها ليست أفضل الخيارات لتتبع التقدم أو إنشاء سجل سردي للخطوات المتخذة. هذا هو المكان الذي تثبت فيه تطبيقات مثل JupyterLab وJupyter Notebook أنها أصول قيمة. Jupyter Notebook هو تطبيق قائم على الويب يسمح لعالم البيانات بإنشاء ومشاركة المستندات التي يمكن أن تحتوي على تجارب تعلم الآلة القيمة. يمكن أن يحتوي كل دفتر ملاحظات على مزيج من الخلايا. تحتوي كل خلية من هذه الخلايا على ما يأتي:
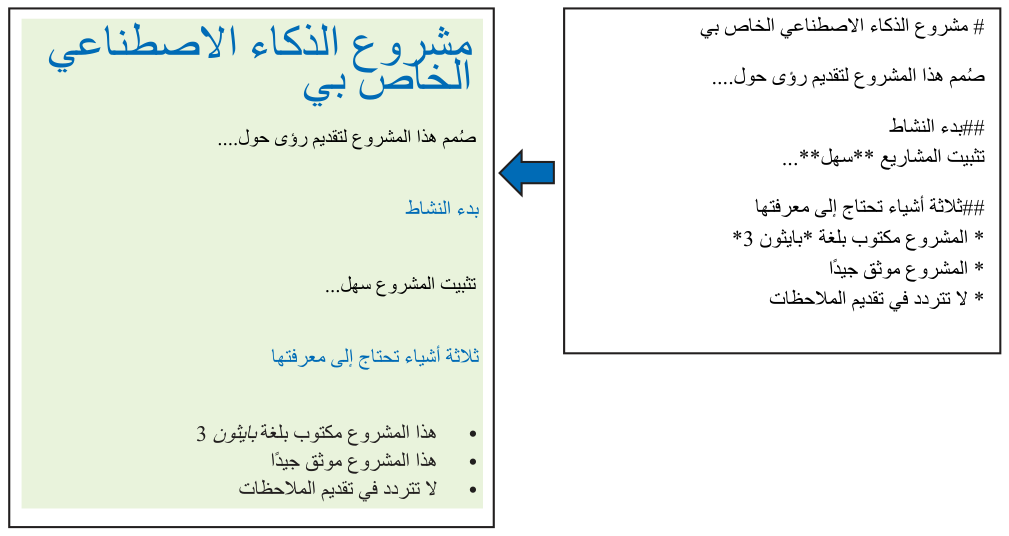
- سرد وملاحظات مكتوبة بلغة Markdown. Markdown هي لغة ترميز خفيفة الوزن (دون علامات) تُستخدم لتنسيق مستندات النص العادي، وغالبًا ما تُستخدم لملفات (README) والوثائق والمدونات وما إلى ذلك. يوضح الشكل 21.53 لغة Markdown ومخرجاتها. كما ترى، فإن تعلمها أسهل بكثير من تعلم HTML.
- كود البرنامج القابل للتنفيذ (على سبيل المثال، بايثون، R، وما إلى ذلك).
- مخرجات تفاعلية في شكل صور (على سبيل المثال، مخططات ورسوم بيانية)، ومقاطع فيديو، وLaTeX (نظام تنضيد يستخدم لإنشاء المستندات، وهو شائع لدى الأشخاص الذين يقومون بالبحث العلمي أو الأكاديمي أو الكتابة الفنية أو النشر)، وHTML المخصص (لغة ترميز النص التشعبي) - لغة تستخدم لإنشاء محتوى صفحة الويب.
يمكن النقر فوق كل خلية ثم تحريرها أو حذفها أو حتى إعادة تسلسلها. بمجرد إعادة تشغيل الخلية، يتم تحديث الخلية الناتجة (على سبيل المثال، إخراج قيمة متغيرة أو إعادة رسم المخطط الناتج). في أي نقطة، يمكن نقل الخلايا لأعلى أو لأسفل دفتر الملاحظات، وتغيير الترتيب الفعلي لتنفيذ الأكواد. ويمكن حفظ دفاتر الملاحظات هذه محليًا أو وضعها في VCS (أنظمة التحكم في الإصدار) للتعاون أو حتى مشاركتها عبر الإنترنت عبر البريد الإلكتروني والمنتديات وما إلى ذلك. التنسيق الأساسي لملفات ".ipynb" الناتجة هو JSON، لذا فهي قابلة للنقل بشكل كبير عبر الأنظمة والتطبيقات المختلفة. هذا المستوى من التفاعل والوصول الفوري إلى النتائج والقدرة على تعديل الكود (وترتيبه) يجعل Jupyter Notebook أداة شائعة بشكل استثنائي ومستخدمة عالميًا لبدء المشاريع المتعلقة بالذكاء الاصطناعي.
276 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
مشروع الذكاء الاصطناعي الخاص بي
صمم هذا المشروع لتقديم رؤى حول....
بدء النشاط
تثبيت المشاريع سهل...
ثلاثة أشياء تحتاج إلى معرفتها
- المشروع مكتوب بلغة بايثون 3
- المشروع موثق جيدًا
- لا تتردد في تقديم الملاحظات
277 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
مثال عملي
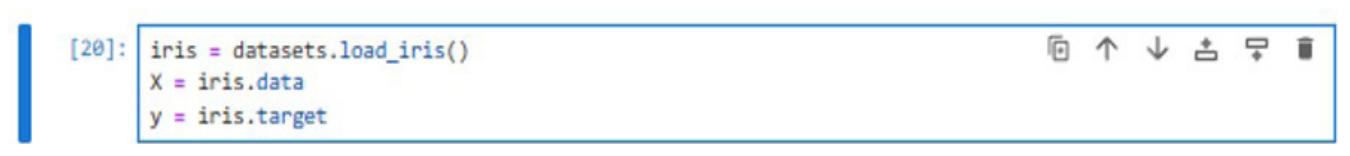
يوضح المثال الآتي استخدام دفتر Jupyter لاستكشاف تصنيف زهرة السوسن باستخدام خوارزمية التجميع K-means الخاصة بلغة scikit-learn.
المصطلح الرئيس
تمييز بناء الجملة - قدرة الأداة على تحليل لغة البرمجة وتمثيل الكلمات الرئيسة، والدوال، والعوامل، والرموز ذات الألوان المختلفة على الشاشة.
إبراز الأكواد البرمجية والقواعد النحوية
على الرغم من أن أدوات تطوير الأكواد القديمة كانت أحادية اللون بشكل صارم (تُعرض بصريًا باللونين الأسود والأبيض فقط)، فإن بيئات التطوير الحديثة (بما في ذلك Jupyter Notebook وMicrosoft VS Code، وما إلى ذلك) ومحررات النصوص الشهيرة (على سبيل المثال، Nano، وما إلى ذلك) تدعم جميعًا تمييز بناء الجملة للتخصيص. هناك العديد من الأسباب الجيدة لاستخدام تمييز الصيغة:
- يساعد المستخدم على التنقل في الكود.
- يعمل على تحسين قابلية قراءة الكود.
- يلبي احتياجات المستخدمين ذوي الإعاقات البصرية.
- يحسن فهم الكود.
- يساعد على تحديد الأخطاء في بناء الجملة أو المنطق الخاص بالكود.
- يقلل إجهاد العين.
278 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
مثال عملي
يظهر الكود في الشكل 21.57 إبراز كود للغة بايثون. الشكل 21.58 يوضح ما تشير إليه الألوان المختلفة.
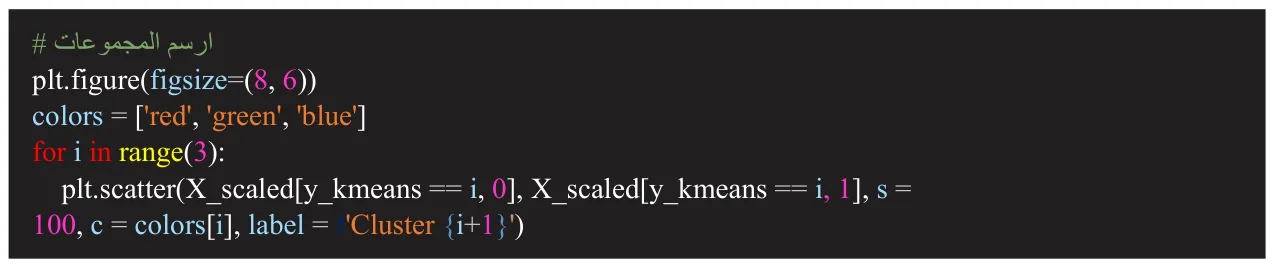
```python
ارسم المجموعات
plt.figure(figsize=(8, 6)) colors = ['red', 'green', 'blue'] for i in range(3): plt.scatter(Xscaled[ykmeans i, 0], Xscaled[ykmeans i, 1], s= 100, c = colors[i], label = 'Cluster {i+1}') ```
الشكل 21.57 إبراز كود بلغة بايثون، تم إنجازه أوتوماتيكيًا من خلال البرنامج المستخدم.
| أخضر | تعليق بايثون |
| أزرق | متغير أو مرجع بايثون |
| أصفر | دالة بايثون المدمجة |
| برتقالي | نصوص/سلاسل بايثون |
| أحمر | الكلمات المفتاحية في بايثون |
| وردي | الأعداد الصحيحة في بايثون |
| أبيض | الكائنات والأساليب في بايثون |
| أزرق داكن | الأحرف الخاصة في بايثون |
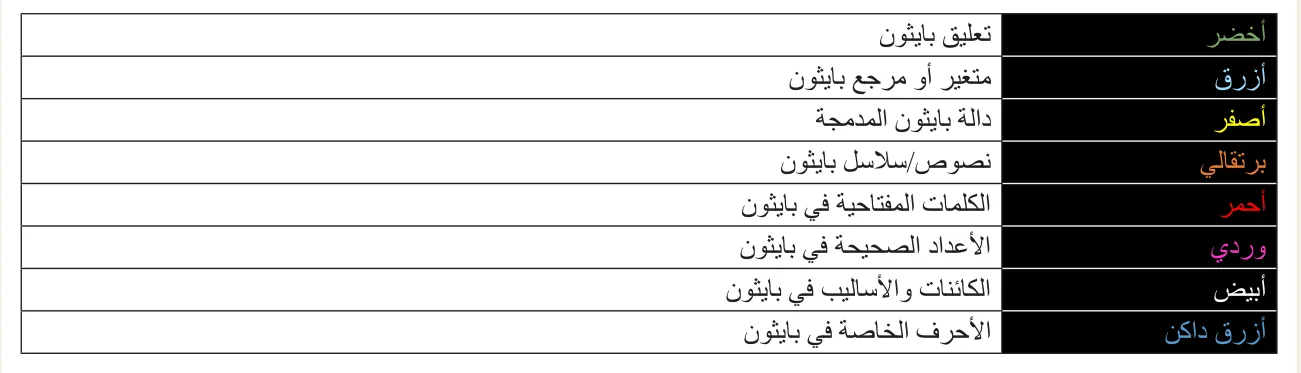
تجدر الإشارة إلى أن اللغات المختلفة تستخدم مفاتيح تلوين مختلفة وحتى خيارات لغة بايثون الموضحة في الشكل قد يتم تعديلها لتناسب التفضيلات الشخصية لكل متعلم.
تنفيذ الأكواد البرمجية
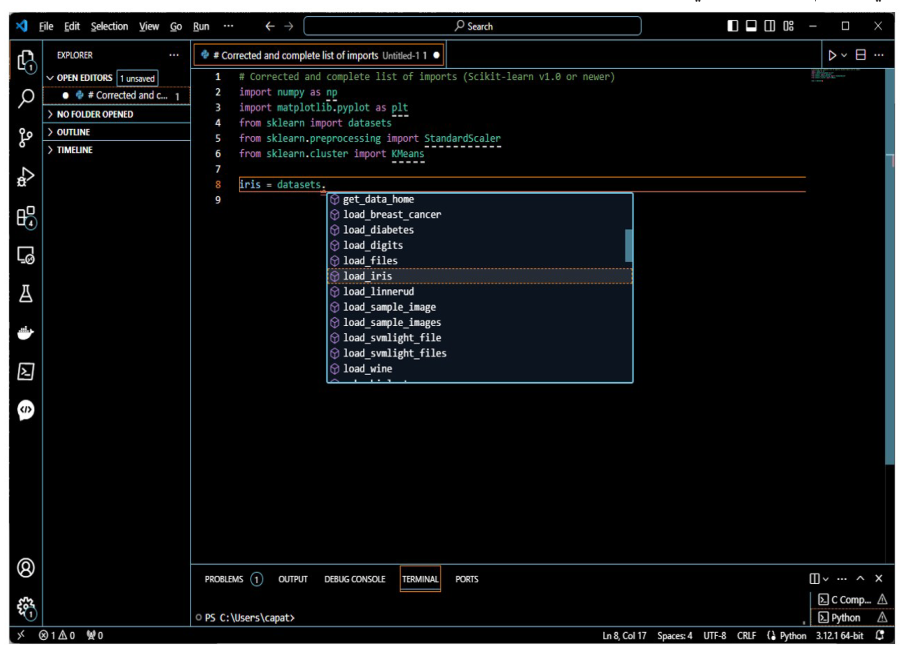
ميزة مفيدة في بيئات التطوير المتكاملة الحديثة (مثل PyCharm وMicrosoft VS Code وما إلى ذلك) هي مفهوم التنفيذ التلقائي للكود.
279 الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
هذه ميزة تقدم بشكل أساسي اقتراحات للمطور حول ما يمكنه كتابته بعد ذلك لإكمال سطر من كود البرنامج. وتقوم بذلك من خلال النظر إلى عنصر الكود الذي يتم التركيز عليه. ثم تعرض قائمة بالخيارات الممكنة التي يمكن للمطور الاختيار من بينها. يقلل بوضوح هذا النوع من الميزات العدد المحتمل للأخطاء التي يمكن أن يرتكبها المطور، ونتيجة لذلك، يجعل إنشاء الكود أسرع (ومضمونًا). قد تحتوي بعض بيئات التطوير المتكاملة (IDEs) أيضًا على وظائف محسنة توفرها الإضافات القابلة للتثبيت (مثل عميل متصفح الويب مثل Microsoft Edge أو Google Chrome). النوع الشائع هو رمز (co-pilot)، وهو ملحق يستخدم الذكاء الاصطناعي لتقديم اقتراحات حول كيفية حل مهام البرمجة الشائعة. كما هو الحال مع جميع المحتويات التي يتم إنشاؤها بواسطة الذكاء الاصطناعي، يجب فحص المحتوى بدقة قبل الاستخدام، حيث يمكن أن تختلف جودة النتائج بين الجيدة وغير القابلة للعمل بشكل عام (أو تحتوي على أخطاء).
المترجم الشفوي / المترجم الإلكتروني
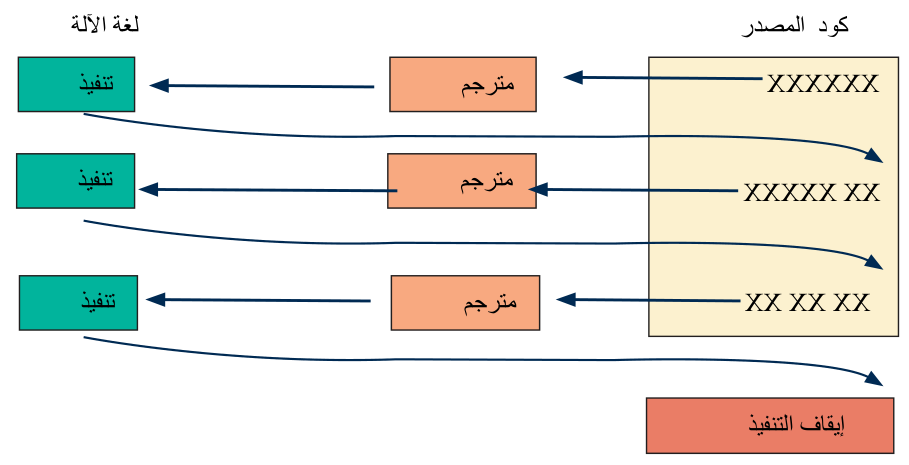
في النهاية، يمكن لوحدة المعالجة المركزية (CPU) تنفيذ تلك الأكواد الآلية الثانية فقط التي تفهمها تمامًا. يجب أولاً ترجمة أي كود برنامج تكتبه، سواء كان بايثون أو R أو جافا، إلى كود الجهاز قبل تشغيله. هناك أشكال مختلفة للترجمة الممكنة. ربما يكون الشكلان الأكثر شيوعًا للترجمة هما التفسير والتجميع (كما هو موضح أدناه). لكل منها مزاياها وعيوبها. قد تستخدم بعض اللغات، في الواقع، مزيجًا من كلا الأسلوبين.
التفسير
المترجم هو ببساطة برنامج للمساعدة يأخذ رمز المصدر (كود البرنامج المكتوب) سطرًا واحدًا في كل مرة، ويترجمه إلى لغة الآلة وينفذه.
إذا واجه سطرًا لا يمكنه تفسيره بنجاح، فإنه (يتعطل) ويبلغ عن خطأ في بناء الجملة. وإلا، تستمر العملية حتى يتم تفسير جميع الأسطر وتنفيذها بنجاح. غالبًا ما تكون عملية التفسير بطيئة (نسبيًا) ولديها (مقارنة بالتجميع) فرصة ضئيلة للتحسين (أي لاتخاذ أي اختصارات لتوفير الوقت تعمل على تحسين وقت التنفيذ أو كفاءة الذاكرة).
نتاج التعلم ج
يعتبر بايثون، ليسب وR لغات مفسرة بشكل عام، على الرغم من أن الأولى تُترجم فعليًا إلى بايت كود بايثون أولًا (في المرحلة الوسيطة) قبل أن ينفذها مفسر بايثون - ما يسمح بإدخال مستوى من التحسين الأساسي.
تجميع
في التجميع، يتم استخدام زوج من الأدوات - المترجم والموصل - لترجمة كود البرنامج بأكمله إلى لغة الآلة لوحدة المعالجة المركزية المستهدفة وإنشاء ملف تنفيذي مستقل. الميزة الأساسية لهذه التقنية هي أن المترجم يمكنه 'رؤية' ومعالجة رمز المصدر للبرنامج بأكمله دفعة واحدة بدلًا من سطر بسطر. ونتيجة لذلك، فلديها فرصة لتحقيق تحسين كبير في الكود الناتج، بمجرد إنتاج الكود القابل للتنفيذ، يمكن استخدامه وتوزيعه على الآخرين دون الكشف عن كود المصدر الأصلي.
تجدر الإشارة إلى أنه في حالة مواجهة أي أخطاء في بناء الجملة في أثناء الترجمة، تتوقف العملية (دون إنتاج ملف تنفيذي) ويجب تصحيح الرموز البرمجية بنجاح قبل محاولة إعادة التحويل البرمجي. قارن هذا بالكود المفسر الذي ينفذ (سطرًا بسطر) حتى يحدث خطأ. اللغات المترجمة الشائعة هي فورتران وجافا، على الرغم من أنه في حالة جافا يتم ترجمة الكود إلى جافا بايت كود (مجموعة أخرى من التعليمات المحايدة للمعالج) ثم يتم تفسيرها بواسطة آلة جافا الافتراضية (JVM) التي تعمل على جهاز الحاسب المستهدف. وتجدر الإشارة أيضًا إلى أن بعض لغات البرمجة قد تتم مواجهتها في أشكال مفسرة أو مجمعة. ليسب مثال جيد على ذلك.
تصحيح الأخطاء
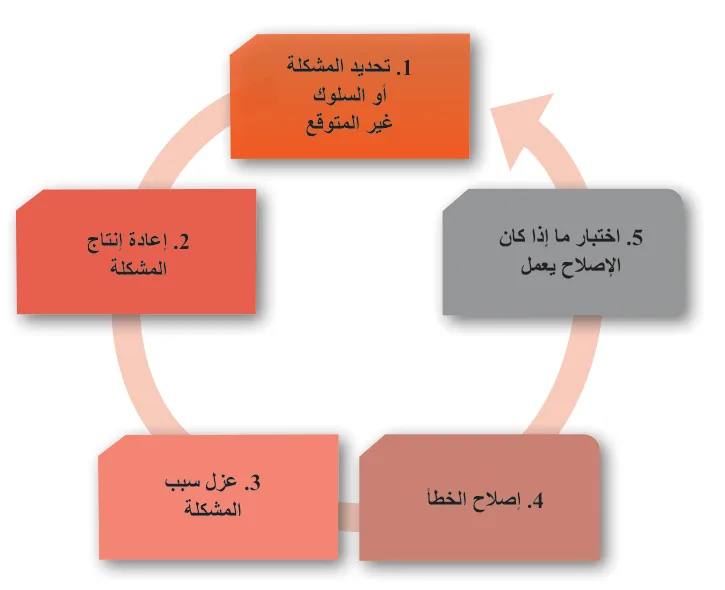
غالبًا ما يكون العثور على "الأخطاء" وتصحيحها (تصحيح الأخطاء) أمرًا صعبًا في البداية، لكنه عادة ما يصبح أسهل بمجرد أن تصبح لغة البرمجة المستخدمة مألوفة. قد يصعب للغاية تحديد موقع بعض الأخطاء وربما يصعب حلها، فغالبًا ما تتطلب هذه العملية قدرًا كبيرًا من الصبر والانضباط والاهتمام بالتفاصيل، ويمكن أن تعود وجهة النظر المختلفة التي يقدمها الزملاء بفائدة كبيرة في تحديد الخطأ وإصلاحه. تصحيح الأخطاء هو في الأساس عملية من خمس مراحل (كما هو موضح في الشكل 21.62).
المهارات المعرفية: العمليات والاستراتيجيات المعرفية:
- حل المشكلات
مهارات التواصل الشخصي: أخلاقيات العمل/الضمير:
- المسؤولية
- الإنتاجية
تصحيح الأخطاء - عملية تحديد الأخطاء أو العيوب (غالبًا ما يشار إليها بالأخطاء) في رمز البرنامج وإصلاحها بنجاح.
وقفة للتفكير
يتم تجميع بعض أخطاء الأكواد البرمجية ولكنها تعطي مخرجات غير صحيحة. لماذا يحدث ذلك؟ تلميح فكر في سطور الأكواد البرمجية حيث توجد التحديدات والتكرارات. توسيع الأفق ما الذي يجب فعله لاكتشاف هذه الأخطاء؟ اكتب خمس اقتراحات.
منصة إدارة الأكواد
مشاريع الذكاء الاصطناعي كبيرة جدًا بحيث لا يمكن لمطور واحد فقط العمل عليها. للسماح للعديد من المطورين بالمساهمة في مشروع، من المحتم استخدام نوع ما من منصات إدارة الكود. تسمح منصة إدارة الرموز البرمجية لفريق من المطورين بما يأتي:
- تخزين قاعدة الشفرة الخاصة بهم بطريقة آمنة ومضمونة
- إدارة وتأمين قاعدة الأكواد البرمجية الخاصة بهم (أو المستودع)
- التعاون بطريقة منهجية مع قاعدة البيانات
- تتبع التغييرات التي تم إجراؤها على قاعدة الأكواد البرمجية، استنادًا إلى التاريخ/الوقت/الوقت والغرض والتأليف (توفير شكل من أشكال التحكم في الإصدار)
- دعم فروع متعددة من التطوير الموازي والتجريبي
- مراقبة المشكلات والأخطاء وطلبات الميزات - ما يسمح للفرق بتنظيم وترتيب أولويات أعباء عملهم في مدة زمنية معينة (أو سباق).
Git - نظام تحكم في الإصدارات (VCS) أنشأه لينوس تورفالدس (مبتكر نواة لينكس) في عام 2005 وصدر بوصفه أحد البرامج مفتوحة المصدر بموجب رخصة GNU GPL v2.
منصة إدارة الأكواد الشهيرة هي Git، وحتى وقت كتابة هذا الكتاب، ما تزال Git تعتبر نظام التحكم في الإصدارات (VCS) الأكثر شهرة في العالم. يتوفر واجهات وخدمات ويب إضافية لـ Git عن طريق منصات مثل: GitLab وGitHub وما إلى ذلك، وتسمح هذه الأمور بتثبيت Git محليًا على أجهزة المطورين. وهذا بدوره يسمح للمطورين بدفع (التزامات) الكود إلى مستودع بعيد لقاعدة الأكواد البرمجية الخاصة بهم وسحب التغييرات منه. يتم تقسيم أي مشكلة في Git إلى ثلاث مناطق منفصلة:
- دليل العمل/الشجرة
- الفهرس أو منطقة التدريج
- مستودع Git.
توجد هذه المناطق عادةً على حاسوب المطور. عندما يبدأ المطور، يعتبر دليل العمل (نظيفًا). عندما يقوم المطور بإضافة الأصول أو حذفها أو تعديلها، تتغير حالة الشجرة لدليل العمل. يتم تعقب هذه التغييرات (يعرف Git عنها) أو يتم إلغاء تتبعها (لا يعرف Git عنها).
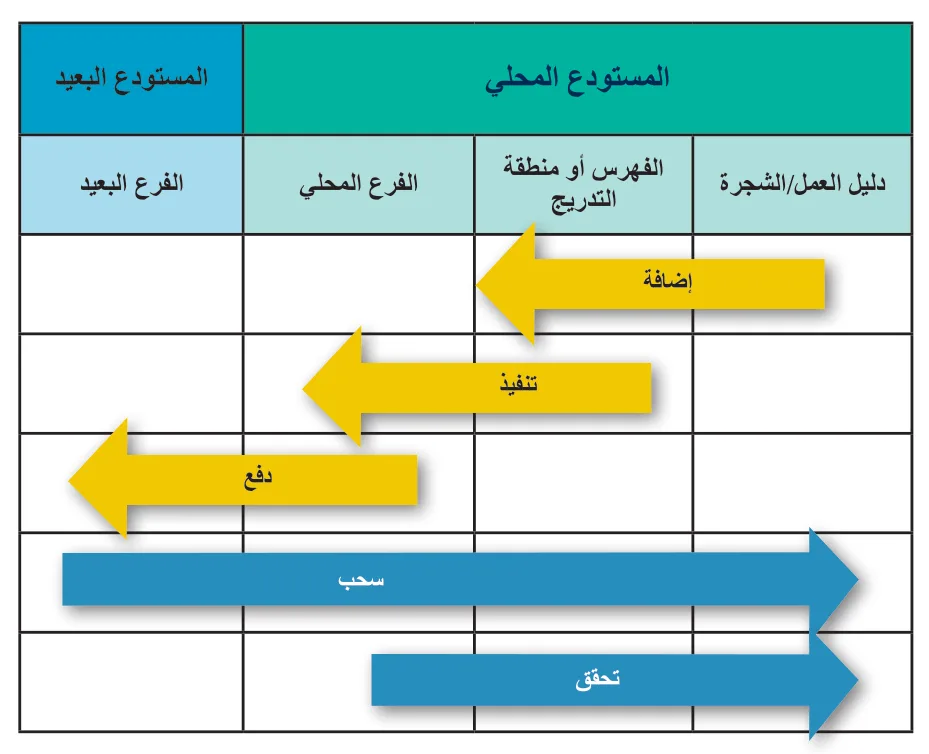
يؤدي استخدام الأمر 'git add' إلى نقل الملف المعدل إلى منطقة التدريج. يتم استخدام الأمر (git commit) لتنفيذ التغييرات المتعقبة على مستودع Git المحلي. من أفضل الممارسات تضمين تعليق وصفي مناسب إلى جانب الالتزام الذي يتعلق بالغرض منه. بمجرد إجراء التغييرات على المستودع المحلي، يمكن استخدام أمر (git push) آخر لمشاركة/تحميل التغييرات إلى المستودع البعيد. بمجرد قبول تغييرات المطور، يمكن للآخرين جلب هذه التغييرات أو سحبها إلى أجهزتهم المحلية، مع تحديث نسختهم من قاعدة الأكواد البرمجية. تعارضات الدمج شائعة. تحدث هذه عادةً عندما يقوم العديد من المطورين بإجراء تغييرات متناقضة على الأجزاء نفسها من قاعدة الأكواد البرمجية. عادةً ما يقوم مالك قاعدة الأكواد البرمجية بحل هذه المشكلات. ومع ذلك، لتجنبها تمامًا، يُنصح المطورون بالالتزام (قليلًا وفي كثير من الأحيان). قد تحتوي المشاريع أيضًا على فروع متعددة - اعتبرها بمنزلة تفرعات مختلفة (مثل V2، أو 2.1)؟ عندما تعمل في المجال، من المتوقع أن تتمكن من استعادة الإصدارات السابقة من الأكواد البرمجية التي كتبتها. ابدأ التفكير الآن في كيفية استخدام التحكم في الإصدار في أنشطة البرمجة المستقبلية.
فكّر مليًا
فكر في برامج الحاسب التي كتبتها، ثم قمت بتصحيحها ثم ربما أعدت كتابتها. هل سبق لك أن أردت العودة إلى إصدار سابق لأن شيئًا ما كان يعمل لم يعد يعمل؟ هل تحفظ برامجك المعدلة باسم جديد، أم بالاسم ورقم الإصدار نفسه (مثل V2، أو 2.1)؟ عندما تعمل في المجال، من المتوقع أن تتمكن من استعادة الإصدارات السابقة من الأكواد البرمجية التي كتبتها.
الحوسبة السحابية لتوفير موارد قابلة للتطوير للتخزين ومعالجة البيانات يمكن إجراء مشروع الذكاء الاصطناعي وتجارب التعلم الآلي الأساسية بنجاح داخل الحدود المادية للمنظمة (أي 'في الموقع'). ومع ذلك، فمن الشائع أن تبحث المؤسسات عن بيئات عبر الإنترنت يمكن فيها بناء أنظمة الذكاء الاصطناعي الخاصة بها واختبارها ونشرها. هذا يسمح لهم بالاستفادة من منصات الحوسبة السحابية ذات التكلفة الإجمالية للملكية (TCO) المنخفضة والمرنة مثل:
- خدمات أمازون ويب (AWS)
- منصة جوجل السحابية (GCP)
- Microsoft Azure.
الميزة الأساسية التي توفرها هذه المنصات هي قابلية التوسع السريع - أفقيًا (إضافة المزيد من الحوسبة) وعموديًا (حوسبة ذات موارد ذات موارد أفضل، أي وحدة معالجة وحدة معالجة رسومات أسرع، والمزيد من ذاكرة الوصول العشوائي، وما إلى ذلك). تتناسب هذه القابلية للتوسع مع الطبيعة الديناميكية لطلبات خدمات الذكاء الاصطناعي المتزايدة. بالإضافة إلى ذلك، يوفر معظم موفري السحابة أدوات وخدمات محددة للذكاء الاصطناعي والتعلم الآلي يمكن استخدامها معًا لتصميم وبناء ونشر حلول كاملة.
هذه مجموعة من الخدمات المعتمدة على السحابة والتي تتضمن ما يأتي:
- تضيف خدمات Azure المعرفية الرؤية واللغة والكلام واتخاذ القرار إلى التطبيقات.
- يتم استخدام التعلم الآلي من Azure لتطوير نماذج التعلم الآلي وتدريبها ونشرها في نطاق واسع.
- تُستخدم خدمات الروبوتات في Azure لبناء ونشر مساعدات روبوتية ذكية يمكنها التفاعل مع المستخدمين عبر قنوات اتصال مختلفة (على سبيل المثال، الدردشة، البريد الإلكتروني، وما إلى ذلك).
منصة جوجل للذكاء الاصطناعي
هذه مجموعة احترافية من الأدوات لتطوير التعلم الآلي ونشره وتتضمن ما يأتي:
- يتم استخدام دفاتر منصة الذكاء الاصطناعي مع مكتبات وأدوات التعلم الآلي المتكاملة.
- تدريب منصة الذكاء الاصطناعي هي خدمة تساعد في تدريب نماذج التعلم الآلي في نطاق واسع.
- تنبؤات منصة الذكاء الاصطناعي هي خدمة مدارة لنشر وتقديم نماذج التعلم الآلي المختلفة لديها القدرة على تتبع ومراقبة النماذج بدقة.
- حلول الذكاء الاصطناعي المبنية مسبقًا هي نماذج أو أطر أو تطبيقات جاهزة للاستخدام مقدمة من Google.
أمازون سيج ميكر
هذه خدمة AWS مدارة بالكامل وتوفر مجموعة الأدوات الشاملة الآتية:
- يتم استخدام مثيلات Jupyter Notebook مع مكتبات وأدوات التعلم الآلي المتكاملة.
- الخوارزميات المحسنة المضمنة هي مجموعة من الخوارزميات المصممة والمحسنة للغاية التي تحل مشكلات التعلم الآلي الشائعة.
- يوفر تدريب النماذج تدريبًا فعالًا ويضبط النماذج، ما يبسط خطوات العمل مع الخوارزميات ومجموعات البيانات المختلفة.
- يوفر نشر النموذج نقلًا سهلًا للنماذج المدربة إلى بيئة الإنتاج (أي بيئة 'حية' ومواجهة للعملاء)، ويدعم إصدارات مختلفة، وخيارات التوسع التلقائي، وما إلى ذلك.
- توفر مراقبة النماذج وإدارتها أدوات تمنح المطورين القدرة على تتبع المقاييس الرئيسية مثل الدقة والانحراف.
الأهم من ذلك، أن جميع هذه الأدوات والخدمات تتكامل بشكل جيد مع خدمات السحابة الأخرى مثل تخزين البيانات، استضافة الويب، الأمان، التسجيل والمراقبة. وبعبارة أخرى، فإنها توفر حزمة ذكاء اصطناعي كاملة جدًا باستراتيجية "الدفع أولًا بأول" (أي أن العميل يدفع فقط مقابل الحوسبة والخدمات التي يستخدمها فعليًا، مع توسيع نطاقها وتقليصها بحسب الحاجة، بدلًا من دفع مبلغ ثابت مقدمًا).
الحوسبة - هي مصطلح يستخدمه مقدمو السحابة للإشارة إلى الموارد والإمكانيات اللازمة لمعالجة المهام أو إدارة أعباء العمل في بيئة تعتمد على السحابة، وعادةً ما يتضمن قوة المعالجة (وحدة المعالجة المركزية)، والذاكرة (ذاكرة الوصول العشوائي)، وتخزين القرص وقدرات الشبكة.
تمرين تقييمي 21.3
أنت تعمل لصالح مدير مشروع الذكاء الاصطناعي الذي طلب منك تطوير حل ذكاء اصطناعي لتلبية احتياجات العميل المحددة. باستخدام البيانات التي تم الحصول عليها في دراسة الحالة والتي أعدت في التمرين التقييمي 21.2، نفذ المهمة الآتية لتطوير حل الذكاء الاصطناعي: استفسرت سلطات إدارة المطار عما إذا كان من الممكن تحليل البيانات وتدريب نموذج الذكاء الاصطناعي بنجاح بحيث يمكن التنبؤ بالتأخيرات المحتملة في المستقبل. ستحتاج إلى:
- تطوير حل الذكاء الاصطناعي باستخدام لغة برمجة وأدوات حوسبة مناسبة
- اختبار حل الذكاء الاصطناعي وتحسينه
- تقييم فعالية حل الذكاء الاصطناعي
هذه معاينة من الدرس. أكمل القراءة في التطبيق