
شرح الموضوع
تعرّف التعلم الآلي وخوارزميات التعلم الآلي المختلفة وخطوات بناء نموذج التعلم الآلي وتقييمه، إضافة إلى تعرّف طبيعة المشكلات التي يُمكن حلها بالتعلم الآلي، وكيفية بناء نظام تعلم آلي باستخدام أدوات محددة.
نتاجات التعلم
- أعرف أنظمة التعلم الآلي.
- أبني نموذجا للتعلم الآلي باستخدام الأدوات الجاهزة.
- أذكر بعضا من الأدوات الجاهزة للتعلم الآلي.
- أوضح خوارزميات التعلم الآلي.
- أبني نموذجا للتعلم الآلي باستخدام لغة بايثون.
تعلّم الآلة: حاسوب يتعلم من الأمثلة
تعمل الأنظمة الخبيرة بشكل جيد في المجالات التي تكون فيها القواعد واضحة والمعرفة ثابتة. أما في حال تغيرت المعرفة أو القواعد، فإن هذه الأنظمة ستحتاج إلى تعديل من قبل الخبير البشري بشكل يدوي ودوري، إن هذه الآلية للتعديل غير فعالة في المجالات التي تتغير فيها المعرفة بشكل سريع.
أتعاون مع زملائي في المجموعة لتحديد مشكلات يمكن حلّها باستخدام أنظمة خبيرة قادرة على تصنيف الأشياء. ثم أجيب عن الأسئلة الآتية؛ هل من السهل للأنظمة أن تقدرَ على تصنيف الأشياء بمجرد التعرض لعدد من الأمثلة؟ أم أنها تحتاج إلى معلومات إضافية؟ أفكر في الإجابة، وأدوّن الأفكار لمشاركتها مع الزملاء.
أبحث في المصادر الإلكترونية الموثوقة عن العناصر التي يجب توافرها في نظام، يمكنه حل المشكلات باستخدام تقنيات تعلم الآلة. أدوّن ما أتوصل إليه وأشاركه مع زملائي.
تعلم الآلة
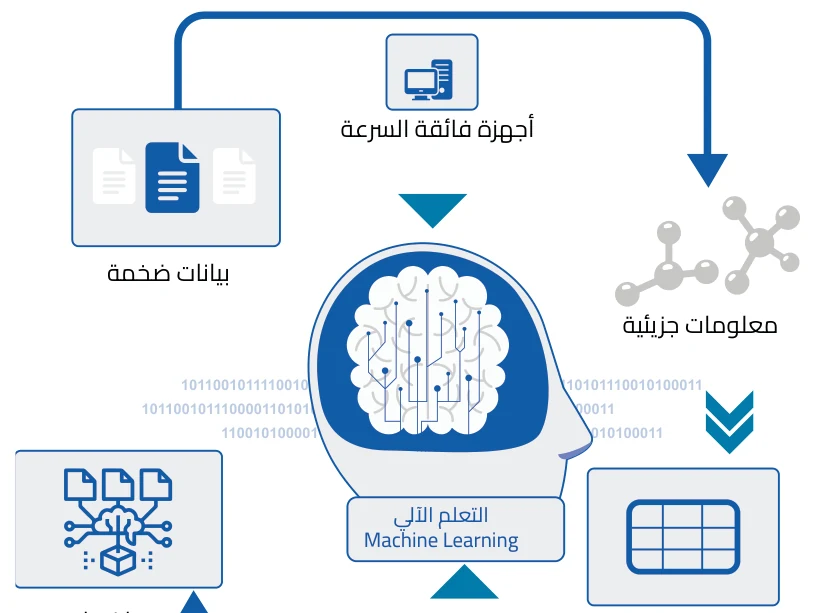
- يتوافر في وقتنا الحالي كمّ هائل من البيانات، تولدت بسبب الانتشار الكبير للأجهزة الرقمية، وإنترنت الأشياء والتجارة الرقمية، ووسائل التواصل الاجتماعي، وغيرها الكثير من المصادر.
- وتقدّر كمية المعلومات المولّدة يوميا بـ 2.5 Quintillion Bytes. هذه المعلومات بحاجة إلى تحليل ودراسة؛ لتصبح ذات معنى، ويُمكن توظيف مخرجاتها في صنع القرارات.
فكيف نجعل الحاسوب يتعلم بنفسه من هذه البيانات؟
- نستطيع القول إن برنامجا معينا لديه القدرة على التعلم؛ إذا كان تعريضه لعدد أكثر من الأمثلة في مسألة معينه يؤدي إلى تحسين أدائه وفق معايير قياس محدده.
متطلبات بناء نموذج التعلم الآلي
ماذا نحتاج لنبني نموذجًا فعّالًا؟
لنتمكن من تطوير نماذج فعالة باستخدام تعلم الآلة، فيجب توافر مجموعة من العناصر وهي:
- البيانات الضخمة (Big Data):** تؤدي البيانات دورا كبيرا في تكوين أنظمة دقيقة لديها نظرة شمولية؛ لذلك نحتاج إلى كمية كبيرة من البيانات المتعلقة بالمشكلة التي نحاول حلها. أيضا يجب أن تكون البيانات دقيقة وخالية من الضوضاء والأخطاء.
- توجد طريقتان لجمع البيانات، يدويا وأوتوماتيكيا.
- وبشكل عام عندما يكون لدينا ملف يحتوي على بيانات كبيرة، يجب اختيار الخصائص بعناية؛ فيجب أن نختار خصائص مميزة، ولها تأثير أكبر في النتائج.
- كل مشكله لها حل مختلف، وطريقة الوصول إلى الحل تغير دقة النموذج (Model) النهائي وأداءه وحجمه.
- يعتمد كل شيء على البيانات المعطاة، فإذا قدمت بيانات خاطئة وغير دقيقه أو غير صحيحه، فلن تستطيع أي خوارزمية إيجاد أفضل نموذج لها.
- أجهزة فائقة السرعة والذاكرة: حتى تتمكن الخوارزميات من تطوير نماذج ذات دقة عالية، فإنها تحتاج إلى تحليل البيانات الكبيرة. هذا يتطلب مصادر لديها قدرات حسابية عالية من ناحية السرعة وسعة الذاكرة.
أبحث وأناقش
أبحث في المواقع الإلكترونية الموثوقة عن الفرق بين التعلّم الآلي والذكاء الاصطناعي، وأنظّم المعلومات في مستند Google Docs. ثم أشارك النتائج مع الزملاء.
أنواع خوارزميات التعلّم الآلي
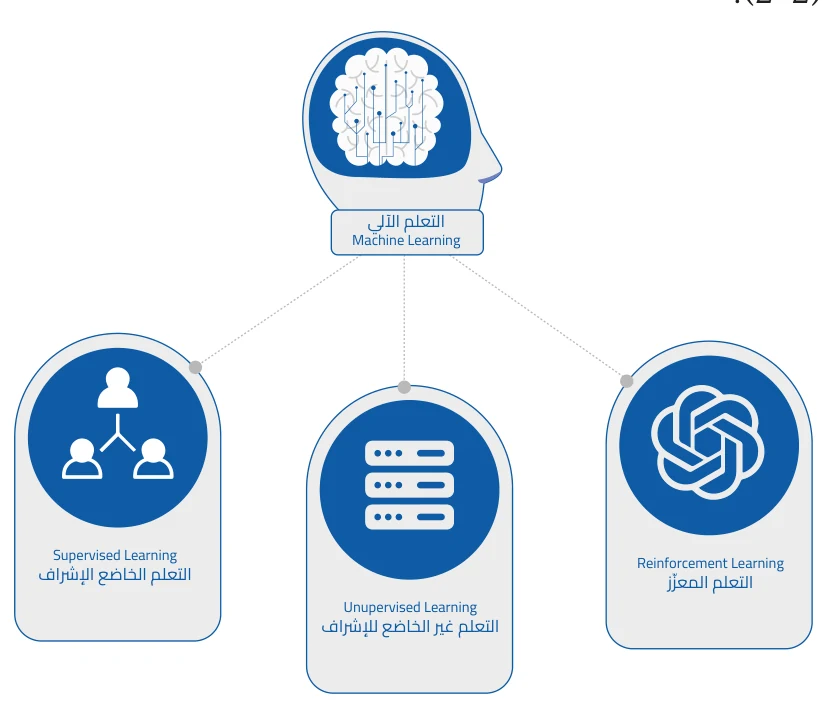
ثلاثة أنواع، ولكل نوع طريقته في التعلم
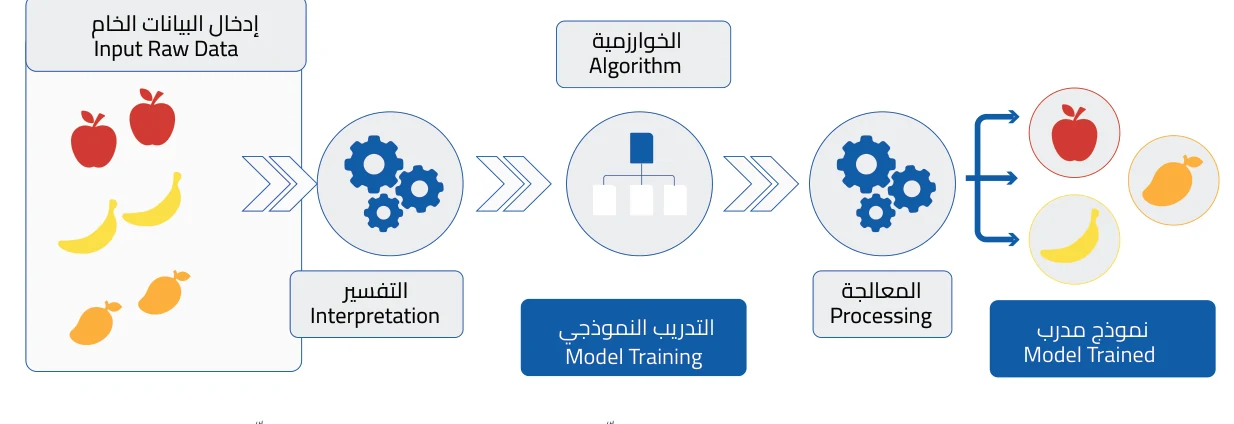
- يمكن تصنيف خوارزميات تعلّم الآلة إلى فئات عدّة وفقاً لطبيعة التعلّم وطريقة عملها كما هو مبين في الشكل (2-2).
1. التعلّم الخاضع للإشراف
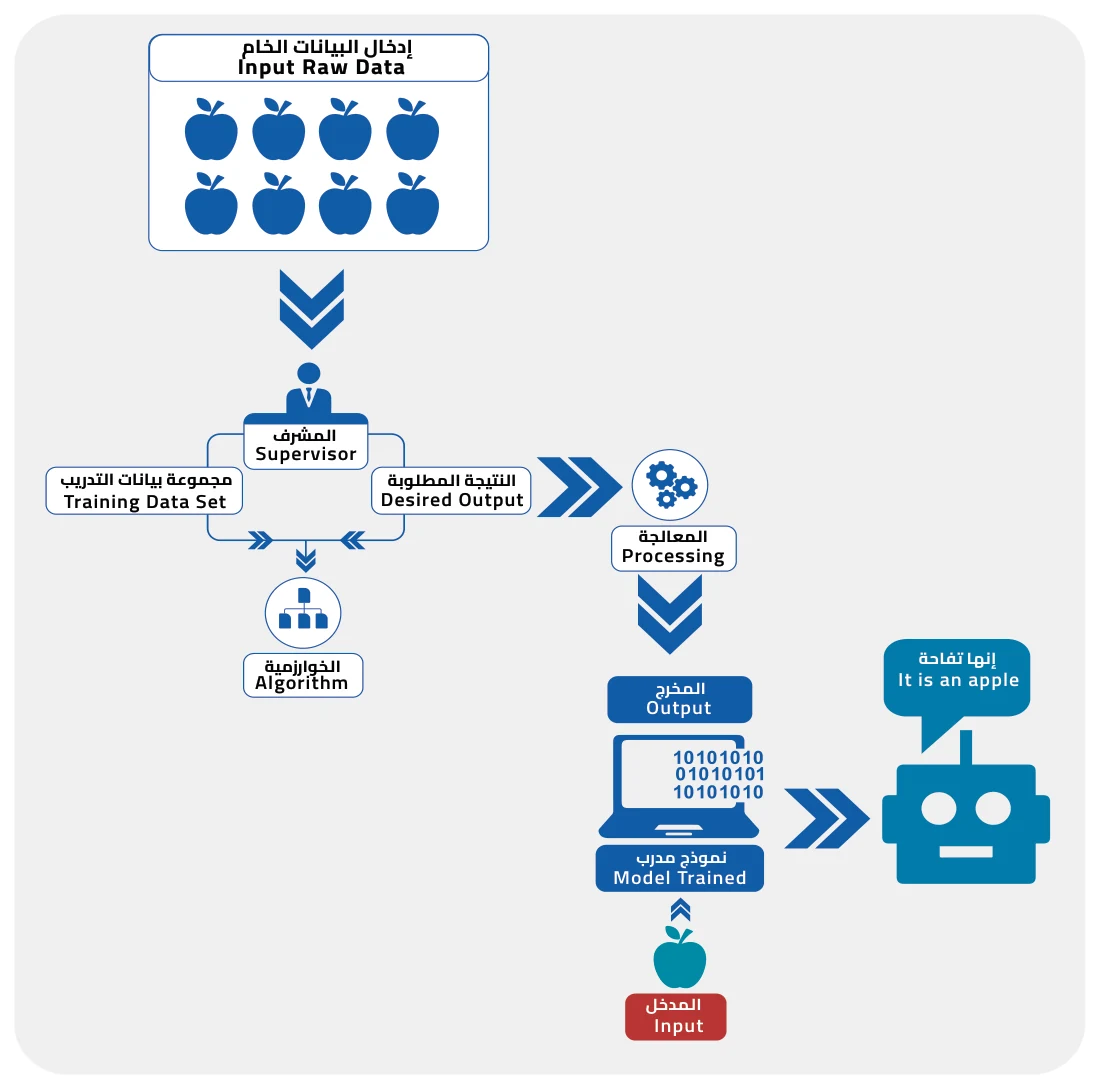
- فعلى سبيل المثال إذا أردنا تطوير نموذج آلي لتشخيص مرض معين، فإن البيانات بهذه الحالة تشمل الفحوصات الطبية للمريض، بالإضافة إلى وسم لكل عينة تبيّن هل هو مصاب بالمرض أم لا.
- بعد الانتهاء من التدريب نتوقع من النموذج إعطاء تشخيص لمريض جديد بناءً على الفحوصات الطبية فقط.
أفكّر وأشارك
أفكر مع زملائي في المجموعة في أمثلة للتعلّم الخاضع للإشراف، يمكن تطبيقها في الحياة مع ذكر طبيعة الوسم لكلّ منها. وأشارك ما نتوصل إليه من أفكار مع المجموعات الأخرى.
التصنيف والانحدار: وسم منفصل أم مستمر؟
بناءً على طبيعة المعلومات الموجودة بالوسم، يمكنُ تصنيف نماذج التعلّم الخاضع للإشراف إلى قسمين، هما:
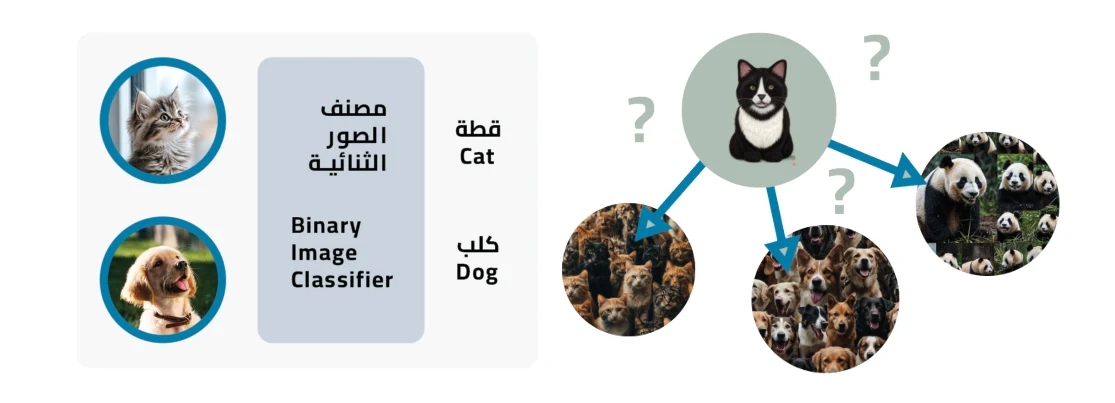
- على سبيل المثال، فإن تحديد ما إذا كان المريض مصابًا أم لا، أو إذا كان الإيميل غير مرغوب فيه أو مرغوب فيه، أو تحديد نوع الفاكهة الموجودة في الصورة ما إذا كانت موزًا أو تفاحًا أو برتقالًا، هي مشكلات تصنيفية تحتاج إلى نموذج تصنيف.
التصنيف
- على سبيل المثال، تحديد سعر المنزل، أو توقع درجة الحرارة بناءً على مجموعة من الظروف الجوية.
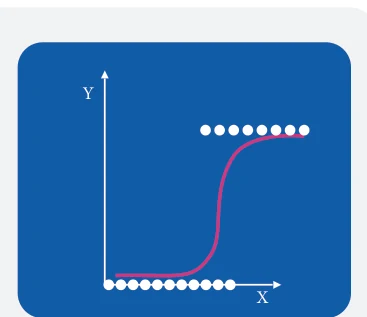
وما الخوارزميات التي تبني هذه النماذج؟
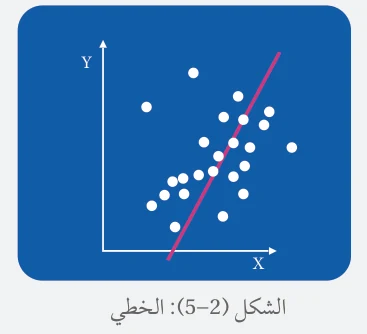
الانحدار الخطي
الانحدار اللوجستي
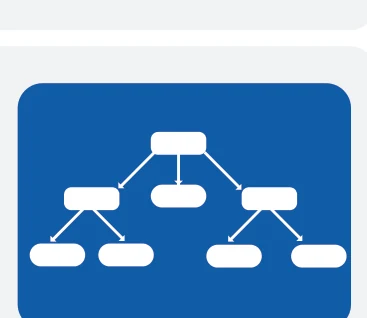
أشجار القرار
- كل عقدة في الشجرة تمثل اختبارًا على قيمة مدخل معين، والفروع تمثل نتائج هذا الاختبار، والأوراق تمثل المخرجات.
- يبين الشكل (7-2) شجرة القرار لإيجاد احتمال تعرّض شخص لصدمة قلبية.
أحلل وأصنف
أتعاون مع زملائي في المجموعة لتحليل الحالات الآتية، واختيار نموذج التعلّم الخاضع للإشراف لكل منها. تصنيف الطلبة بناءً على أدائهم الأكاديمي. توقع قبول الطلبة في برنامج جامعي. التعرّف إلى الخطوط المكتوبة باليد. التعرّف إلى الوجوه.
2. التعلّم غير الخاضع للإشراف
بيانات بلا وسم: الحاسوب يكتشف الأنماط بنفسه
- ويُستخدمُ عندما تكون البيانات غير موسومة أو غير مهيكلة، ويهدف إلى فهم العلاقات الداخلية في البيانات.
- تساعد تقنيات التعلّم غير الخاضع للإشراف على الاستفادة من البيانات غير الموسومة التي يحتاج وسمها إلى جهد بشريّ كبير من مختصين بالمجال.
- تساعدنا خوارزميات التجميع في تحليل البيانات، وتصميم أنظمة التوصية (Recommended Systems)، وعمل محركات البحث (Search Engines)، وتسهيل عملية وسم كميات كبيرة من المعلومات (Semi-Supervised Learning)، كما هو مبين في الشكل (2-12).
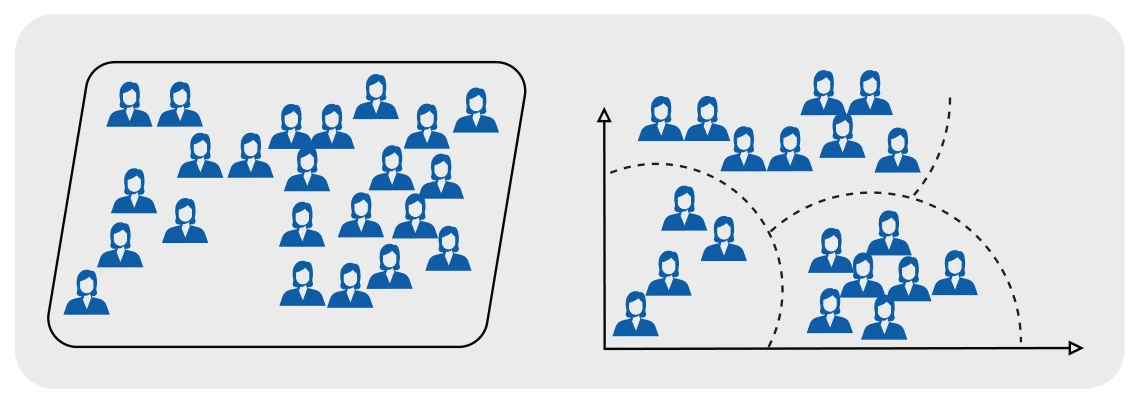
- وتساعد خوارزميات تقليل الأبعاد في تمثيل البيانات في بعدين أو ثلاثة؛ لتسهيل عرضها ورؤية الهيكل العام للبيانات والتكتّلات إن وجدت.
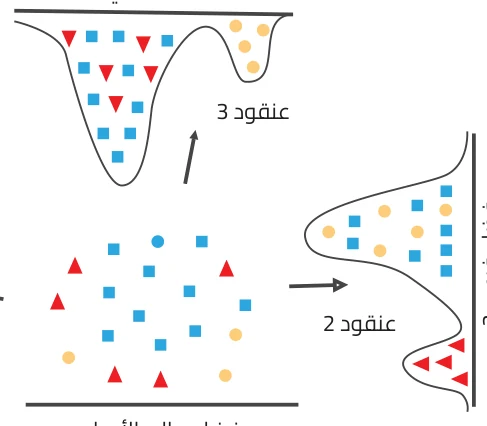
- وخوارزميات مثل PCA (تحليل المكونات الرئيسية) من أكثر الأساليب شيوعاً في هذا المجال.
- وكما يظهر في الشكل (2-13)، تُمثّل البيانات في فضاء عالي الأبعاد، وتُقلّص لعرضها في فضاء فرعي.
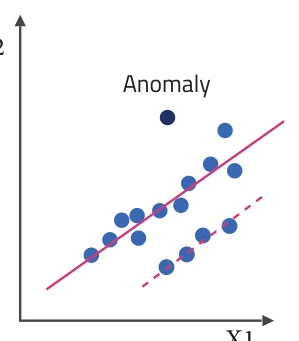
- اكتشاف القيم المتطرفة أو الشاذة (Detection of Outliers or Anomalies)
- يتمثّل اكتشاف القيم المتطرفة في الكشف عن محاولات الاحتيال وخاصة عند رصد تصرُّفات غير عادية، أو اكتشاف العينات التي بها عيوب، ومن ثمَّ تعمل على تنقية البيانات من هذه القيم التي قد تؤثر في جودة النماذج التي تعتمد عليها.
- وكما يظهر في الشكل (2-14)، تبرُز القيم الشاذة بوضوح وتظهرُ منفصلة عن الأنماط العامة للبيانات.
دراسة حالة في التعلّم غير الخاضع للإشراف
أتعاون مع مجموعتي على اختيار إحدى الحالات الآتية، ونحدّد خوارزمية التعلّم غير الخاضع للإشراف المناسبة لكل حالة، ثم نعدُّ عرضًا تقديمِيًّا يبين الحالة والمتغيرات والخوارزمية المختارة، ومبررات اختيارها، مع استخدام أداة تمثيل بصري لها؛ باستخدام أحد برامج الذكاء الاصطناعي، ونشاركه مع الزملاء على اللوح التفاعلي للصف، ونتفاعل مع عروض المجموعات الأخرى عبر طرح الأسئلة وطلب التوضيحات. الحالة 1: بيانات العملاء بناءً على سلوك الشراء الوصف: شركة تجارة إلكترونية ترغب في تخصيص العروض التسويقية بناءً على الاحتياجات المختلفة لكل عملائها بناءً على سلوكهم الشرائي. الحالة 2: مجموعة بيانات طبية الوصف: تتوافر لدى مستشفى مجموعةُ بيانات كبيرة تحتوي على العديد من المتغيرات الطبية، مثل نتائج الفحوصات المختبرية للمرضى، والعمر، والجنس. ويرغب المستشفى في تقليل عدد المتغيرات لتحليل البيانات بشكل أكثر فعالية. الحالة 3: تحليل البيانات النصية للتعليقات الوصف: موقع للتسوق الإلكتروني يجمع التعليقات النصية من العملاء حول منتجاتهم، ويرغب في استخراج الأنماط الخفية أو تقسيم التعليقات إلى مجموعات بناءً على التشابه في النصوص، وتحليل هذه التعليقات لتحديد الأنماط في ردود الفعل للعملاء من دون تصنيف مسبق.
3. التعلّم المعزّز
التجربة والخطأ: مكافأة تُحسّن السلوك
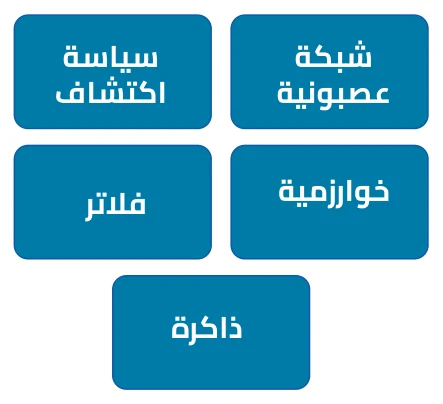
- يبين الشكل (2-15) آلية عمل التعلّم المعزّز.
- لنقُل مثلاً إننا نريد أن تتعلّم الآلة كيفية لعب لعبة إلكترونية، وطريقة تعلّمها إتقان هذه اللعبة عن طريق عملية تكرار، (Loop).
خطوات بناء نموذج تعلّم الآلة
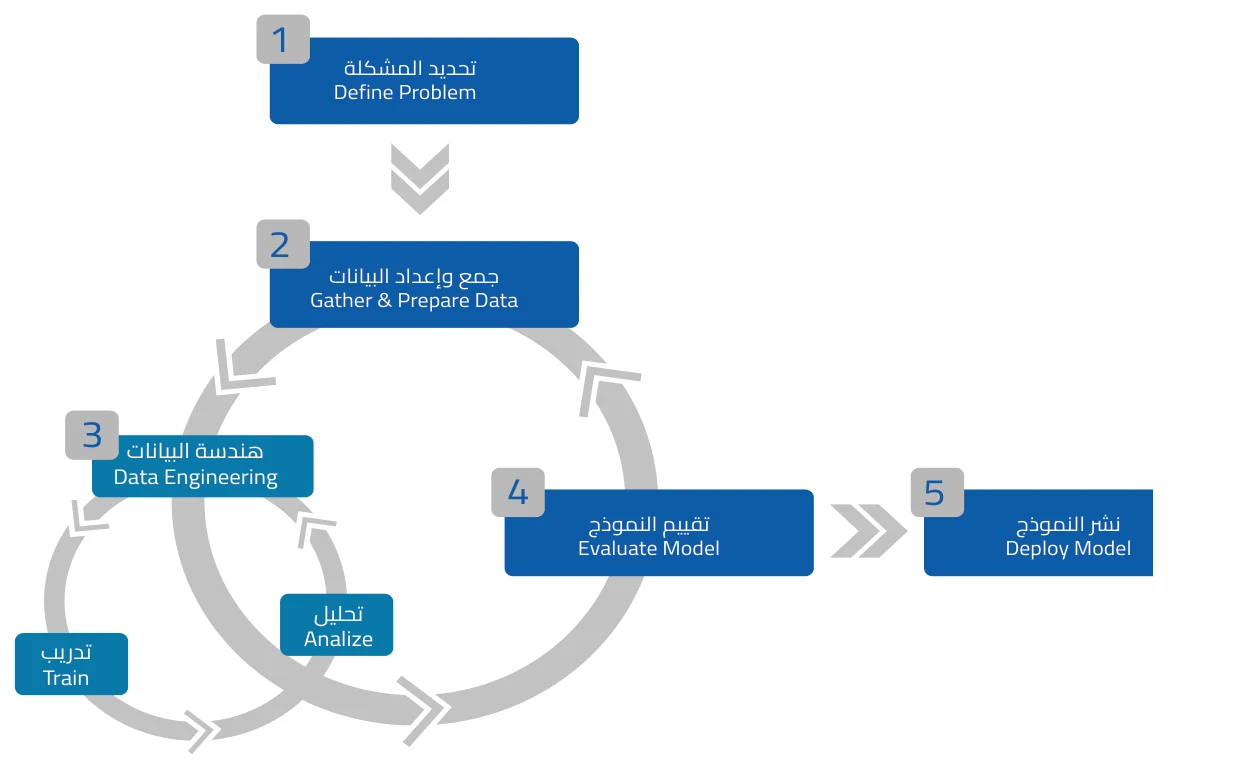
من المشكلة إلى الخوارزمية: الخطوات الأولى
- يبدأ البحث عن حلول عندما يكون هناك مشكلة معينة يسعى المعنيون إلى حلها، ولديهم فهم عن كيفية قيام الشركة باستخدام الحل المقترح وتوظيفه.
- تختلف طرق الحل باختلاف التقنيات المراد استعمالها؛ حيث تتنوع التقنيات، فمنها على سبيل المثال الاستعانة بخبير لوضع قواعد معينة لتحسين الأداء، أو استعمال خوارزميات معروفة في المجال، أو الاعتماد على تقنيات تعلّم الآلة.
أفكر وأناقش
أتخيّل أن شركة ما لجأت لحلول تقنيّات التعلّم الآلي لحل مشكلة معينة، أفكر في الأسئلة التي يجب الإجابة عنها قبل البدء بخطوات بناء نموذج تعلّم الآلة. أشارك أفكاري مع زملائي في الصف.
- تتمثّل الخطوات الأساسية لبناء نموذج تعلّم الآلة في ما يأتي:
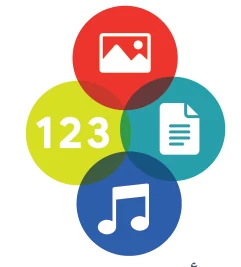
1. جمع البيانات
- جمع البيانات: بمجرد تحديد المشكلة، يجب البدء بجمع البيانات اللازمة.
- تعدُّ هذه الخطوة أولِيّة ومهمة في تعلّم الآلة؛ لأن حجم البيانات ونوعيتها تُحدد كفاءة النموذج وفاعليته، وتختلف طبيعة البيانات باختلاف المشكلة.
- وكما تعلّمنا مسبقًا، فإن جميع البيانات التي يُتعاملُ معها ضمن التعلّم الخاضع للإشراف، تنقسم إلى خصائص ووسم؛ حيث إنَّ كلَّ عينة في البيانات يكون لديها قِيَمٌ لهذه الخصائص والوسم.
أتعاون مع مجموعتي على البحث ومناقشة البيانات التي نحتاج جمعها لكل مشكلة من المشكلات الآتية، مع تحديد الخصائص والوسم لكل منها: توقُّع أسعار المنازل في الأردن. تحديد ما إذا كان الشخص مصابًا بالتهاب رئوي بناء على صورة الأشعة. تحديد ما إذا كان الشخص مصابًا بمرض الضغط. تحديد درجة صعوبة فقرة مكتوبة باللغة الإنجليزية. تحديد الكائن الحي الموجود في صورة.
2. استكشاف البيانات
3. تجهيز البيانات
- تجهيز البيانات: بعد استكشاف البيانات نحتاج لعمل ما يأتي؛ لتكون المعلومات جاهزة للاستعمال من قبل خوارزميات التعلّم الآلي.
- يجب أيضًا تحديد القيم المتطرفة وإزالتها أو تعديلها.
- يساعد هذا في تقييم أداء النموذج بشكل صحيح.
- وهناك قاعدة مهمة عند تقسيم البيانات إلى "تدريب - تقييم" وهي أن نسب تقسيم البيانات يجب أن تكون إما 80% - 20% أو 70% - 30%، على التوالي.
- يعتمد هذا التقسيم -طبعًا- على الحجم الإجمالي للبيانات.
4. اختيار النموذج (Choose
- فهناك خوارزميات تُستخدم لبيانات الصور، وأخرى للنصوص أو الأصوات، وبعضها للبيانات الرَّقميّة.
- عادة ما تُجرَّب أكثر من خوارزمية، وتُختارُ الخوارزمية التي تُنتج أفضل نموذج بناءً على أدوات قياس تنسجم مع طبيعة المشكلة.
5. التدريب (Training)
التدريب والتقييم: نعدّل ثم نختبر
- يبين الشكل (2-18) مثالاً للنموذج الخطي وبعض معاملاته. تتكون البيانات في هذا المثال من خاصية واحدة فقط X ستُستخدم للتنبُّؤ بقيمة Y.
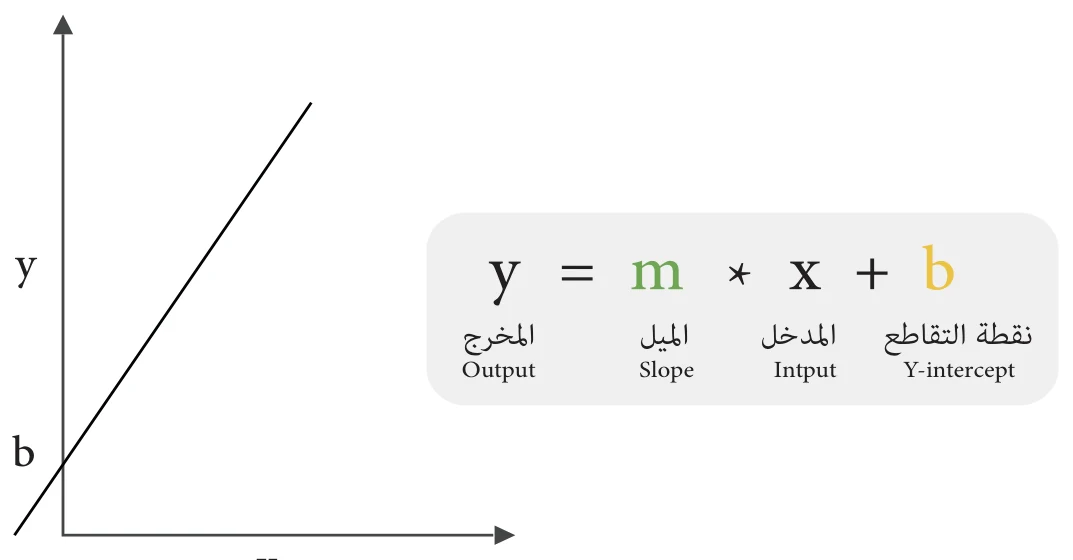
- أسماء أجزاء المعادلة كما تظهر تحت كل رمز: y المخرج (Output)، m الميل (Slope)، x المدخل (Intput)، b نقطة التقاطع (Y-intercept).
- في معادلة الخط المستقيم الظاهرة في الشكل، تمثل Y معادلة النموذج، وسيتم إيجاد قيم m و b التي تجعل من قيمة Y المتوقعة قريبة جدًا من قيمة Y الحقيقية؛ بحيث يتم خلال التدريب تعديل قيم m و b لزيادة الدقة.
- ويتغير الخط المستقيم مع التكرار؛ ليحقق الناتج بشكل مثالي، كما هو موضح في الشكل (2-19).
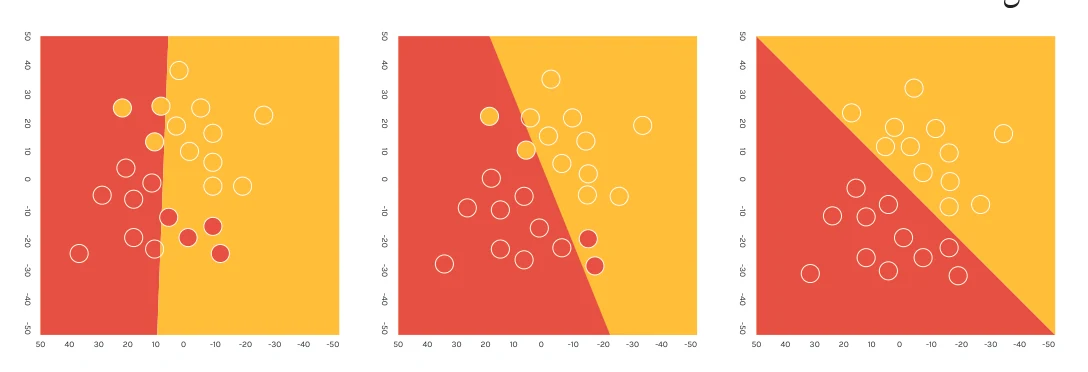
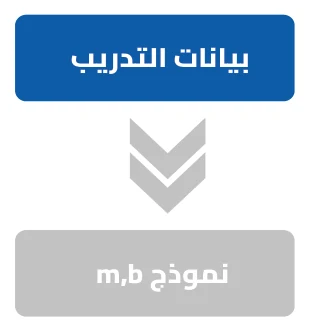
- ويبين الشكل (2-20) الآلية التي يتم فيها تدريب النموذج وتحسينه بشكل مستمر للحصول على دقة جيدة.
6. تقييم النموذج (Evaluation)
- بعد الانتهاء من عملية التدريب، يجب التحقق من أداء النموذج بحسب الخطوات الآتية:
- تقسيم البيانات:** تقسيم البيانات إلى مجموعة تدريب ومجموعة اختبار. تُستخدم أحياناً مجموعة تحقق (Validation) إضافية لضبط المُعلّمات (Hyperparameters).
- اختيار المقاييس المناسبة:** يوجد مقاييس عدة للتقييم نذكر منها: الصحة والاسترجاع والدقة.
أبحث
- تطبيق النموذج على مجموعة الاختبار:** استخدام النموذج المدّرب لتصنيف النصوص أو معالجتها في مجموعة الاختبار.
- حساب المقاييس:** هو مقارنة النتائج المتوقعة مع النتائج الفعلية، وحساب المقاييس المختارة؛
- وذلك بتجريبه على بيانات التحقق (Test Set) غير المرئية للنموذج، والتي أشرنا لها مسبقًا في الخطوة الثالثة؛
- حيث تعكس نتائج الاختبار على مجموعة الاختبار دقة أداء النموذج وقابليته للاستخدام في الواقع الحقيقي.
يوجد مقاييس أخرى يمكن استعمالها في تقييم النموذج، أبحثُ في المصادر الإلكترونية الموثوقة عن هذه المقاييس وأدوّنها في مستند Google Docs وأشارك النتائج على اللوح الرَّقمي التفاعلي للصف.
أستخدم موقع الذكاء الاصطناعي Gemini للبحث عن الفرق بين مقاييس التقييم، وأدوّن ما أتوصل إليه في ملف Google docs، وأشاركه على اللوح الرَّقمي التفاعلي للصف.
9. تحسين النموذج
بعد التقييم: تحسين النموذج ثم نشره
- بعد الانتهاء من الخطوة السابقة، قد تحتاج أحياناً إلى تحسين النموذج قدر الإمكان.
- ويمكننا عمل ذلك عن طريق إعادة ضبط الخصائص/المعاملات Hyperparameters Tuning التي تدرّب عليها النموذج مُسبقًا.
- ومن هنا قد تنتجُ لنا عدداً من التجارب كل واحدة منها بدقة مختلفة؛ تبعاً للعامل الذي تم تغييره.
10. نشر النموذج (Publishing)
- عادةً تُطوَّر واجهة مثل موقع إلكتروني، أو تطبيق ما؛ حتى يتمكن المستخدم من التعامل مع النموذج بفعالية وسهولة.
- يجب مراقبة النموذج باستمرار للتأكد من فعالية أدائه، وأنه ما زال متاحاً للمستخدمين، وإجراء الصيانة اللازمة للخوادم إذا لزم.
- مع مرور الوقت قد نحتاج إلى إعادة تدريب النموذج على بيانات جديدة، أو باستخدام خوارزميات أحدث قد تعطي نتائج أفضل.
أدوات بناء نموذج التعلّم الآلي
بناء النموذج بأدوات جاهزة
- هناك عديدٌ من الأدوات التي يمكن استخدامها لبناء أنظمة تعلّم الآلة، ويمكن تصنيف هذه الأدوات إلى قسمين:
- أدوات لديها واجهة للمستخدم وأيقونات، يمكن للمستخدم سحبها ووضعها على مساحة العمل.
- وتربطُ هذه الأيقونات بعضها مع بعض بتسلسل معين لإنجاز مهمة معينة.
- ومن الأمثلة عليها أداة Orange Data Mining وأداة KNIME.
- باستخدام لغة برمجة معينة لكتابة البرامج مثل python، واستعمال مكتبات تحليل البيانات وخوارزميات تعلّم الآلة لإنجاز مهمة معينة.
- تعدُّ Sklearn من أهم المكتبات المستخدمة في هذا المجال.
استكشاف أداة
- واجهة رسومية:** تُسهّل بناء نماذج التحليل والتعلّم الآلي من دون الحاجة لكود برمجي.
- التعلّم الآلي:** تدعم العديد من خوارزميات التعلّم الآلي مثل التصنيف، والتجميع، والانحدار.
- التحليل البصري:** توفر أدواتٍ لعرض البيانات بصريًا، وتساعد في اكتشاف الأنماط.
- التكامل:** يمكن دمجها مع أدوات أخرى مثل Python لزيادة القدرة على التحليل.
واجهة المستخدم والأيقونات
- تظهر الشاشة الترحيبية عند تشغيل هذه الأداة كما يظهر في الشكل (2-21)، والتي يُمكن عن طريقها بدء مشروع جديد، أو فتح مشروع سابق، أو مشاهدة فيديوهات تعليمية، أو أمثلة، أو غيرها.
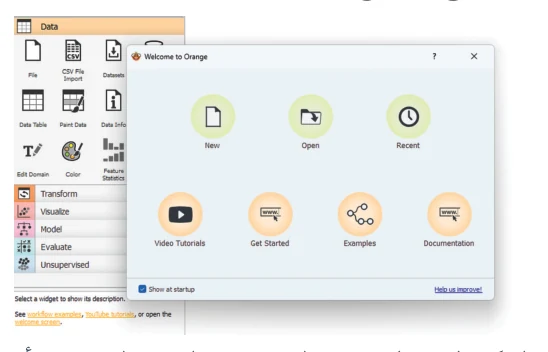
- في الجهة اليسرى من الشاشة تظهر الأدوات (Widget) كما يظهر في الشكل (2-22) المصنّفة بحسب طبيعة عملها.
وفي ما يأتي توضيح لكلّ منها:
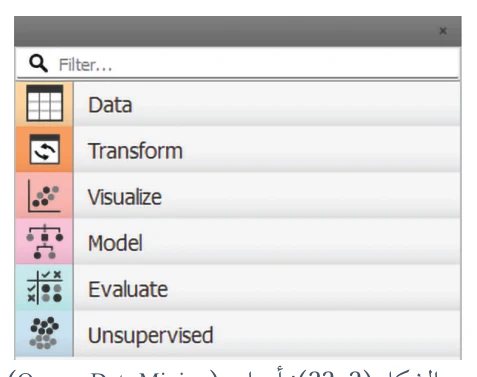
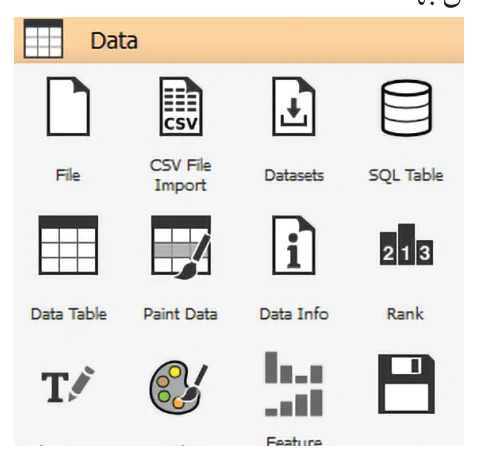
- الشكل (2-23) يبين الأيقونات التي تظهر عند الضغط على مجموعتي Data و Visualize. وعند التأشير على أي أيقونة سيظهرُ أسفلها الوصف الخاص بها.
| الأيقونة | المجموعة | الوظيفة |
|---|---|---|
| File | مجموعة البيانات. | تُستخدم لقراءة الملف الذي يحتوي البيانات. |
| Data Table | مجموعة البيانات. | عرض البيانات على شكل جدول بعد قراءتها عن طريق أيقونة الملف. |
| Data Sampler | مجموعة البيانات. | تقسيم البيانات لمجموعة تدريب وتحقق. |
| Impute | مجموعة التحويل. | ملء الحقول التي ليس لديها قيم. |
| Continuize | مجموعة التحويل. | ترميز الحقول التي تحتوي على قيم فئوية. |
| Scatter Plot | مجموعة عرض البيانات. | عرض البيانات على شكل رسم متشتت. |
| Tree Viewer | مجموعة عرض البيانات. | عرض البيانات الشجرية. |
| Tree | مجموعة النماذج. | تطبق خوارزمية شجرة القرار على المدخلات. |
| Linear Regression | مجموعة النماذج. | تطبق خوارزمية الانحدار الخطي على المدخلات. |
| Test and Score | مجموعة التقييم. | تقييم النموذج المدّرب. المدخلات هي النموذج المدّرب والبيانات التي سيتم الفحص عليها (مجموعة التدريب والاختبار). |
| Predictions | مجموعة التقييم. | حساب معايير تقييم أداء النموذج. |
| k-Means | مجموعة خوارزميات التعلّم غير الخاضع للإشراف. | تطبيق خوارزمية التجميع على المدخلات. |
الجدول (2-1): أيقونات أداة
- لإضافة أيقونة؛ أنقر عليها باستخدام الفأرة أو يُمكن سحبها وإفلاتها داخل حيز العمل، أو النقر باستخدام زر الفأرة الأيمن في حيز العمل واختيار الأداة المراد إضافتها.
- ولتغيير اسم أداة مختارة داخل حيز العمل أنقر عليها باستخدام زر الفأرة الأيمن وأختار تغيير الاسم Rename، وكتابة الاسم الجديد، ثم أنقر على مفتاح Enter.
تحميل أداة واستخدامها
أول مشروع: تحميل الأداة وعرض البيانات
- أفتح المتصفح وانتقل إلى الموقع الرسمي لـ Orange Data Mining.
- أختارُ نظام التشغيل الخاص بجهازي.
- بعد اختيار نظام التشغيل، اضغط علي زر "Download".
- أفتحُ ملف التثبيت الذي تم تنزيله، وأتَّبعُ التعليمات الظاهرة على الشاشة.
- بعد اكتمال التثبيت، افتح برنامج Orange Data Mining.
استكشاف المجموعات والأيقونات
- في واجهة المستخدم، ألاحظُ مجموعة من الأيقونات والأدوات المصنفة في مجموعات.
- أحاول سحب أيقونة File من مجموعة Data إلى مساحة العمل (Workspace).
- أضغطُ على أيقونة File واختر ملف بيانات جاهز لتحليله.
- أصلُ أيقونة File بأيقونة Scatter Plot من مجموعة Visualize لرؤية البيانات في شكل رسم بياني.
- أستكشفُ المجموعات والأيقونات في واجهة المستخدم.
أُشغّلُ أداة Orange Data Mining وأنفّذُ الآتي:
- أضيف أيقونة ملف، ومن ثم أغير اسمها إلى My First Tool، ثم أكررها عن طريق النقر على زر الفأرة الأيمن، واختيار Duplicate، ومن ثم أعيد تسميتها إلى My Second Tool.
- أنقرُ بزر الفأرة على مكان فارغ في حيز العمل، ثم أكتب في مربع البحث Data، وأختار Data Table من مجموعة الخيارات الظاهرة.
- للربط بين الأيقونات، أنقر على الخط المتقطع المحيط بالأيقونة وأسحبُ إلى الأيقونة الثانية.
- أعرض ما توصلت إليه أمام الزملاء.
البيانات وعرضها
- تُعد البيانات العمود الفقري للذكاء الاصطناعي وعلم البيانات، فهي الأساس الذي يُبنى عليه.
- إضافة أيقونة File إلى حيز العمل، ثم النقر مزدوجًا لتحديد الملف الذي يُراد أخذ البيانات منه كما يظهر في الشكل (2-24).
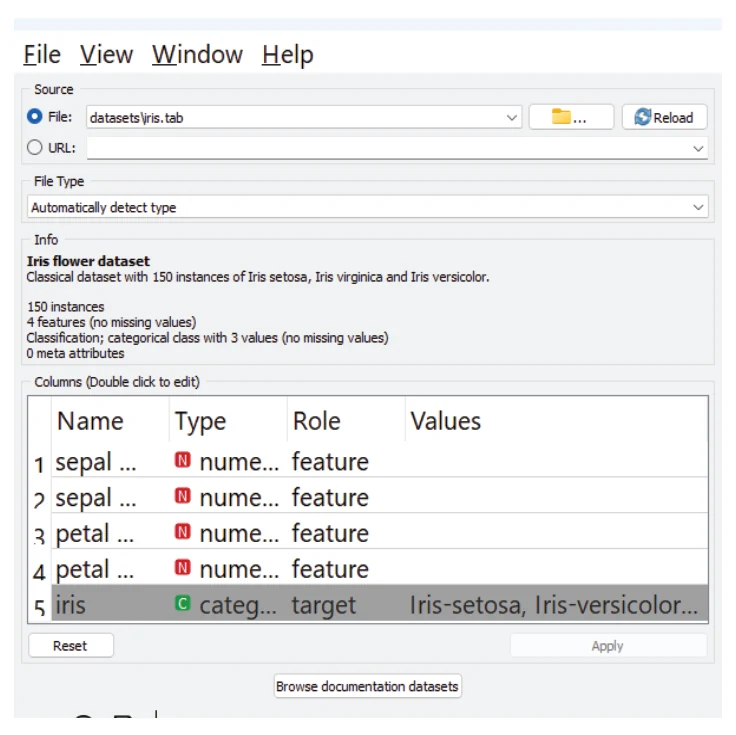
- ويُمكن اختيار البيانات عن طريق النقر على زر استعراض [...] والانتقال إلى المكان الذي يحتوي الملف الذي سيُحمَّلُ منه ويُختارُ. وفي هذا المشروع سيُختارُ iris.tab.
- تظهر معلومات خاصة بالبيانات التي اختيرت في الجزء الثاني والثالث من مربع الحوار، وهي اسم مجموعة البيانات، وعدد السجلات المدخلة، والخصائص.
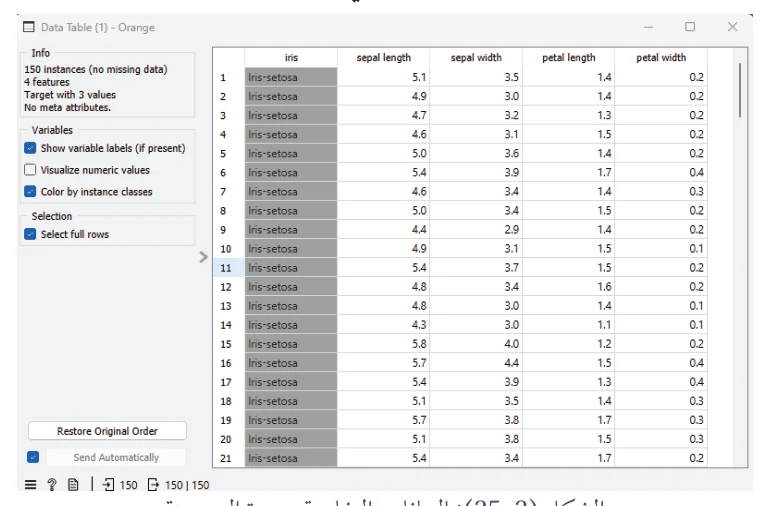
- لمشاهدة البيانات الخاصة بزهرة السوسنة Iris، تُربط أيقونة File بأيقونة Data Table، ثم يُنقر على أيقونة Data Table نقرًا مزدوجًا كما يظهر في الشكل (2-25).
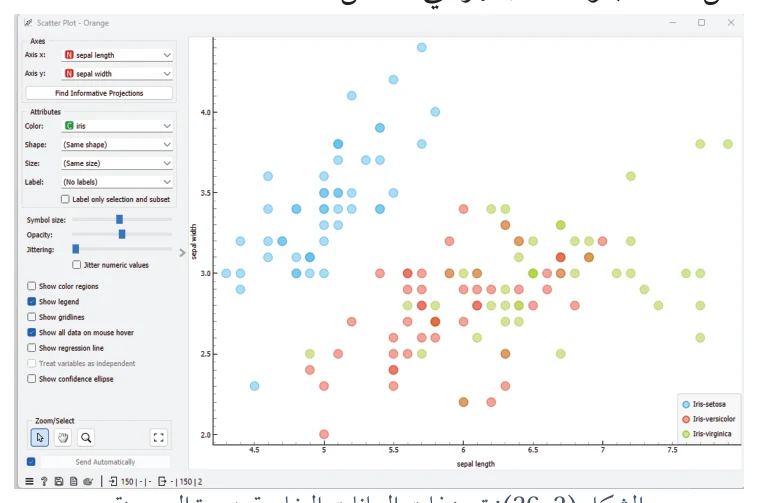
- لعرض هذه البيانات، تُربط أيقونة Data Table بأيقونة Scatter Plot؛ حيث يتم إظهارها بحسب التصنيفات؛ كل صنف بلون كما يظهر في الشكل (2-26).
أنفّذُ خطوات ربط الأيقونات لربط أيقونة Data Table بأيقونة Bar Plot، وألاحظ الفرق بينها وبين أيقونة Scatter Plot. ثم أربط أيقونة Data Table بأيقونة Distributions وألاحظ الفرق. أناقش ما توصلت إليه مع الزملاء.
تدريب خوارزمية شجرة القرار
بناء شجرة قرار خطوة بخطوة
- لنتمكن من بناء نموذج التعلّم الآلي، يجب اتباع الخطوات التي ذُكرت مسبقًا ضمن بند "خطوات بناء نموذج تعلّم الآلة".
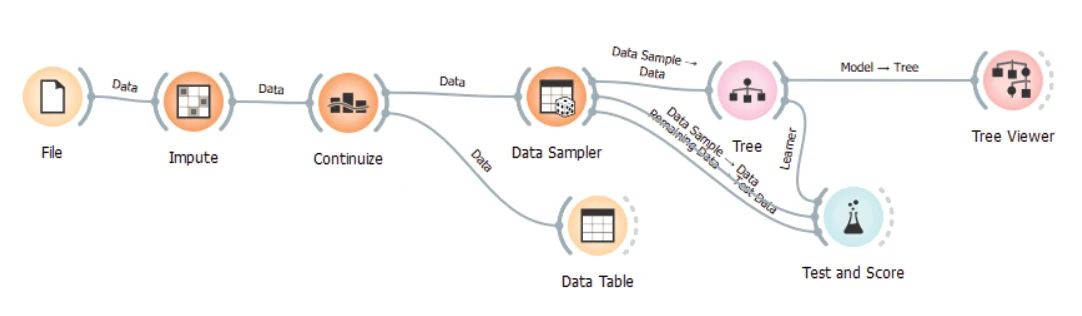
- في ما يأتي توضيح لخطوات تدريب خوارزمية شجرة القرار على البيانات باستخدام أداة (Orange Data Mining)، وتقييم النتائج وعرضها:
- تُستعرضُ الخصائص المتاحة لكل سمة أو متغير في البيانات، بالإضافة إلى تفاصيل كل خاصية (Feature).
- تُختارُ أيضًا الخاصية المستهدفة (الوسم) التي سيُبنى النموذج بناءً عليها.
- تُختارُ الآلية عن طريق النقر بشكل مزدوج على الأيقونة.
- النقر المزدوج على هذه الأيقونة يمكننا من اختيار الطريقة الأنسب للبيانات.
- ولأنَّ هذه الأيقونة تنتج مجموعتين، سنجد هناك رابطتين بين (Data Sampler) و (Test and score).
- والهدف من الرابطتين هو توجيه مجموعة التدريب والاختبار بين الأيقونتين.
- يمكن استعراض التوجيه وتعديله بالضغط على أي من الرابطتين.
- يمكن تعديل الخصائص والمعاملات للخوارزمية عن طريق النقر على أداة النموذج.
- على سبيل المثال عند النقر نقرًا مزدوجًا على أيقونة (Tree) لمشاهدة الخيارات، تظهر كما في الشكل (2-27) ويُمكن تغييرها بما يتناسب والمطلوب وهي كما يأتي:
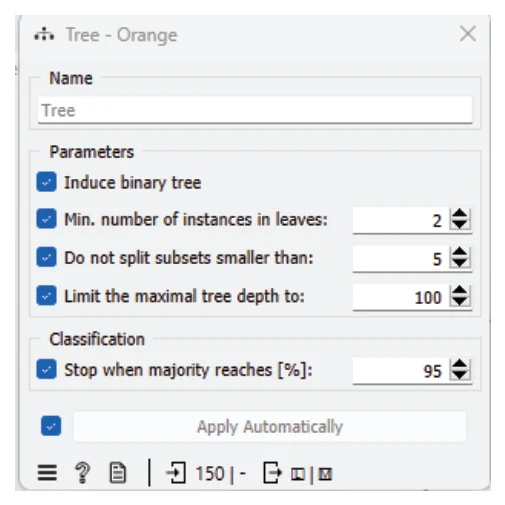
- الحد الأدنى لعدد الحالات في الأوراق (Min. number of instances in leaves)، والخيار المحدد في الشكل هو 2.
- لا تقسم المجموعات الفرعية الأصغر من (Do not split subsets smaller than)، والخيار المحدد هنا هو 5.
- حدّد الحد الأقصى لعمق الشجرة (Limit the maximal tree depth to)، والخيار المحدد هنا هو 100.
- هناك طرق عدة لتقييم النتائج، منها استعمال أداة (Test and Score) التي تستقبل المخرج من النموذج المدّرب وأيقونة (Data Sampler) لتقييم نتائج النموذج،
- بالإمكان ربط أكثر من نموذج على أيقونة (Test and Score)، فتقوم هذه الأيقونة باختيار أدوات القياس المناسبة بحسب طبيعة الوسم للبيانات قيد الدراسة،
- ويمكن استعراض النتائج بالنقر المزدوج على الأداة.
تدريب النماذج باستخدام مجموعات بيانات مختلفة
أنفّذُ الخطوات السابقة على بيانات (Iris.tab) التي تهدف إلى التنبؤ بنوع السوسنة. أبدأ بتحميل البيانات من الملف (Iris.tab)، وأنفّذُ خطوات إعداد البيانات وتدريب خوارزمية شجرة القرار. استعرض النتائج وأقارنها مع الزملاء.
إضاءة
تدريب نموذج شجرة القرار على بيانات (heart_disease)
أتعاون مع الزملاء في المجموعة لتنفيذ خطوات تدريب خوارزمية شجرة القرار على بيانات (heart_disease) التي تهدف إلى التنبؤ بأمراض القلب باستخدام خوارزمية شجرة القرار، وأتبع الخطوات الآتية: استخدم خاصية (Diameter Narrowing) كوسم. ترميز البيانات الفئوية باستخدام (One-Hot Encoding). الاحتفاظ بالبيانات الرَّقميّة كما هي. تدريب النموذج ومقارنة النتائج مع مجموعات أخرى.
أتعاون مع الزملاء في المجموعة لبناء نموذج انحدار على البيانات الموجودة بملف (Housing.csv) التي تهدف إلى التنبؤ بأسعار المنازل. باتباع الخطوات الآتية: فتح الملف بوساطة برمجية (Microsoft Excel) واستعراض محتوياته والخصائص التي سيُعتمد عليها لتوقّع سعر البيت. إضافة أيقونة الملف وضبطها لتحميل الملف (Housing.csv) من الجهاز. ضبط أيقونة الملف ليصبح عمود (Price) هو الوسم. إضافة الأيقونة المناسبة لملء القيم المفقودة إن وجدت. إضافة الأيقونة المناسبة لتحويل القيم غير العددية إلى قيم عددية تبدأ قيمها من 0. تقسيم البيانات إلى مجموعة التدريب ومجموعة اختبار؛ بحيث تشكل مجموعة التدريب 80% من البيانات. تدريب خوارزميات (Decision Tree)، (Random Forest) و (SVM) على البيانات. استعراض نتائج النماذج على مجموعة الاختبار، ومقارنة النتائج مع المجموعات الأخرى.
إضاءة
بناء نظام تعلّم آلي لتمييز الخطوط باستخدام (ChatGPT) استخدم برنامج (ChatGPT) لإنشاء كود (Python) لنظام تعلّم آلي، يقوم بتمييز الأرقام المكتوبة بخط اليد. أقارن النتائج التي حصلت عليها مع نتائج المجموعات الأخرى. هل اختلفت النتائج؟ أبرّر إجابتي. هل أستطيع تطبيق البرنامج في بيئة بايثون؟ أسأل برنامج (ChatGPT) عن متطلبات تنفيذ البرنامج في بيئة بايثون، وأجرب تطبيقه. أشارك نتائج ما توصلت إليه مع الزملاء.
أبحث
أبحث في المواقع الإلكترونية الموثوقة عن تطبيقات التعلّم الآلي في التعليم، ثم أعدُّ عرضًا تقديمِيًّا باستخدام (Google Slides)، وأشاركه على اللوح الرَّقمي التفاعلي للصف.
المواطنة الرَّقميّة
المواطنة الرقمية ومشروع المهمة الثانية
- أنظمُ البيانات التي جُمعت في المهمة الأولى في جدول بيانات (Excel) وأحفظه بصيغة (.csv)، وأتأكد من أن كل خاصية لها صلة بالاستخدام، مثل عدد الكيلومترات المقطوعة، ونوع الوقود المفضل.
- إن نوع الاستخدام (طبيعة الرحلة أو المسافة)، ونوع الطريق المستخدم (طرق سريعة، مدن، تضاريس وعرة)، وتكلفة التشغيل وتكلفة الصيانة التقريبية، وتفضيلات المستخدم تكون موجودة ومنظمة بشكل صحيح.
- أُشغّلُ برنامج (Orange Data Mining) وأستردُّ البيانات من ملف (Excel) الذي أُنشئ. أبدأ بربط أيقونة الملف (File) في (Orange Data Mining) مع بيانات (Excel).
- استعرض البيانات في (Orange Data Mining) وأتأكد من أن جميع القيم والميزات قد أُدخلت على نحو صحيح.
- اختارُ أيقونة (Decision Tree) ضمن الأدوات في (Orange Data Mining).
- أتأكد من تحديد المتغير المستهدف (الوسم) وهو نوع السيارة المناسب (بنزين، كهرباء، هايبيرد) بناءً على طبيعة الاستخدام.
- أربط البيانات بالخوارزمية وأشغل تدريب شجرة القرار على البيانات.
- بعد تدريب النموذج، أستخدمُ أيقونة (Test & Score) لتقييم أداء النموذج عن طريق مقاييس، مثل الدقة (Accuracy).
- أستعرضُ النتائج لتحديد دقة النموذج في اختيار نوع السيارة المناسب بناءً على طبيعة الاستخدام.
أقيّم تعلّمي
أراجع ما تعلمته
السؤال الأول: أعرّف تعلّم الآلة، وأوضّح كيف يمكن أن نعرف أن نموذجاً معيّناً قد تعلّم بشكل جيد.
السؤال الثاني: ما الفرق بين نماذج التصنيف ونماذج الانحدار في التعلّم الآلي؟
السؤال الثالث: أوضح أهمية اكتشاف القيم المتطرفة أو الشاذة في البيانات وأثر ذلك في أنظمة التعلّم الآلي.
السؤال الأول: أبين الفرق بين الأنظمة الخبيرة وأنظمة تعلّم الآلة من حيث: التعريف، والمتطلبات، والقدرة على التعامل مع المعرفة المتغيرة.
السؤال الثاني: لماذا تعدُّ البيانات الضخمة عالية الجودة مهمة لبناء نموذج تعلّم الآلة؟ أفسر إجابتي.
السؤال الثالث: أبين خطوات بناء نموذج آلي للتنبؤ بمرض السكري. (يمكن الاستعانة ببرامج الذكاء الاصطناعي).
القيم والاتجاهات
أصمّم مع زملائي "بوسترًا" يبين الجوانب الأخلاقية المتعلقة بأنظمة التعلّم الآلي باستخدام أحد برامج الذكاء الاصطناعي، وأنشره على الموقع الإلكتروني للمدرسة، ثم أطبعه وأعلّقه في أحد أروقة المدرسة.

