تجاوز إلى المحتوى الرئيسي
TawjihiAI: دراسة التوجيهيادرس وتدرّب من هاتفكحمّل التطبيق

من كتاب مقدمة في الذكاء الاصطناعي المقرّر

محتويات الموضوع (٦٠)

تخطيط حل الذكاء الاصطناعي وإعداده لتلبية احتياجات محددة

  • يستكشف هذا الموضوع تخطيط أحد حلول الذكاء الاصطناعي، ويتناول كيفية التعرف على البيانات اللازمة لدعم الحل وكيفية جمعها وإعدادها.

ب1 بيانات الذكاء الاصطناعي

بيانات الذكاء الاصطناعي: من أين نبدأ؟

  • المفاهيم الأساسية: الطريقة التي يتم بها تنظيم البيانات (أو عدم تنظيمها في الواقع)، وأنواع البيانات المختلفة.
  • الهدف: تحديد مصادر البيانات المناسبة لمشاريع الذكاء الاصطناعي وكيف يجب إعداد البيانات للاستخدام.
  • نوع البيانات: يؤثر في طريقة التعامل معها والحفاظ عليها وفحصها.
  • الأنواع الأربعة الرئيسة: منظمة، شبه منظمة، غير منظمة، السلاسل الزمنية.

أنواع مختلفة من البيانات

ما الأنواع الأربعة الرئيسة من البيانات؟

البيانات المنظمة

البيانات المنظمة وغير المنظمة

  • البيانات المنظمة: منظمة بشكل جيد، وعناصرها عادة بتنسيق جدولي (باستخدام الصفوف والأعمدة).
  • نوع البيانات: يحتوي كل عنصر على نوع محدد (عدد صحيح، رقم عشري، سلسلة)، ما يسهل البحث والمعالجة.
  • أين تخزن: في جدول وقاعدة بيانات وملف ⁦CSV⁩ وسجل.
  • الاستعلام: يمكن الاستعلام عنها، لكن مع كثرة نقاط البيانات يستحيل تقريبًا إدارتها بفعالية.
  • دور التعلم الآلي: يوفر الأدوات الخوارزمية والإحصائية وموارد المعالجة للتعامل مع الحجم الهائل، ويجد الارتباطات الظاهرة والمخفية.

البيانات غير المنظمة

  • البيانات غير المنظمة: ليست مهيكلة، مثل النص الخام والصور ومقاطع الفيديو والصوت والرسائل الفورية ومحتوى صفحة الويب.
  • أمثلة: منشورات وسائل التواصل الاجتماعي، وملاحظات مكالمات العملاء، وفيديوهات كاميرات المراقبة ⁦(CCTV)⁩، ومنشورات منتديات الدعم.
  • يصعب للغاية معالجة البيانات غير المنظمة يدويا: افتقارها إلى هيكل محدد يجعل من الصعب البحث فيها دون استخدام أدوات متخصصة.
  • أدوات الذكاء الاصطناعي: تميز الأشكال في الصور والفيديو، وتحلل المشاعر على وسائل التواصل، وتنفذ معالجة اللغة الطبيعية ⁦(NLP)⁩.
  • الدقة: يمكن أن تختلف، فبعض منظمات إنفاذ القانون في المملكة المتحدة أصدرت إشعارات بحث عن أفراد أبرياء بسبب أنظمة غير دقيقة لتمييز الوجوه.

البيانات شبه المنظمة

البيانات شبه المنظمة هي مزيج من البيانات المنظمة وغير المنظمة، وغالبا ما تنشأ لتحقيق التوازن بين الحاجة إلى سهولة القراءة البشرية والحاجة إلى المعالجة الآلية، إذ إن توافر بعض عناصر البيانات المنظمة يسهل تحليلها، وغالبا ما تتضمن البيانات شبه المنظمة استخدام البيانات الوصفية. يمكن اعتبار البريد الإلكتروني شبه منظم لأن التنسيق (العنوان والموضوع والنص والمرفقات وما إلى ذلك) موثق ومنفصل. ومع ذلك، فإن محتوى الجسم نفسه غالبا ما يكون غير منظم. يمكن أيضا رؤية البيانات شبه المنظمة في أمثلة ⁦JSON⁩ و ⁦XML⁩، ما يوفر تبادلا فعالا للبيانات بين الخوادم والعملاء باستخدام الطلبات والاستجابات المستندة إلى واجهة برمجة التطبيقات ⁦(API)⁩.

المصطلح الرئيس البيانات الوصفية - البيانات التي تقدم وصفا لبيانات.

وقفة للتفكير هل تحتوي البيانات الوصفية (من النوع الذي تسجله الكاميرا الرقمية) على معلومات عن الصورة؟ تلميح ما نوع المعلومات التي تخزنها بيانات الصورة الوصفية؟ توسيع الأفق لماذا تكون التفاصيل حول الكاميرا المستخدمة، وإعدادات الكاميرا، والمعلومات حول مكان وتاريخ التقاط الصورة مفيدة؟

بحث توجد البيانات الوصفية في العديد من السياقات بما في ذلك رسائل البريد الإلكتروني وملفات الصوت والمواقع الإلكترونية. افحص بعض ملفاتك الخاصة وحدد البيانات الوصفية.

بيانات السلاسل الزمنية

شبه المنظمة والسلاسل الزمنية

  • البيانات شبه المنظمة: مزيج من البيانات المنظمة وغير المنظمة، تنشأ لتحقيق التوازن بين سهولة القراءة البشرية والمعالجة الآلية.
  • البريد الإلكتروني: شبه منظم لأن التنسيق موثق ومنفصل، لكن محتوى الجسم غالبًا غير منظم.
  • ⁦JSON⁩ و⁦XML⁩: أمثلة أخرى، توفر تبادلًا فعالًا للبيانات بين الخوادم والعملاء باستخدام طلبات واستجابات واجهة برمجة التطبيقات ⁦(API)⁩.

لماذا قد تستخدم المؤسسات هذه الأنواع المختلفة من البيانات؟

  • بيانات السلاسل الزمنية: البيانات التي تُجمع في نقاط زمنية محددة أو تُسجل على فترات زمنية متتالية.
  • ترتبط: بالمراقبة والتتبع، مثل تسجيل درجات الحرارة والإقبال على المتجر والضغط والرطوبة والأمطار وزوار الموقع.
  • الطابع الزمني: يحتوي على بيانات التاريخ والوقت فيجعل كل بند فريدًا، وتحتاج قواعد بيانات فعالة لتكرار المدخلات.

المصادر الشائعة للبيانات

لماذا تختلف أنواع البيانات؟

  • الاستخدام كما هي: قد تتوافر البيانات بتنسيق واحد فقط، فتستخدمه المؤسسة بهذا النموذج.
  • الاحتياجات: يعكس نوع بيانات المصدر احتياجات المعالجة، فالوصول السريع للسجلات المالية أو المخزون أو التوظيف يتطلب بيانات منظمة.
  • البيانات غير المنظمة: عند تحليلها بالذكاء الاصطناعي قد تكون أكثر فائدة من المنظمة، كتحليل الفحوصات الطبية لتحسين التشخيص السريري.
  • بيانات السلاسل الزمنية: أمر بالغ الأهمية لتحليل الاتجاهات، وهي لازمة للأشخاص والمنظمات العاملين في مجال التنبؤات، مثل خبراء الأرصاد الجوية.

الويب

مصادر البيانات: الويب

  • المصادر: تُنشأ كميات هائلة من البيانات يوميًا من تفاعلات الأشخاص مع التكنولوجيا ومن معالجة المعاملات.
  • الويب: يمكن استخراج البيانات من المواقع العامة وصفحات التواصل ولوحات الرسائل بتقنية (مسح الويب).
  • الاستخدامات: أبحاث السوق، ومراقبة الأسعار، وتوليد العملاء المحتملين، وجمع البيانات لنماذج التعلم الآلي.
  • التحليل ⁦(parse)⁩: وصف عملية استخراج البيانات المنظمة من البيانات غير المنظمة أو شبه المنظمة، كلغة ⁦HTML⁩ لصفحة الويب.
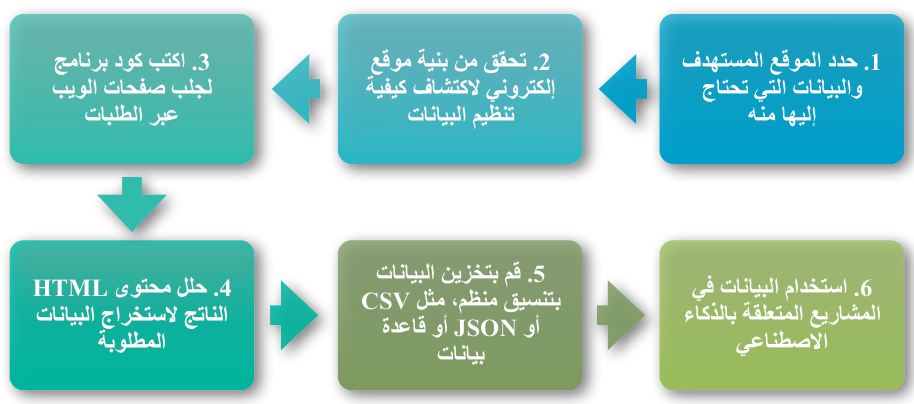
  1. حدّد الهدف: عيّن الموقع المستهدف والبيانات التي تحتاج إليها.
  2. افحص البنية: تحقق كيف نُظمت البيانات في الموقع.
  3. اجلب الصفحات: اكتب كودًا يجلب صفحات الويب عبر الطلبات.
  4. حلّل المحتوى: استخرج البيانات المطلوبة من الناتج.
  5. خزّن البيانات: احفظها بتنسيق منظم ثم استخدمها في المشروع.

مثال عملي

يوضح المثال العملي الآتي كود بايثون نموذجي يقوم بعملية استخراج بيانات بسيطة من موقع مصمم خصيصا للمتعلمين للسماح للمتعلمين بممارسة هذه العملية. استخدم محرك بحث للبحث عن '⁦Scrape this site tool'⁩. يعرض الشكل 21.6 صفحة الويب المحددة من خلال عميل استعراض ويب.
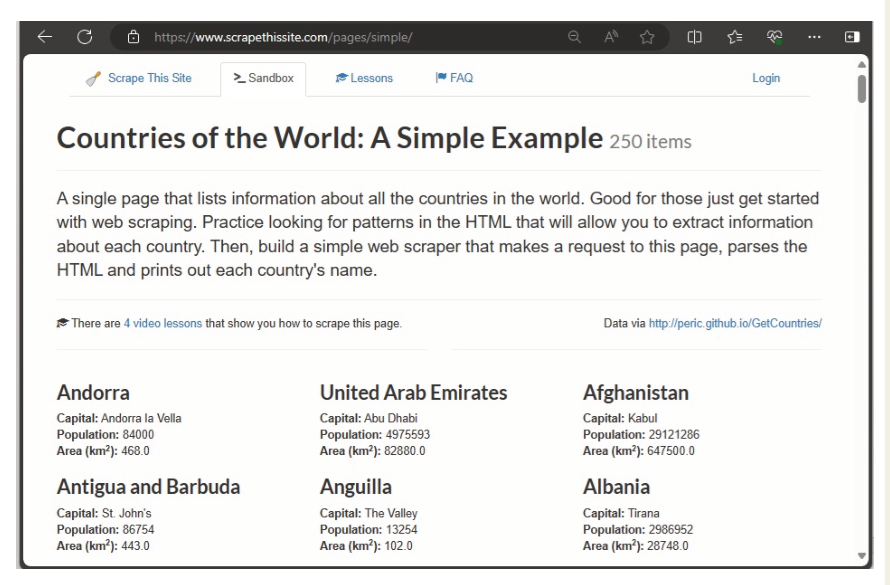
الشكل 21.6 مثال عملي لصفحة ويب تسرد معلومات أساسية عن دول العالم كأساس لإدراجها في نشاط استخراج البيانات من الويب.

الشكل 21.7 يظهر ⁦HTML⁩ الأساسي. هذا مجرد مقتطف لبلد واحد 'جنوب أفريقيا'.
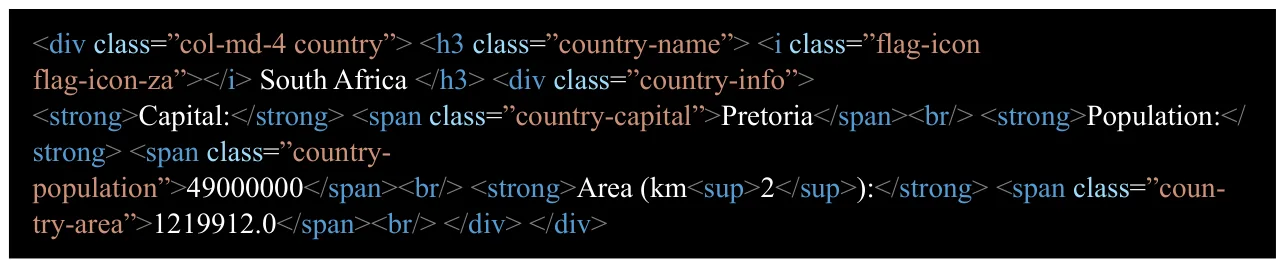
الشكل 21.7 مقتطف HTML يوضح العلامات المرتبطة بالبلد الواحد المحدد.
الشكل 21.7 مقتطف ⁦HTML⁩ يوضح العلامات المرتبطة بالبلد الواحد المحدد.

يوضح الشكل 21.8 مثالا على كود بايثون يجمع البيانات من الموقع، حيث يستخرج البيانات الرئيسة ويخزنها.
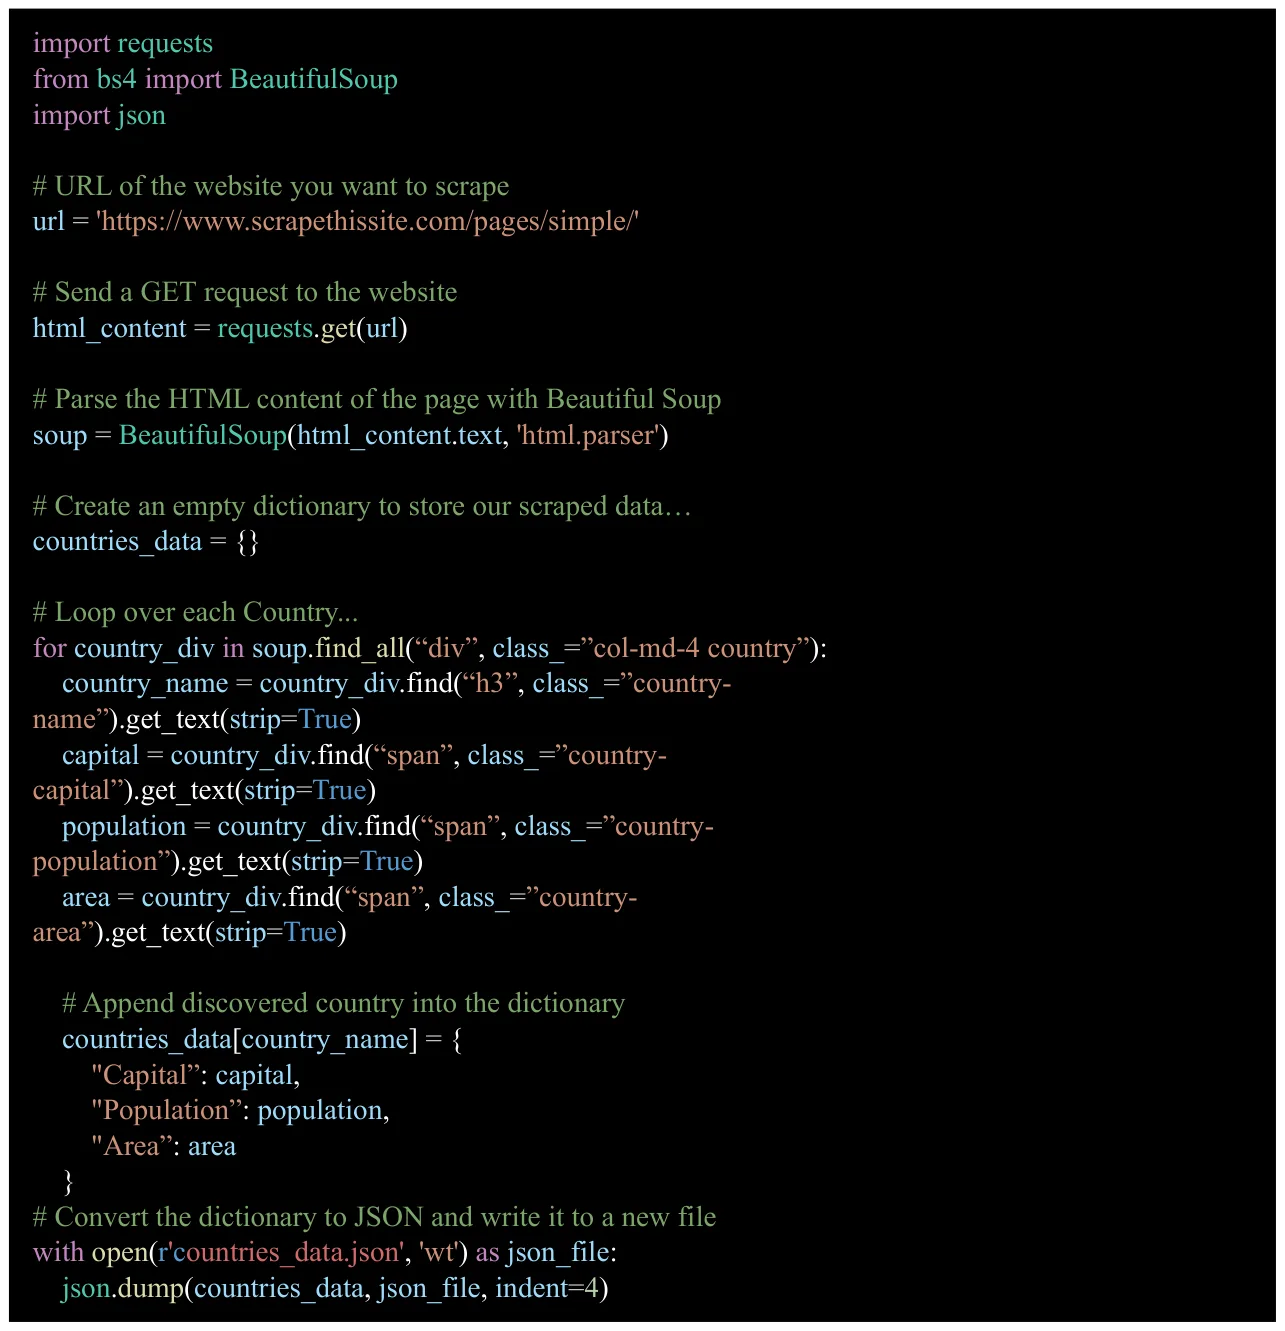
الشكل 21.8 كود بايثون يجمع البيانات من موقع إلكتروني لاستخراج البيانات الرئيسة وتخزينها.

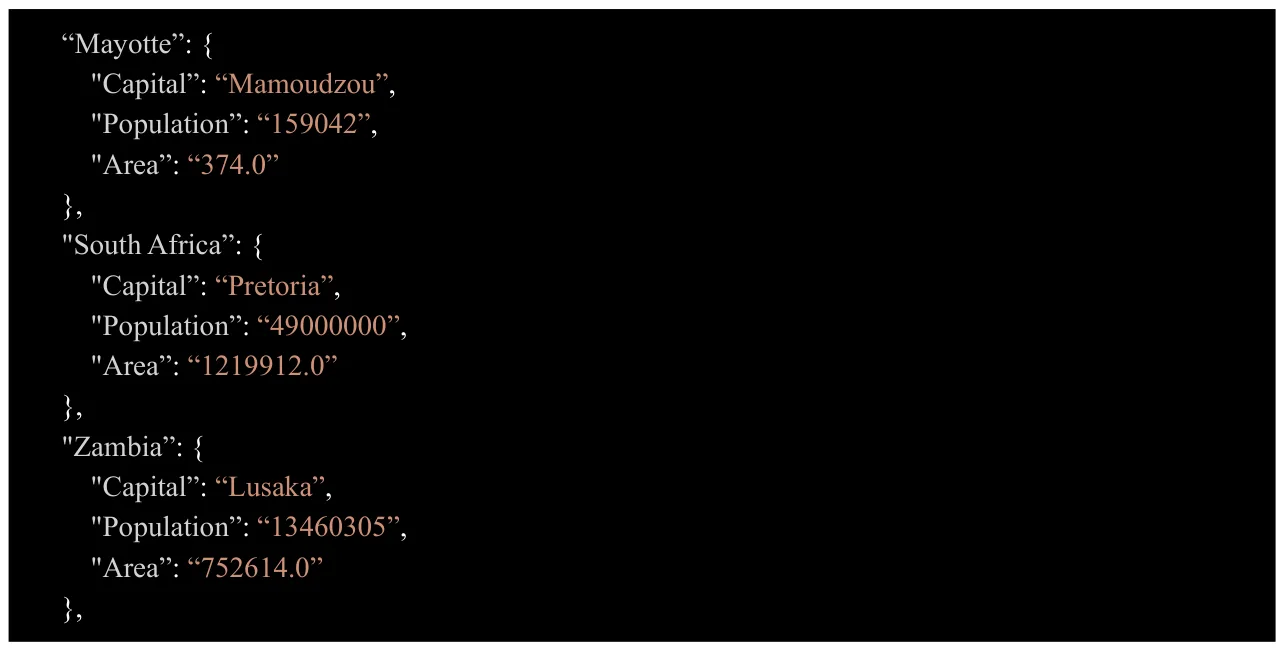
يوضح الشكل 21.9 بعض البيانات المستخرجة بتنسيق ⁦JSON⁩ من الملف الذي تم إنشاؤه.

الشكل 21.9 بيانات بتنسيق JSON.
الشكل 21.9 بيانات بتنسيق ⁦JSON⁩.

كما ترى، أصبحت هذه البيانات الآن نظيفة وخالية من أي محتوى متعلق بـ ⁦HTML⁩، ما يجعلها مناسبة للإدخال في أي عملية تعلم آلي.

تجدر الإشارة هنا إلى أن بعض المواقع الإلكترونية لا تسمح بالطلبات البرمجية، وذلك لأن جزءا من هذا الطلب يتضمن "سلسلة وكيل المستخدم". تحدد هذه القيمة لخادم الويب الذي يقدم الخدمة اسم أداة البرنامج التي تقدم الطلب، فعلى سبيل المثال، يُعرف المتصفح على أنه، ⁦Google Chrome⁩® أو ⁦Apple Safari⁩® أو ⁦Microsoft Edge⁩®، وما إلى ذلك. عادة ما تكون هذه الأمور مقبولة؛ إلا أنه عندما يقوم برنامج بإجراء طلب، فإنه عادة لا يخفي طبيعته (مثل "لغة بايثون")، ما قد يؤدي إلى رفض خادم الويب للطلب. من الممكن انتحال أو تزييف سلسلة وكيل المستخدم للتغلب على تردد خادم الويب، ما يجعل برنامجك يقلد عميل متصفح ويب أصلي. قد توفر المواقع الإلكترونية الأخرى واجهات برمجة التطبيقات العامة ⁦(API)⁩ التي تسمح بالاستعلام عن مصادر البيانات الأساسية لموقع إلكتروني واستخراجها. اعتمادا على طبيعة البيانات، قد تكون هذه الخدمة مجانية أو تتطلب استخدام مفتاح واجهة برمجة التطبيقات ⁦(API)⁩ قابل للشراء يمنح الوصول.

المصطلح الرئيس الطلبات البرمجية - طلب محتوى يعتمد على الويب عن طريق برنامج أو نص برمجي بدلاً من استخدام متصفح الويب يدويًا.

الشكل 21.10 سلسلة وكيل المستخدم لجهاز حاسوب يعمل بنظام Windows 10 باستخدام متصفح Microsoft Edge.
الشكل 21.10 سلسلة وكيل المستخدم لجهاز حاسوب يعمل بنظام ⁦Windows 10⁩ باستخدام متصفح ⁦Microsoft Edge⁩.

المصطلح الرئيس المصدر المفتوح - مشاريع البرمجيات التي تُتاح مجانا للجمهور، وعادة ما تسمح لأي شخص باستخدام الشفرة المصدرية للمشروع وتغييرها وتوزيعها.
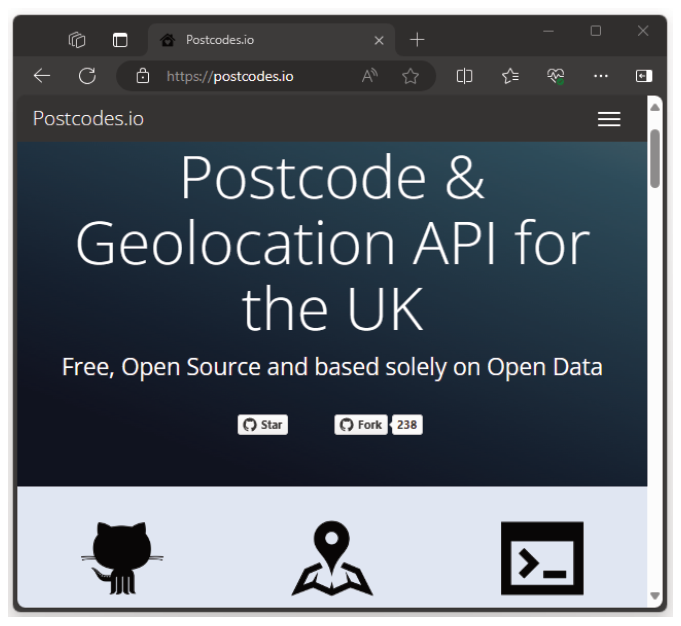
الشكل 21.11 Postcodes.io
الشكل ⁦21.11 Postcodes.io⁩

يتمثل أحد الأمثلة ذلك في ⁦Postcodes.io⁩ (كما هو موضح في الشكل 21.11)، وهو مشروع نشأ باستخدام برنامج مفتوح المصدر بواسطة ⁦Ideal Postcodes⁩. يقدم خدمة مجانية للمطورين للبحث عن البيانات المتعلقة بالرموز البريدية في المملكة المتحدة وتفسير الإحداثيات واستخراج البيانات. تتوفر مجموعات بيانات مماثلة لمناطق مختلفة، مثل ⁦postcode.eu⁩ لبلدان الاتحاد الأوروبي و ⁦getpostalcodes.com⁩ لمجموعات أخرى من البلدان. على سبيل المثال، يحتوي ⁦getpostalcodes.com⁩ على بيانات عن 12 منطقة بريدية في الأردن بما في ذلك عمان (العاصمة)، بالإضافة إلى مناطق مثل الزرقاء والطفيلة واربد وجرش. تعتبر البرامج مفتوحة المصدر، مثل تلك البرامج المستخدمة في ⁦Postcodes.io⁩، ناجحة جدا. مفتاح نجاحها هو أنها تسمح بالجهود التعاونية (من مجتمع المبرمجين) لتحسين المشروع بمرور الوقت، وإصلاح الأخطاء وإضافة وظائف وميزات جديدة عند الطلب. يوفر ⁦Postcodes.io⁩ عددا من نقاط النهاية المختلفة التي يمكن استخدامها للتحقق من بياناته. على سبيل المثال، يمكن استخدامه للتحقق مما إذا كان الرمز البريدي موجودا بالفعل ومكان وجوده في العالم.
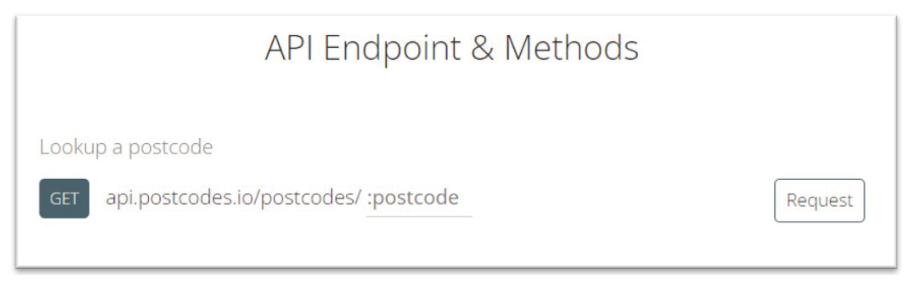
الشكل 21.12 التحقق من استخدام الرمز البريدي عبر نقطة النهاية الصحيحة لواجهة برمجة التطبيقات.

من الممكن أيضا الوصول إلى هذه البيانات عبر نقطة النهاية باستخدام طلب ⁦HTTP GET⁩ إما من خلال متصفح الويب (كما هو موضح في الشكل 21.13)، وإما باستخدام أداة سحب بيانات ويب مخصصة بلغة بايثون (كما هو موضح في الشكل 21.14).
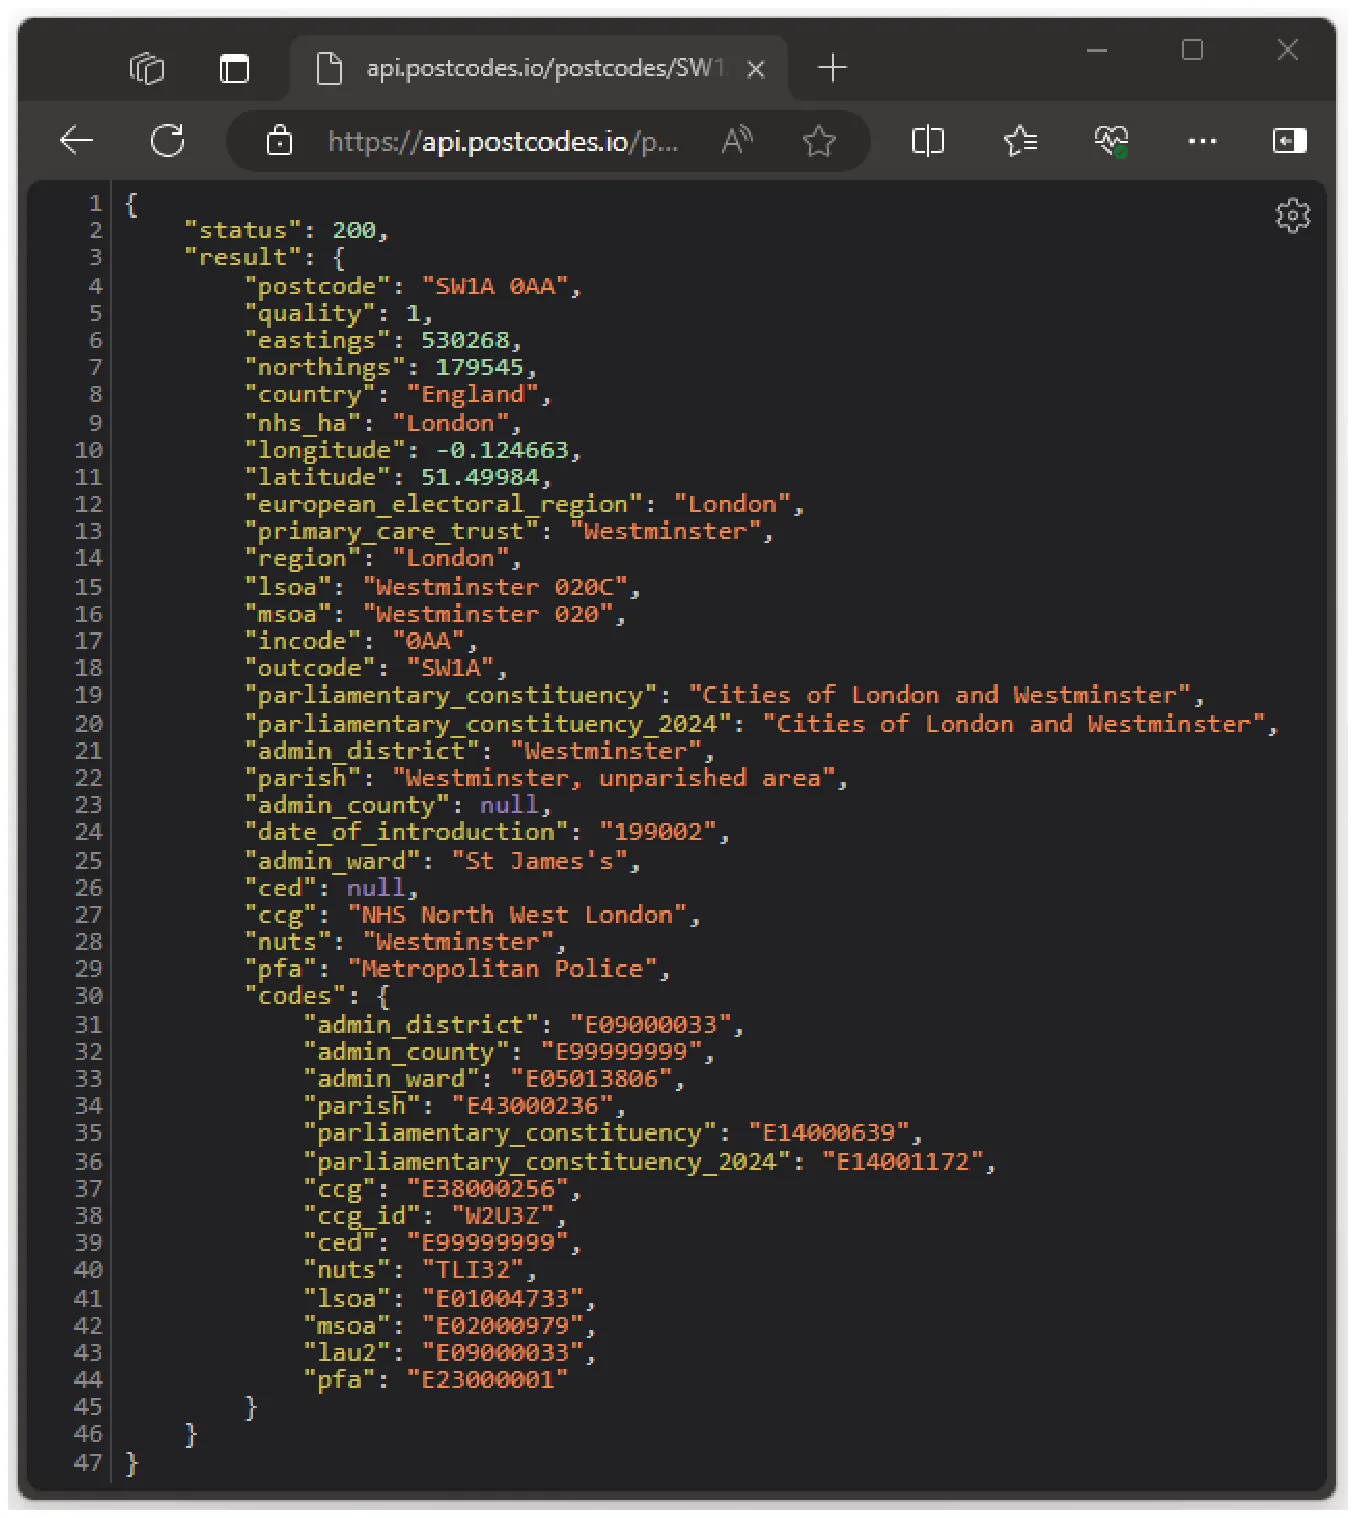
الشكل 21.13 استجابة JSON لطلب GET على نقطة النهاية الخاصة بواجهة برمجة التطبيقات.
الشكل 21.13 استجابة ⁦JSON⁩ لطلب ⁦GET⁩ على نقطة النهاية الخاصة بواجهة برمجة التطبيقات.
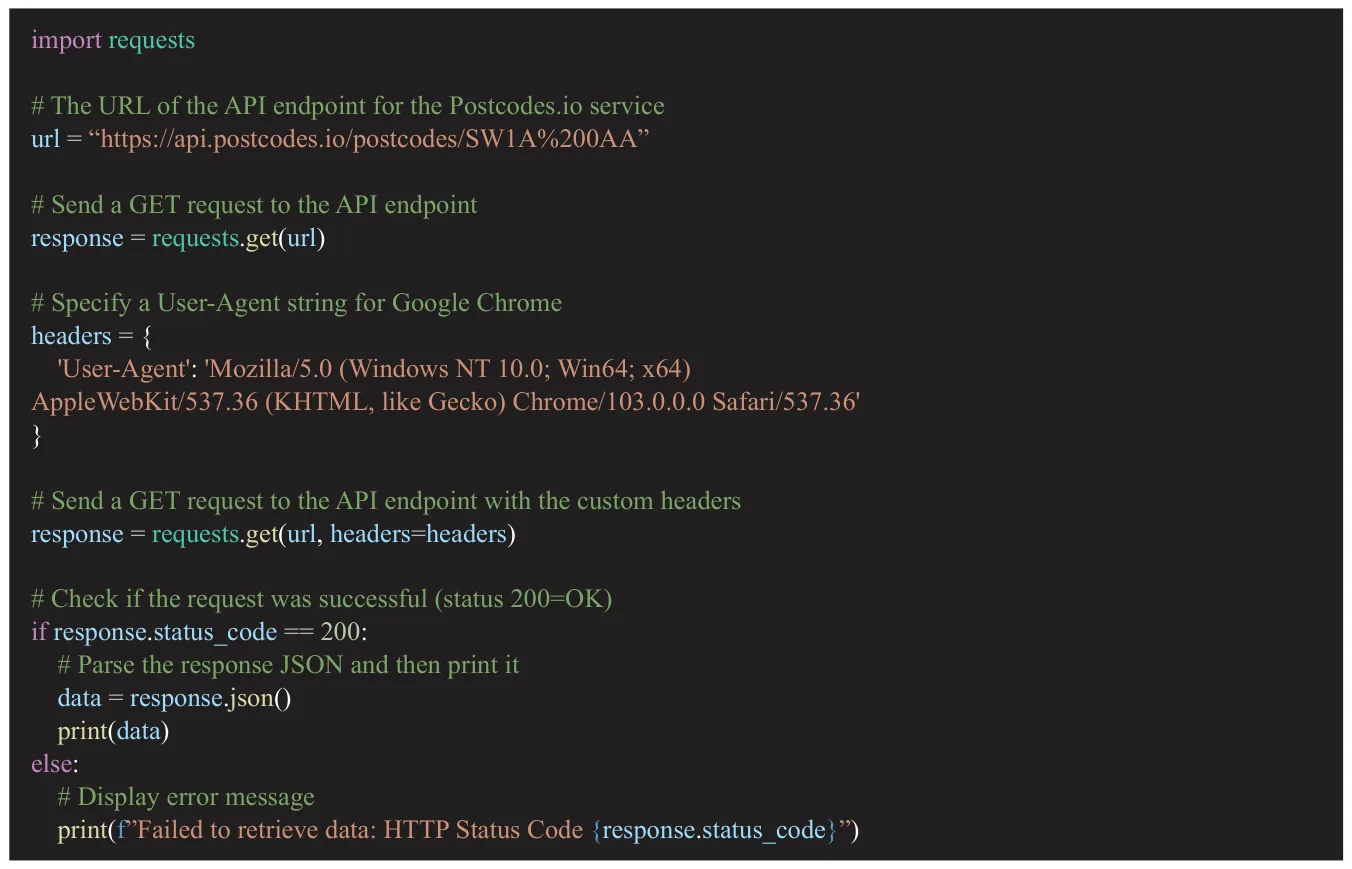
الشكل 21.14 كود بايثون لطلب واجهة برمجة تطبيقات بسيط لاستخراج بيانات للرمز البريدي SW1A 0AA باستخدام سلسلة وكيل مستخدم مزيفة.
الشكل 21.14 كود بايثون لطلب واجهة برمجة تطبيقات بسيط لاستخراج بيانات للرمز البريدي ⁦SW1A 0AA⁩ باستخدام سلسلة وكيل مستخدم مزيفة.

لاحظ استخدام سلسلة وكيل المستخدم المخادع لتوضيح كيفية تنفيذ ذلك. لحسن الحظ، لا تواجه ⁦Postcodes.io⁩ مشكلة في الرد على الاستعلامات البرمجية، لذلك هذا الأمر ليس ضروريا جدا في هذه الحالة. الناتج من كود بايثون موضح في الشكل 21.15.
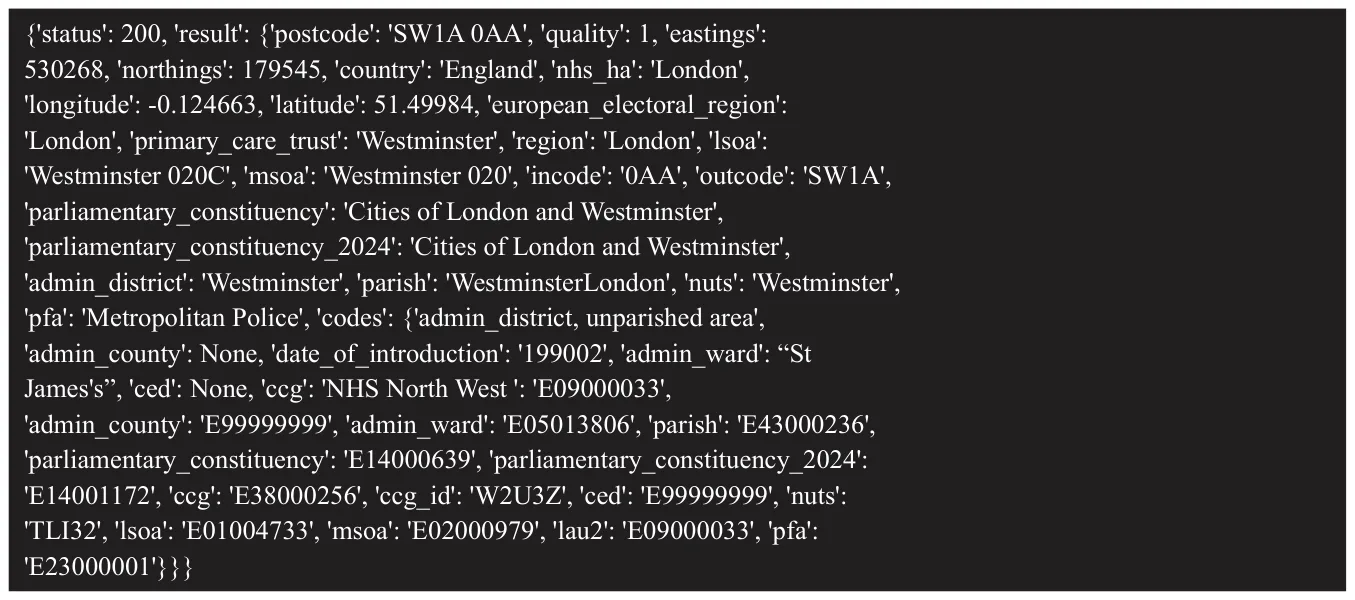
الشكل 21.15 ناتج كود بايثون.

المصطلح الرئيس رموز حالة ⁦HTTP⁩ - رموز عالمية مكونة من ثلاثة أرقام يصدرها الخادم عندما يستجيب للطلب المقدم من العميل، ورمز الحالة الذي يبدأ بالرقم 2 يشير إلى النجاح.

يجب أن تكون البيانات المستخرجة برمجيا بهذه الطريقة مطابقة للطلب اليدوي للمتصفح، ويجب أن تدرك أنه يشيع استخدام رموز حالة ⁦HTTP⁩ للإشارة إلى الطلبات السيئة/الرموز البريدية غير الموجودة، ويوضح الشكل 21.16 الإجراءات.
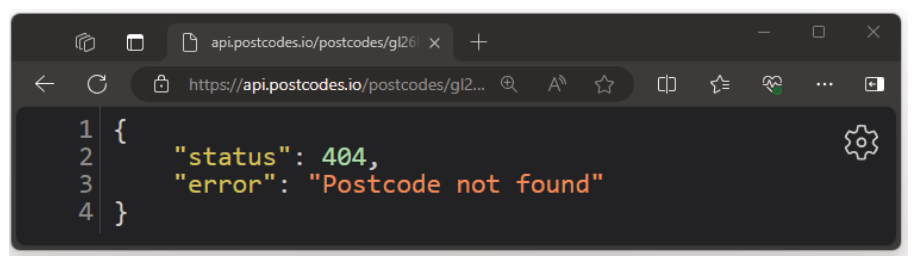
الشكل 21.16 رمز الحالة 404 وتفاصيل الخطأ اللذان يشيران إلى خطأ العميل.

وسائل التواصل الاجتماعي

الشكل 21.5 استخراج البيانات من الويب تقنية شائعة للحصول على البيانات لمشاريع الذكاء الاصطناعي. إنه يستخرج البيانات من موقع إلكتروني واحد أو أكثر لاستخدامها في مشاريع وحلول الذكاء الاصطناعي.
  • الخطوات الأساسية: حدد الموقع المستهدف، تحقق من بنية موقع إلكتروني، اكتب كود برنامج لجلب صفحات الويب، حلل محتوى ⁦HTML⁩، قم بتخزين البيانات بتنسيق منظم.
  • الحذر: قد يُعد هذا النشاط انتهاكًا لشروط خدمة الموقع، فيجب دائمًا التحقق من أن استخراج البيانات مسموح به.
  • المنتديات ولوحات الرسائل: تمثل مصدرا غنيا جدا للبيانات نظرا إلى تحديثها باستمرار بمحتوى مستخدم جديد.

نقطة البيع

مثال عملي: استخراج بيانات الدول

  • المثال العملي: كود بايثون نموذجي يستخرج بيانات من موقع مصمم للمتعلمين.
  • ⁦HTML⁩ الأساسي: مقتطف لبلد واحد هو جنوب أفريقيا.

أنظمة التجارة الإلكترونية

  • كود بايثون: يجمع البيانات من الموقع فيستخرج البيانات الرئيسة ويخزنها.

⁦B2C⁩ (المبيعات بين الشركات والمستهلكين)

  • الناتج: بعض البيانات المستخرجة بتنسيق ⁦JSON⁩ من الملف الذي تم إنشاؤه.
  • النتيجة: أصبحت البيانات نظيفة وخالية من أي محتوى متعلق بـ ⁦HTML⁩، فهي مناسبة للإدخال في أي عملية تعلم آلي.
  • سلسلة وكيل المستخدم: بعض المواقع لا تسمح بالطلبات البرمجية، وهذه القيمة تحدد لخادم الويب اسم أداة البرنامج التي تقدم الطلب.
  • التزييف: من الممكن انتحال سلسلة وكيل المستخدم ليقلد برنامجك عميل متصفح ويب أصلي.
  • واجهات برمجة التطبيقات العامة ⁦(API)⁩: قد توفرها مواقع أخرى للاستعلام عن مصادر البيانات الأساسية، وقد تكون مجانية أو تتطلب مفتاحًا قابلًا للشراء.

⁦B2B⁩ (المبيعات بين الشركات)

واجهات البيانات العامة ورموز الحالة

  • Postcodes.io: مشروع نشأ ببرنامج مفتوح المصدر بواسطة ⁦Ideal Postcodes⁩، يقدم خدمة مجانية للمطورين للبحث عن بيانات الرموز البريدية في المملكة المتحدة.
  • مجموعات مماثلة: ⁦postcode.eu⁩ لبلدان الاتحاد الأوروبي، و⁦getpostalcodes.com⁩ الذي فيه بيانات 12 منطقة بريدية في الأردن بما فيها عمان.
  • مفتاح النجاح: الجهود التعاونية من مجتمع المبرمجين لتحسين المشروع وإصلاح الأخطاء وإضافة وظائف جديدة عند الطلب.
  • نقاط النهاية: يوفر ⁦Postcodes.io⁩ عددًا منها للتحقق من بياناته، كالتحقق من وجود الرمز البريدي ومكانه.
  • الوصول: عبر نقطة النهاية بطلب ⁦HTTP GET⁩ من متصفح الويب أو بأداة سحب بيانات مخصصة بلغة بايثون.

⁦C2C⁩ (المبيعات بين المستهلكين)

  • سلسلة وكيل المستخدم المخادع: استُخدمت لتوضيح كيفية تنفيذ ذلك، لكن ⁦Postcodes.io⁩ لا تواجه مشكلة في الرد على الاستعلامات البرمجية.

⁦C2B⁩ (المبيعات بين المستهلكين والشركات)

  • رموز حالة ⁦HTTP⁩: يشيع استخدامها للإشارة إلى الطلبات السيئة أو الرموز البريدية غير الموجودة.
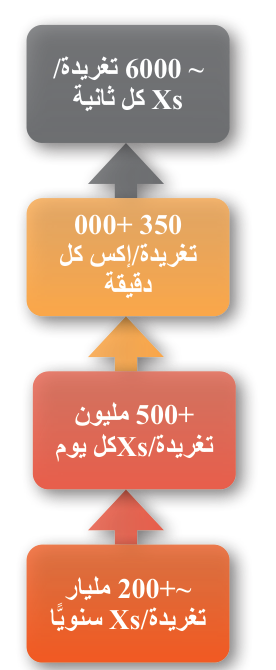
الشكل 21.17 إحصائيات توليد البيانات لموقع X (المعروف سابقا باسم تويتر).
الشكل 21.17 إحصائيات توليد البيانات لموقع ⁦X⁩ (المعروف سابقا باسم تويتر).

أجهزة إنترنت الأشياء ⁦(IoT)⁩

وسائل التواصل ونقاط البيع

  • وسائل التواصل الاجتماعي: أدى اعتمادها الواسع إلى زيادة مذهلة في البيانات المولدة.
  • ما تتضمنه: الرسائل والصور المحملة وجميع البيانات الوصفية المرتبطة بها (التاريخ والوقت والموقع الجغرافي وإبداء الإعجاب والردود وإعادة التوجيه).
  • استخدام المؤسسات: في خوارزميات التوصية، ولإنتاج إعلانات مستهدفة، وتُباع لأطراف ثالثة بحسب شروط وأحكام الاستخدام.
  • حجم البيانات: هذا يظهر ما يمكن لمستخدمي منصة ⁦X⁩ إنتاجه خلال مدة زمنية محددة، فـ 200 مليار تغريدة كمية هائلة من البيانات الجديدة.

المساعدون الأذكياء

  • نقطة البيع ⁦(PoS)⁩: تُجمع كمية هائلة من البيانات من أنظمتها في متاجر التجزئة، وفيها المعلومات اللازمة لمعالجة مشتريات كل عميل.
  • أنظمة مراقبة المخزون: يسمح لأنظمة التحكم بالحفاظ على مستويات المخزون ثابتة عن طريق طلب المخزون ليحل محل البنود التي تم بيعها.
  • البيانات الحساسة: لا يمكن الاحتفاظ بجميعها بعد المعاملة، وبعضها (رقم البطاقة ورمز التحقق) يخضع لمعايير أمان صارمة مثل ⁦PCI DSS⁩.
  • بطاقات الولاء: تزود العميل بتجربة تسوق محسنة، بما في ذلك خصومات نقدية، الوصول إلى العروض الخاصة داخل المتجر، عروض تسويقية مصممة خصيصا.
  • تتبع العادات: يقدم العملاء معلومات شخصية عند إنشاء الحساب، فيمكن تتبع سلوكيات وعادات التسوق على المدى القصير والطويل.
  • التحليل: بخوارزميات التعلم الآلي لفهم عادات الشراء وتفضيلاتها والتنبؤ بمبيعات المنتجات في أوقات وأماكن مختلفة.
  • الهدف: تحقيق الأرباح وجذب عملاء جدد والحفاظ على ولاء العملاء الحاليين.

بيانات معاملة نقطة البيع في أربع فئات.

أنظمة التدفئة الذكية

بيانات حامل البطاقةبيانات المعاملة
رقم البطاقة • اسم حامل البطاقة • تاريخ انتهاء الصلاحيةمعرف فريد تم إنشاؤه بواسطة نظام نقاط البيع • التاريخ • الوقت • المبلغ • العملة • اسم بائع التجزئة • رمز فئة التجزئة (على سبيل المثال، نوع النشاط التجاري)
بيانات الأمانالتفويض
قيمة التحقق من البطاقة ⁦(CVV/CVC)⁩ • بيانات شريحة ⁦EMV⁩ (يوروباي وماستر كارد وفيزا) • بيانات الشريط المغناطيسيرمز التفويض • رمز الاستجابة (على سبيل المثال، موافق عليه، مرفوض)

بيانات حساب بطاقة الولاء في أربع فئات.

أجهزة مراقبة صحية يمكن ارتداؤها

تفاصيل العميل الشخصيةبيانات المعاملة
الاسم • قنوات الاتصال • العنوان • رقم الهاتف • البريد الإلكتروني • رسالة نصية قصيرة • تفضيلات الاتصال • تاريخ الميلاد • معلومات الأسرة (الحجم، الأعضاء، وما إلى ذلك)تاريخ الشراء • تكرار التسوق • حجم السلة • عدد العناصر • التكلفة الإجمالية • طريقة الدفع • بطاقة (خصم أو ائتمان) • نقد • استرداد القسيمة
البيانات السلوكية وتفضيلات المستخدمبيانات المكافآت
تاريخ استخدام القسيمة • التسوق عبر الإنترنت • الردود على الترقيات • البريد الإلكتروني • الموقع الإلكتروني • رسائل البريد • تفضيلات المنتج (على سبيل المثال، الولاء للعلامة التجارية) • تفضيل الخدمة • خدمة التوصيل إلى المنزل • انقر واستلم • التسوق داخل المتجر • ملاحظات العملاءنقاط الولاء التي تم الحصول عليها • نقاط الولاء التي تم استردادها

الذكاء الاصطناعي في السيارات

التجارة الإلكترونية: أربعة أنواع

  • التجارة الإلكترونية: شراء وبيع المنتجات أو الخدمات عبر الإنترنت، تكمل المتاجر الفعلية أو تحل محلها.
  • بيانات المعاملات: تقوم جميع أنظمة التجارة الإلكترونية بجمع ومعالجة بيانات المعاملات، ويتم إنشاء كميات هائلة من البيانات في مراحل مختلفة.
  • التخطيط الإستراتيجي: تُستخدم بيانات المعاملات لقرارات المنتجات والخدمات الجديدة وتحديد ما اقترب عمره من النهاية.
  • التخطيط التشغيلي: إيجاد طرق جديدة للسوق وقنوات اتصال وتوسيع نطاق الأعمال.
  • التخطيط اليومي: إدارة الأفراد والفرق ونقل الموظفين للتغطية، وإدارة النقل بحسب الطقس، وإيجاد أسرع الطرق.

مصادر بيانات الشركات

  • B2C: يوفر فوائد، فمتاجر كثيرة لا تفتح 24 ساعة، وتتيح التجارة الإلكترونية طلب التسليم عبر الإنترنت ورؤية على مدار الساعة.
  • B2B: تستخدم العديد من منافذ البيع بالتجزئة التجارة الإلكترونية للتعامل مباشرة مع الشركات المصنعة وتجار الجملة.
  • C2C: يُستخدم لدى المستهلكين لتبادل السلع والخدمات أو بيعها، ويرى الكثير من الناس أن هذا النوع من إعادة الاستخدام أخلاقي للغاية.
  • المبيعات بين المستهلكين والشركات: شكل أقل شيوعًا يشمل الأفراد، مثل الفنانين والمصورين والمؤثرين، الذين يبيعون السلع أو الخدمات للشركات.
  • المنصات: تتطلب منصات تجارة إلكترونية قوية وآمنة بخدمات كالبحث وسلال التسوق وعمليات الدفع الآمنة.

تأثير حجم مجموعة البيانات على تخزينها واستخدامها

كما تمت مناقشته أعلاه، لتخزين البيانات، ستحتاج المؤسسات إما إلى الحصول على حلول محلية (داخلية) وإما استخدام مراكز بيانات ذات علامة بيضاء وإما الاستثمار في خدمات التخزين السحابي (وإما استخدام مزيج من هذه الحلول). يجب مراعاة المشكلات الآتية:

  • كلما كان حجم مجموعة البيانات أكبر، زادت سعة التخزين المطلوبة.
  • يجب أن تكون أنظمة التخزين آمنة.
  • يجب أن تكون أنظمة التخزين قابلة للتطوير لاستيعاب مجموعات البيانات سريعة النمو التي تجمعها الشركات.
  • يجب تحقيق قابلية التوسع دون تعطل أو أي تراجع في الأداء أو زمن الوصول.

    يمكن أن تكون تكاليف تخزين البيانات لمجموعات البيانات الكبيرة مكلفة للغاية، خاصة في حالة الحاجة إلى إتاحة البيانات دائمًا (أي يمكن الوصول إليها عند الحاجة). يقدم العديد من موفري الخدمات السحابية معدلات تخزين أقل تكلفة للبيانات التي يجب الوصول إليها بشكل أقل تكرارًا. في مثل هذه الحلول، يتم وضع البيانات بشكل أساسي في حالة (التجميد العميق) ولا يمكن الوصول إليها عادةً على الفور. ستكون تكلفة كل بايت لهذا النوع من تخزين البيانات أقل تكلفة بشكل ملحوظ من تكلفة تخزين البيانات المتوفرة دائمًا. هذا لا يختلف عن وضع مدخراتك في حساب التوفير المصرفي الذي يقدم فائدة أعلى - العائد أكبر، ولكن قد لا يتم سحب الأموال في أي لحظة.

المهارات المهارات المعرفية: العمليات والإستراتيجيات المعرفية:

  • حل المشكلات
  • اتخاذ القرار

استخدام البيانات الضخمة في حلول الذكاء الاصطناعي

تؤدي البيانات الضخمة دورًا مهمًا في تطوير أنظمة الذكاء الاصطناعي وفعاليتها، فهي مكتبة من المعلومات سريعة النمو، وتُجمع هذه المعلومات من الإنترنت، ووسائل التواصل الاجتماعي، وأجهزة إنترنت الأشياء ⁦(IoT)⁩، وأنظمة العالم الحقيقي، والهواتف المحمولة وما إلى ذلك، ما يعني ببساطة أنها الوقود الذي يشغل آلة الذكاء الاصطناعي. يُستخدم هذا الحجم الكبير من البيانات المصنفة وغير المصنفة لتدريب نماذج التعلم الآلي، ويتحقق ذلك عن طريق اختيار واستخراج الميزات ذات الصلة من كتلة البيانات الخام المتاحة. بالإضافة إلى ذلك، فإن الكميات الهائلة من البيانات المتاحة تمكن علماء البيانات من التحقق من صحة نماذجهم وتقييمها. ويضمن هذا الأمر قدرة نماذج الذكاء الاصطناعي على التعميم الجيد للبيانات التي لم تطلع عليها (حتى الآن)، بدلاً من التحيز المفرط تجاه البيانات المحدودة (أحيانًا) التي تم تدريبها عليها. أحد السمات الهامة للبيانات الضخمة هو السرعة التي يمكن بها استيعابها حديثًا في نظام الذكاء الاصطناعي. وهذا يساعد على تحديد المشكلات المحتملة (على سبيل المثال، الانحراف عن الأصل) ويضمن أن تظل التوقعات دقيقة في المواقف الواقعية المتغيرة بسرعة (على سبيل المثال، التغيرات في أسعار سوق الأسهم). لا يكمن التحدي المتمثل في التعامل مع تعقيد البيانات الضخمة في سياق الذكاء الاصطناعي في تخزينها وتنظيمها فحسب، بل أيضًا في فهمها وتفسيرها بشكل فعال.

المهارات المهارات المعرفية: العمليات والإستراتيجيات المعرفية:

  • التفكير الناقد

المهارات المعرفية: الإبداع:

  • الابتكار

المصطلح الرئيس البيانات الضخمة - هي مكتبة من البيانات سريعة النمو، وتُجمع هذه البيانات من الإنترنت، ووسائل التواصل الاجتماعي، وأجهزة إنترنت الأشياء ⁦(IoT)⁩، وأنظمة العالم الحقيقي، والهواتف المحمولة وما إلى ذلك.

المتقابلات الخمسة للبيانات الضخمة

المتقابلات الخمسة للبيانات الضخمة هي المعايير المستخدمة لوصف الخصائص (والتحديات) الرئيسة للبيانات الضخمة، وعادةً ما تكون العناصر الأربعة الأولى (الموضحة في الشكل 21.19) أساسية لتحقيق العنصر الخامس: قيمتها الإجمالية.
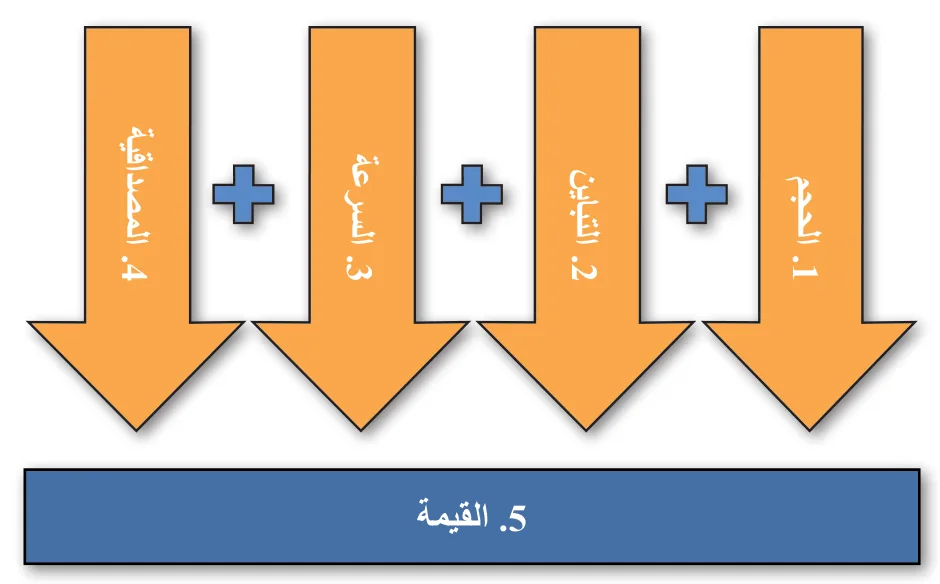
الشكل 21.19 الأبعاد الأربعة (أو الخمسة) للبيانات هي المعايير المستخدمة لتقييم مدى ملاءمة البيانات المكتسبة لغرض الذكاء الاصطناعي/التعلم الآلي.

الحجم

إنترنت الأشياء كمصدر للبيانات

  • الأجهزة: غالبًا تحتوي على أجهزة استشعار لالتقاط البيانات، وبرامج متخصصة لتوصيل وتبادل البيانات مع أنظمة أخرى.
  • التنوع: تختلف أجهزة إنترنت الأشياء في الحجم والتعقيد، من الآلات الصناعية إلى التكنولوجيا الشخصية القابلة للارتداء.
  • الذكاء الاصطناعي/التعلم الآلي: تجمع البيانات بطريقة تسمح بتحليلها لتحسين الأداء وتعزيز الكفاءة، مع مخاوف الخصوصية والأمان.
  • نظام أمان ذكي: كل تفاعل مع النظام سيؤدي عادةً إلى توليد المعلومات الآتية: ضبط جهاز تنبيه التاريخ والوقت، وإلغاء ضبطه.
  • الساعة الذكية: تلتقط بيانات عن التمرين الذي تم إجراؤه على مدار اليوم، ويتم تسجيل وقت التمرين، بالإضافة إلى السعرات الحرارية المحروقة.
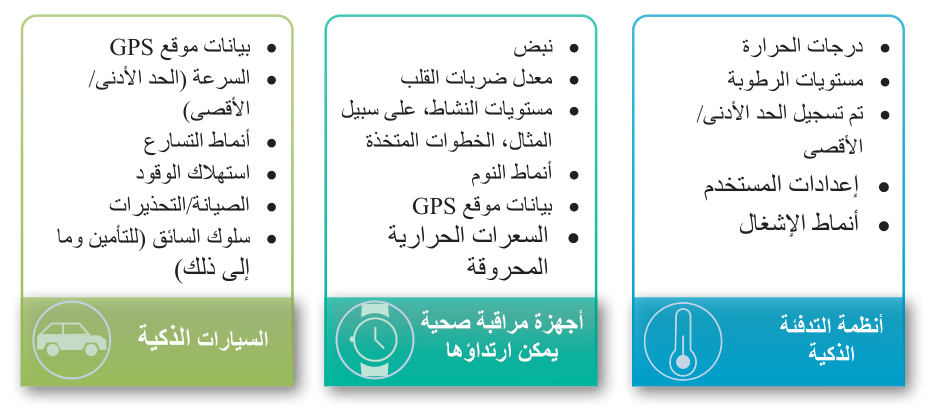
الشكل 21.18 أمثلة على البيانات التي تولدها أجهزة إنترنت الأشياء والتي يمكن جمعها وتحليلها.
  • أنظمة التدفئة الذكية: درجات الحرارة، ومستويات الرطوبة، والحد الأدنى/الأقصى، وإعدادات المستخدم، وأنماط الإشغال.
  • أجهزة مراقبة صحية يمكن ارتداؤها: نبض، ومعدل ضربات القلب، ومستويات النشاط، وأنماط النوم، وموقع ⁦GPS⁩، والسعرات المحروقة.
  • السيارات الذكية: بيانات موقع ⁦GPS⁩، السرعة (الحد الأدنى/الأقصى)، أنماط التسارع، استهلاك الوقود، الصيانة/التحذيرات، سلوك السائق.

التباين

  • المساعد الذكي: مثال شائع على إنترنت الأشياء، مثل سيري من أبل وأليكسا وإيكو من أمازون وجوجل نيست.
  • طريقة العمل: تستخدم الذكاء الاصطناعي لتمييز الكلام المعتمد على السحابة وتحويل الأوامر الصوتية إلى نص، ثم ينفذ الجهاز الأمر.
  • ما تسجله: موقع المستخدم ووقت التفاعل وتاريخه والسؤال المطروح والاستجابة ومقدار الوقت المستغرق، وهل ردت الإجابة بشكل صحيح.
  • حلقة التغذية الراجعة: استخدام هذه المعلومات لتحسين استجابات الخدمة للمستخدمين الآخرين.
  • أنظمة التدفئة الذكية: أجهزة استشعار درجة الحرارة والرطوبة تجمع البيانات في الوقت الفعلي، وبعضها يكتشف أنماط الإشغال.
  • الأجهزة الأكثر تقدما: يمكنها استخدام الذكاء الاصطناعي لتوقع الأوقات التي سيتم استخدام الغرف، وتحديد أفضل إعدادات درجة الحرارة والرطوبة، وهذا يساعد على تقليل استخدام الوقود.
  • أجهزة مراقبة الصحة القابلة للارتداء: يستخدمها الأفراد لمراقبة صحتهم، ويستخدمها الأطباء لعلاج الحالات الصحية ودعمها عن بُعد.
  • مرض السكري: يرسل الجهاز البيانات إلى جهاز الشخص وينصحه بالتصرف قبل حدوث نقص أو ارتفاع السكر في الدم.

السرعة

يشير إلى السرعة التي يتم بها إنشاء البيانات وتناولها ومعالجتها. بالنسبة للذكاء الاصطناعي، تعني السرعة العالية أن البيانات تتدفق إلى الأنظمة آنيةً أو شبه آنية. البيانات عالية السرعة تجعل أنظمة الذكاء الاصطناعي أكثر استجابة للتغيرات الظروف الواقعية، وتجعل توقعاتها أكثر دقة.

المصداقية

هذا هو قياس لجودة ودقة وموثوقية البيانات التي تم تناولها. أنظمة الذكاء الاصطناعي جيدة بقدر جودة البيانات التي تُغذى بها. فجودة المخرجات هي انعكاس لجودة المدخلات. ستنتشر بيانات ذات جودة سيئة وتتضخم عن طريق نظام الذكاء الاصطناعي، ما يؤدي حتمًا إلى نتائج معيبة وغير دقيقة. لهذا السبب، فإن التأكد من أن البيانات من مصدر موثوق هو خطوة مهمة في أي مشروع ذكاء اصطناعي.

القيمة

  • الذكاء الاصطناعي في السيارات: تسمح بيانات الموقع الجغرافي للشركات برؤية تقدم العناصر المسلمة براً وبحراً وجواً، ويراه العميل في تطبيق.
  • تطبيقات السفر: تعيد توجيه الرحلة تلقائيًا عند حادث أو عائق وتعيد حساب وقت الوصول، اعتمادًا على بلاغات المستخدمين.
  • سلوك القيادة: يمكن لأنظمة الذكاء الاصطناعي/التعلم الآلي التقاط معلومات حول سرعة القيادة وأنماط التسارع والفرملة لتحليله، لتقديم أسعار تأمين مخفضة.
  • الوقود والصيانة: تستخدم الشركات بيانات الوقود للتنبؤ بالتكاليف، وتحذيرات الصيانة لإصلاح السيارة قبل أن تتعطل.

البيانات النوعية مقارنة بالبيانات الكمية

بيانات الشركات وتخزينها

  • مصادر الشركات: واسعة ومتنوعة، لدعم العمليات اليومية ومساعدتها على اتخاذ قرارات إستراتيجية فعالة.
  • مصادر البيانات الداخلية الشائعة: السجلات المالية، بيانات الموارد البشرية، بيانات المبيعات والتسويق، بيانات العملاء، البيانات التشغيلية.
  • البيانات التشغيلية: المخزون، وسلسلة التوريد (النظام الذي يحول المواد إلى منتجات ويسلمها)، والخدمات اللوجستية (إدارة سلسلة التوريد).
  • التخزين: بعض المؤسسات تخزن بياناتها في مقراتها، وكثير غيرها نقلها إلى التخزين السحابي من أمازون أو جوجل أو مايكروسوفت، أو مراكز بيانات العلامة البيضاء.
  • الميزة الرئيسة لتخزين السحابة: أن البيانات المخزنة تُنسخ احتياطيًا عبر عدد من الآلات الافتراضية، ما يعني تقليل فرصة فقدان البيانات.
  • اختيار التخزين: يشمل المهارات التقنية الداخلية، وتكاليف التخزين، والتوافر، والتشريعات المحلية، والمخاوف الأمنية.
  • حجم مجموعة البيانات: كلما زاد زادت سعة التخزين المطلوبة، ويجب أن تكون الأنظمة آمنة وقابلة للتطوير دون تعطل أو تراجع في الأداء.
  • التكلفة: يمكن أن تكون تكاليف تخزين البيانات لمجموعات البيانات الكبيرة مكلفة للغاية، ويقدم العديد من موفري الخدمات السحابية معدلات تخزين أقل تكلفة للبيانات التي يجب الوصول إليها بشكل أقل تكرارا.

البيانات الكمية

البيانات الكمية أكثر تنظيمًا من البيانات النوعية، وهي مثالية لمعظم خوارزميات التعلم الآلي (الانحدار والتصنيف وما إلى ذلك)، لأنها تستهلك المدخلات الرقمية بكل سلاسة. بالإضافة إلى ذلك، تعمل الأساليب الإحصائية التقليدية بشكل جيد، ومن السهل تتبع التغييرات في البيانات الكمية بمرور الوقت. على الجانب السلبي، قد يتم فقدان الكثير من الفروق الدقيقة باستخدام نظام (تسجيل) بسيط. بالإضافة إلى ذلك، من الممكن أن تتضمن الأسئلة تحيزًا اعتمادًا على كيفية صياغتها، وهذا أمر قد يكون من الصعب اكتشافه إذا تم جمع البيانات الكمية فقط.

البيانات النوعية

  • البيانات الضخمة: تؤدي دورًا مهمًا في تطوير أنظمة الذكاء الاصطناعي وفعاليتها، فهي الوقود الذي يشغل آلة الذكاء الاصطناعي.
  • التدريب: يُستخدم الحجم الكبير من البيانات المصنفة وغير المصنفة لتدريب نماذج التعلم الآلي باختيار الميزات ذات الصلة من البيانات الخام.
  • التحقق: تمكن الكميات الهائلة علماء البيانات من التحقق من صحة نماذجهم وتقييمها، فتعمم جيدًا على بيانات لم تطلع عليها.
  • التحدي: لا يكمن في تخزينها وتنظيمها فحسب بل في فهمها وتفسيرها بشكل فعال.
  • المتقابلات الخمسة: المعايير المستخدمة لوصف الخصائص والتحديات الرئيسة للبيانات الضخمة، وأولها أربعة أساسية لتحقيق الخامس: قيمتها الإجمالية.

التحليلات الوصفية

البيانات الضخمة والمتقابلات الخمسة

ما المتقابلات الخمسة للبيانات الضخمة؟

التحليلات التشخيصية

هذه عملية تحاول فهم لماذا وقعت أحداث أو سلوكيات معينة. يمكن أن يساعد هذا في تحديد هذه العوامل السببية على تحسين تنبؤات الذكاء الاصطناعي والدقة الشاملة للنتائج. وسيكون التطبيق الواقعي لهذا هو مثال مؤسسة تجارية تدير أسطولًا من حافلات النقل العام. تريد الشركة التأكد من أن جميع مركباتها تعمل بكفاءة وأمان، كما أنها تريد تقليل الأعطال وطلبات الصيانة غير المتوقعة - وكلها تزيد التكاليف وتؤدي إلى عدم رضا العملاء. تقوم الشركة بتزويد كل حافلة بأجهزة استشعار الأشياء التي تراقب ضغط الإطارات ومستويات البطارية والكبح والسرعة وأداء المحرك وما إلى ذلك. وهذا يسمح لها بجمع البيانات في الوقت الفعلي واستخدام التحليل التشخيصي لتقييم حالة كل مركبة وعملياتها. هذا، بدوره، يسمح بتحديد الأنماط أو الحالات الشاذة التي قد تشير إلى تآكل غير مبرر، والتنبؤ بفشل مكون ميكانيكي أو كهربائي قبل أن يحدث فعليًا. يمكن بعد ذلك الإبلاغ عن هذه المعلومات إلى فريق الصيانة في المؤسسة. وهذا يسمح لهم بجدولة صيانة سريعة واستباقية نسبيًا. وهذا من شأنه أن يمنع حدوث الأعطال، ويزيد من مدة عمل الحافلات، ويبقى العملاء سعداء.

الاستخراج والتحويل والتحميل ⁦(ETL)⁩

  • الحجم: الكمية الهائلة من البيانات المنشأة والمخزنة، من تيرابايت إلى زيتابايت، فتوفر مجموعة أشمل لتدريب التعلم الآلي ودقة أفضل.
  • التباين: يشير إلى الأنواع المختلفة من تنسيقات البيانات ومصادرها، بما في ذلك البيانات المنظمة وشبه المنظمة وغير المنظمة.
  • السرعة: السرعة التي تُنشأ بها البيانات وتُتناول وتُعالج، وتجعل أنظمة الذكاء الاصطناعي أكثر استجابة وتوقعاتها أدق.
  • المصداقية: قياس جودة ودقة وموثوقية البيانات المتناولة، فجودة المخرجات انعكاس لجودة المدخلات.
  • البيانات ذات الجودة السيئة: ستنتشر وتتضخم عن طريق نظام الذكاء الاصطناعي، ما يؤدي حتما إلى نتائج معيبة وغير دقيقة.
  • القيمة: تحدد تقلبات البيانات وصحتها وحجمها هل هي ذات مغزى وجديرة بالتحليل، وهي معيار حاسم لأن بناء أنظمة الذكاء الاصطناعي مكلف.
  • العائد على الاستثمار: تحسين الكفاءة والإنتاجية، تحسين صنع القرار، تجربة محسنة للعملاء، منتجات وخدمات جديدة ومبتكرة، انخفاض المخاطر والتكلفة.

التحليلات التنبؤية

استخدام التقنيات الإحصائية ونماذج التعلم الآلي للتنبؤ بالأحداث المستقبلية بناءً على البيانات التاريخية. والمثال الجيد على استخدام هذه التقنية هو شركة تأمين تستخدم التحليلات التنبؤية لتحديد ملف المخاطر لعميل محتمل. وهو ما من شأنه أن يسمح للشركة بتحديد علاوة واقعية للعميل، وهي علاوة توازن بين المطالبات المحتملة والتكاليف التشغيلية وربما مقبولًا للخدمات التي تقدمها.

التحليلات الوصفية

هذه هي عملية اقتراح الإجراءات التي تجعل نتائج معينة أكثر احتمالًا أو تقلل فرصة حدوث بعض المخاطر على الإطلاق. التطبيق الواقعي لهذه العملية سيتم في عالم البيع بالتجزئة. يمتلك العديد من تجار التجزئة الكبار مراكز توزيع متعددة ومتاجر بيع بالتجزئة تنتشر في جميع أنحاء البلد. وهم بذلك يواجهون التحدي المتمثل في موازنة مستويات الأسهم عبر شبكات البيع. إنهم بحاجة إلى التأكد من أن متاجرهم تحتوي على الكميات المناسبة من السلع لتلبية طلبات العملاء المحليين. كما أنهم بحاجة إلى تجنب مخاطر المخزون الزائد غير الضرورية.

  1. يمكن للأنظمة التي تعتمد على الذكاء الاصطناعي معالجة مستويات البيانات التي تم جمعها من المواقع المختلفة.
  2. ويمكن لهذه الأنظمة بعد ذلك تحليل مستويات المخزون وأوقات الشحن وتوقعات طلب العملاء وعوامل أخرى.
  3. ويمكنها استخدام هذه المعلومات لمعرفة أنماط السلوك والتنبؤ بالمتطلبات المستقبلية للعناصر المختلفة في مواقع مختلفة.
  4. يمكن لشركة بيع بالتجزئة استخدام هذه الأفكار لبيان حجم التخزين الصحيح، وحركة وتخزين العناصر عبر شبكتها - ما يقلل الهدر، ويقلل فرص المبيعات المفقودة، ويزيد الأرباح.

تمثيل البيانات

هو عملية تقديم البيانات في شكل رسومي (مثل الرسوم البيانية والرسوم التوضيحية، وما إلى ذلك) التي تساعد على توصيل المعلومات الرقمية أو الفنوية الأكثر تعقيدًا بطريقة أكثر قابلية للفهم للفئة المستهدفة.

ب2 جمع البيانات وتجهيزها

  1. يركز هذا الموضوع على كيفية جمع البيانات وإعدادها. سيساعدك ذلك على فهم العملية المستخدمة لتحديد البيانات اللازمة من مصادر البيانات المناسبة.
  2. أحد أهم العوامل هو فهم أن البيانات قد لا تكون بتنسيق مناسب وقد لا تكون منظمة كما هو مطلوب.
  3. هذا يعني أن هناك حاجة إلى عمل إضافي لإعداد البيانات للاستخدام.
  4. بالإضافة إلى ذلك، يغطي الموضوع الاعتبارات الأخلاقية والتشريعية والأمنية التي يجب مراعاتها.

المهارات المهارات المعرفية: العمليات والإستراتيجيات المعرفية:

  • حل المشكلات
  • التفسير

مهارات التواصل الشخصي: أخلاقيات العمل/الضمير:

  • الإنتاجية

موضوعات ذات صلة راجع أجزاء مفهوم التحيز والحد من تأثير التحيز في مجموعات البيانات. اسأل نفسك عن سبب أهمية معالجة قضايا التحيز لجودة النتائج.

موضوعات ذات صلة راجع الجزء الخاص بجمع البيانات وتجهيزها. فكر في ما يجب القيام به من أجل إعداد البيانات لاستخدامها في مشروع. لماذا يجب إعداد البيانات؟

مبادئ وعمليات جمع البيانات وإعدادها لضمان بيانات عالية الجودة تناسب حلول الذكاء الاصطناعي يوضح هذا الجزء أفضل الممارسات التي يجب اتباعها عند جمع البيانات وإعدادها. يجب أن نتذكر دائمًا أن أحد الأسباب الأساسية لفشل مشاريع الذكاء الاصطناعي هو سوء اختيار البيانات وجمعها. يوجد خمس نقاط رئيسة يجب تذكرها عند جمع البيانات وإعدادها لحل الذكاء الاصطناعي.

1 فهم المتطلبات بشكل كامل تأكد من أن البيانات التي تم جمعها ذات صلة وتفي بمتطلبات مشروع الذكاء الاصطناعي الذي يتم العمل عليه. حدد أنواع البيانات المطلوبة وتنسيقاتها ومعدل تكرار جمعها (كل ساعة، يوميًا، شهريًا، وما إلى ذلك).

2 التأكد من دقة البيانات ومن اتباع ضوابط النزاهة تحقق من سلامة البيانات - تأكد من أن مصدر بياناتك الفعلي قانوني وآمن. يعد عقد البيانات طريقة جيدة لضمان هذه المعلومات وتسجيلها. تحقق من جودة البيانات - تحقق من عدم الاتساق والبيانات المكررة والبيانات المفقودة والأخطاء.

3 الحد من التحيز غير المقصود من خلال ضمان تنوع البيانات تأكد من أن البيانات تحتوي على القدر والفئة المناسبة من التنوع (على سبيل المثال، الديموغرافي والجغرافي، وما إلى ذلك). التأكد من أن ارتباط البيانات بسياق/طبيعة المشكلة التي تتم معالجتها.

4 التأكد من تطهير البيانات بشكل صحيح تطهير القيم المفقودة، والقيم الشاذة، والبيانات العشوائية غير الضرورية في مجموعة البيانات (البيانات العشوائية هي في الأساس بيانات غير ذات صلة يمكن أن تؤدي إلى مواقف غير متوقعة). تحويل البيانات باستخدام تقنيات التخطيط بحيث تكون جاهزة للاستخدام في نموذج تعلم آلي، وما إلى ذلك.

5 اتباع الإرشادات الأخلاقية والاعتبارات القانونية في جميع الأوقات قم بإخفاء هوية معلومات التعريف الشخصية ⁦(PII)⁩ حيثما أمكن ذلك. واحترم قوانين حماية البيانات والخصوصية المحلية (على سبيل المثال، اللائحة العامة لحماية البيانات في أوروبا).

بحث تتخصص مؤسستك في تقديم حلول تكنولوجيا المعلومات المصممة خصيصًا للقطاع المالي. نظرًا للظروف الصعبة في هذا المجال، تواجه الشركة صعوبة في الاحتفاظ بالموظفين ذوي المستوى الفني المناسب. ويبدو أن إحدى المسائل الرئيسة هي أن عدد الطلبات الواردة لأي وظيفة شاغرة معلن عنها مرتفع للغاية بحيث يتعذر على فريق الموارد البشرية معالجتها بسرعة. تم تقديم اقتراح لبناء حل تنبؤي بالذكاء الاصطناعي. سيتم تدريب هذا الحل على محتويات نماذج الطلبات التي سبق تقديمها ونتائج المقابلات. سيتم استخدامه بعد ذلك لتوفير نظام فرز أولي لتضييق نطاق الطلبات، قبل أن يقوم فريق الموارد البشرية بمعالجتها. ابحث عن المشكلات التي يجب أن تضعها في اعتبارك عند محاولة ضمان جمع بيانات عالية الجودة والتحضير لهذا النوع من حلول الذكاء الاصطناعي.

اختيار البيانات ومصادر البيانات المناسبة

الكمي والنوعي: أي بيانات أفضل؟

  • شكلان: تأتي البيانات عادةً في شكلين: نوعي أو كمي.

مقارنة البيانات النوعية بالكمية.

البيانات النوعيةالبيانات الكمية
تصف الصفات أو الخصائصرقمي، على سبيل المثال، الكميات، المبالغ، الدرجات، النطاقات، وما إلى ذلك.
غير رقميتم جمعها عبر مجموعات البيانات المنظمة والأسئلة المغلقة
تركز بقوة على 'لماذا؟' و'كيف؟'تصنيفات على نمط ليكرت، مثل '3 من 4'
تم جمعها من خلال الملاحظات والمقابلات والأسئلة المفتوحة واستطلاعات العملاء، وما إلى ذلك.سهل القياس والتحليل الإحصائي
  • كلا النوعين: يمثل قيمة كبيرة في البحوث واتخاذ القرارات، وغالبًا يكمل بعضهما بعضًا لتوفير فهم أكثر شمولًا.
  • السؤال النوعي والكمي: يؤثر اختيار الأسئلة تأثيرًا كبيرًا في مشروع الذكاء الاصطناعي بسبب البيانات الناتجة عنها.
  • الأفضل: لكل نوع نقاط القوة والضعف، لكن المشاريع الأكثر موثوقية تتضمن مزيجًا متزنًا من الاثنين.
  • البيانات الكمية: أكثر تنظيمًا، مثالية لمعظم خوارزميات التعلم الآلي (الانحدار والتصنيف)، وتعمل معها الأساليب الإحصائية التقليدية.
  • على الجانب السلبي: قد تُفقد الفروق الدقيقة بنظام تسجيل بسيط، وقد تتضمن الأسئلة تحيزًا بحسب صياغتها.
  • البيانات النوعية: توفر معلومات أكثر تفصيلًا عن الإعجاب والمشاعر والدوافع والأسباب الكامنة، وتشرح سياق النتائج الكمية.
  • على الجانب السلبي: غير منظمة وقائمة على النصوص، وتتطلب معالجة أكثر تعقيدًا، وقد تؤدي إلى مخرجات أكثر تعقيدًا تحتاج معرفة بالمجال.

تحديد أهداف المشروع أو المهمة

يساعد فهم أهداف مشروع الذكاء الاصطناعي على تحديد نوع البيانات المطلوبة للإجابة عن السؤال (الأسئلة) المحدد. على سبيل المثال، فإن النموذج المطلوب لإجراء التنبؤات الجوية سيحتاج إلى بيانات الطقس السابقة ليتم تدريبه بنجاح. ومع ذلك، إذا كنت تريد من الذكاء الاصطناعي التنبؤ باحتمالية حدوث السرقات في منطقة معينة، فستحتاج إلى الوصول إلى سجلات حوادث الشرطة و/أو مطالبات التأمين على المنازل. ببساطة، تتطلب الأهداف المختلفة بيانات مختلفة.

مراجعة البيانات المتاحة

من الممكن أن يكون لديك بالفعل حق الوصول إلى البيانات التي تطلبها. إذا كان هذا هو الحال، فلا داعي للحصول عليها بشكل منفصل. على سبيل المثال، قد تقوم المؤسسة بشكل روتيني بجمع البيانات المتعلقة بالأعمال التي تحتاج إليها في إطار عملياتها اليومية، لذلك يجب أن تحظى هذه البيانات بتخزين آمن. قد لا تكون بالتنسيق الصحيح، لكنها تمثل نقطة انطلاق جيدة، ما يوفر للشركة الوقت والمال الثمينين.

تحديد مدى سلامة وملاءمة البيانات الحالية المتاحة

تحديد أوجه القصور في البيانات الحالية في ما يتعلق بالأهداف

أنواع التحليلات: وصفي وتشخيصي وتنبؤي

  • التحليلات الوصفية: تحليل البيانات التاريخية لفهم ما حدث سابقًا، فتوفر رؤى حول الأنماط والاتجاهات.
  • تطبيق واقعي: منظمة تجزئة تفحص مبيعات الـ 12 شهرًا الماضية لتحديد كيف ولماذا ومتى صار منتجها الأكثر شعبية.
  • حدودها: لن يستكشف عادة الآثار المستقبلية.
  • التحليلات التشخيصية: عملية تحاول فهم لماذا وقعت أحداث أو سلوكيات معينة، فتحسن تنبؤات الذكاء الاصطناعي.
  • تطبيق واقعي: مؤسسة تزود حافلاتها بأجهزة استشعار تراقب ضغط الإطارات والبطارية والكبح والسرعة وأداء المحرك.
  • النتيجة: تحديد الأنماط أو الحالات الشاذة والتنبؤ بفشل مكون قبل أن يحدث، فتُجدول صيانة استباقية.
  • التحليلات التنبؤية: استخدام التقنيات الإحصائية ونماذج التعلم الآلي للتنبؤ بالأحداث المستقبلية بناءً على البيانات التاريخية.
  • مثال: شركة تأمين تحدد ملف المخاطر لعميل محتمل لتحديد علاوة واقعية.

ما عملية تحليل البيانات التاريخية لفهم ما حدث سابقًا؟

جمع البيانات وتجهيزها للمشروع

  1. يجب على مستخدمي البيانات الحرص على الحصول على البيانات التي ستكون مناسبة للمشروع، سواء من حيث الهيكل أو الشكل.
  2. قد يؤدي عدم القيام بذلك إلى عدد من الصعوبات المحتملة في مخرجات المشروع.
  3. في هذا الجزء ستتعرف بعض الطرق التي يمكن أن يحدث بها ذلك والتأثير الذي سيترتب عليها.

وقفة للتفكير هل سبق لك أن جمعت بيانات لمشروع ما؟ هل قدم شخص ما بيانات؟ هل كانت البيانات متاحة بسهولة على الإنترنت؟ أم كان عليك إنشاء استبيان؟ تلميح فكر في السياق الذي كنت بحاجة فيه إلى البيانات والأسباب التي دفعتك لاختيار مصدر بيانات معين. توسيع الأفق لماذا احتجت إلى استخدام هذا المصدر بالذات؟ ما الذي كان بإمكانك فعله أيضًا؟

المصطلح الرئيس تمام الملاءمة - الحالة التي تتناسب فيها البيانات مع نموذج إحصائي بدقة بحيث لا يمكن استخدامها في أمثلة أكثر عمومية، أي أن تركيزها ضيق أو محدد للغاية.

مفهوم التحيز

  • الاستخراج والتحويل والتحميل: معالجة هندسية للبيانات تتكون من ثلاث مراحل أساسية.
  • المراحل الثلاث: استخراج البيانات من عدد من المصادر المختلفة، تعيين البيانات الأصلية إلى مجموعة جديدة بتنسيق ثابت، تحميل مجموعة البيانات الجديدة إلى موقع قابل للمشاركة، عادةً على السحابة.
  • ELT: عكس مرحلتي التحويل والتحميل بفضل أدوات التحويل على السحابة وتخزينها الأقل تكلفة، وأصبح الخيار المفضل.

تحيز غير مقصود

يمكن أن يحدث التحيز غير المقصود لعدد من الأسباب المختلفة، بما في ذلك طرق جمع البيانات الفعلية المستخدمة (على سبيل المثال، بسبب مشكلات في أخذ العينات أو القياس). كما يوحي الاسم، فإن هذا النوع من التحيز يرجع في الغالب إلى الجهل أو الإهمال، وغالبًا ما يحدث بسبب خطأ بشري. تحدث مشكلة متكررة وشائعة عندما يُطلب منه إجراء تنبؤات بناءً على بيانات واقعية استُخدمت في تدريب الذكاء الاصطناعي. تضمنت إحدى الحالات الشهيرة للتحيز غير المقصود قيام منظمة رائدة بتدريب نظام الذكاء الاصطناعي الخاص بها لتصفية المتقدمين للوظائف، حيث كان هناك شعور بأن هذا سيجعل العملية أكثر كفاءة. ومع ذلك، فإن البيانات التدريبية المستخدمة كانت تتكون من عينات جاءت أصلًا من متقدمين ناجحين من الرجال. نتيجة لذلك، قام نظام الذكاء الاصطناعي بتقييم طلبات النساء بشكل سيء للغاية. وبعد أن بدا الأمر وكأن الذكاء الاصطناعي يميز ضد النساء، سحبت المنظمة الخدمة. التحيز غير المقصود تسبب أيضًا في مشكلات عندما استُخدمت أداة فحص الذكاء الاصطناعي لتمييز أعراض سرطان الجلد. أوضحت البيانات المتحيزة أن الأعراض لدى الأشخاص ذوي البشرة الداكنة لم يتم تحديدها بدقة. كان هذا بسبب تغذية بيانات التدريب بمزيد من صور الوجوه البيضاء. كلا الحالتين نشأتا من مشكلات في تنوع البيانات التي أدت إلى التحيز ونتائج أسوأ لبعض فئات السكان. ومن نتائج هذا النوع من التمييز هو أن الثقة في أنظمة الذكاء الاصطناعي تتضرر.

المصطلحات الرئيسة التحيز المؤسسي - يُقصد به التحيز المترتب على سياسات وإجراءات المنظمة المصممة للعمل بطريقة معينة تصب في مصلحة بعض الفئات الاجتماعية أو الأفراد أو تلحق الضرر بها. التحيز الهيكلي - هو مفهوم أوسع نطاقًا يشير إلى الحفاظ النظامي على عدم المساواة بين مجموعات اجتماعية مختلفة أو أفراد.

التحيز الخوارزمي

  • التحليلات الوصفية الإرشادية: اقتراح الإجراءات التي تجعل نتائج معينة أكثر احتمالًا أو تقلل فرصة حدوث بعض المخاطر.
  • تطبيق واقعي: تجار التجزئة الكبار يوازنون مستويات الأسهم عبر شبكات البيع ويتجنبون المخزون الزائد.
  • الأنظمة: تحلل مستويات المخزون وأوقات الشحن وتوقعات الطلب، فتقلل الهدر وفرص المبيعات المفقودة وتزيد الأرباح.
  • تمثيل البيانات: عملية تقديم البيانات في شكل رسومي (مثل الرسوم البيانية والرسوم التوضيحية) التي تساعد على توصيل المعلومات بطريقة أكثر قابلية للفهم.

التحيز النظامي

التحيز النظامي هو مصطلح واسع المعنى يصف الحالة التي تُصمم فيها عملية معينة لدعم مجموعة معينة من النتائج، ونظرًا لأن هذا الأمر يحدث غالبًا داخل المؤسسات الكبيرة، ففي معظم الأحيان يُستخدم المصطلح إلى جانب التحيز المؤسسي أو الهيكلي. وغالبًا ما يحدث هذا النوع من التحيز بسبب التحيز المعرفي - الطريقة التي يطور بها الناس نظرة ذاتية (غير موضوعية) للعالم ويتخذون قرارات لا تبدو عقلانية (على سبيل المثال، الحكم على الناس بناءً على مظهرهم، بدلاً من الأمور التي يمكنهم القيام بها). ومن الممكن أن ينتقل هذا التحيز إلى نظام الذكاء الاصطناعي.

هل يمكن أن يكون التحيز جيدًا في الذكاء الاصطناعي؟

جمع البيانات وتجهيزها: خمس نقاط

  • جمع البيانات وإعدادها: من أهم العوامل أن البيانات قد لا تكون بتنسيق مناسب أو منظمة كما هو مطلوب، فيلزم عمل إضافي.
  • الاعتبارات: يغطي الموضوع الاعتبارات الأخلاقية والتشريعية والأمنية التي يجب مراعاتها.
  • أسباب الفشل: أحد الأسباب الأساسية لفشل مشاريع الذكاء الاصطناعي سوء اختيار البيانات وجمعها.
  1. افهم المتطلبات: تأكد من صلة البيانات وحدد أنواعها وتنسيقاتها ومعدل جمعها.
  2. تأكد من الدقة: تحقق من سلامة البيانات وجودتها ومصدرها القانوني.
  3. نوّع البيانات: احرص على تنوع مناسب لتقليل التحيز غير المقصود.
  4. طهّر البيانات: عالج القيم المفقودة والشاذة والعشوائية وحوّلها للنموذج.
  5. اتبع الأخلاقيات: أخفِ الهوية الشخصية واحترم قوانين الخصوصية.
  • فهم المتطلبات بشكل كامل: تأكد من أن البيانات ذات صلة وتفي بمتطلبات المشروع، وحدد أنواعها وتنسيقاتها ومعدل تكرار جمعها.
  • سلامة البيانات: تأكد من أن مصدر بياناتك قانوني وآمن، وعقد البيانات طريقة جيدة لضمان ذلك وتسجيله.
  • جودة البيانات: تحقق من عدم الاتساق والبيانات المكررة والبيانات المفقودة والأخطاء.
  • التحيز غير المقصود: تأكد من أن البيانات فيها القدر والفئة المناسبة من التنوع (الديموغرافي والجغرافي).
  • تطهير البيانات: تطهير القيم المفقودة والقيم الشاذة والبيانات العشوائية غير الضرورية، وتحويلها لتكون جاهزة لنموذج التعلم الآلي.
  • الأخلاقيات والقانون: إخفاء هوية معلومات التعريف الشخصية ⁦(PII)⁩ حيثما أمكن، واحترام قوانين حماية البيانات والخصوصية المحلية.

ماذا يمكننا أن نقول باختصار عن التحيز؟

اختيار البيانات ومصادرها

  • نظام الذكاء الاصطناعي: جزء من سلسلة التوريد الكاملة، يستخدم البيانات ويوفر نتائج تساعد المستخدمين على قرارات مستنيرة.
  • تحديد الأهداف: يساعد على تحديد نوع البيانات المطلوبة، فالأهداف المختلفة تتطلب بيانات مختلفة.
  • مثال: النموذج المطلوب لإجراء التنبؤات الجوية سيحتاج إلى بيانات الطقس السابقة، وللتنبؤ بالسرقات ستحتاج إلى سجلات حوادث الشرطة.
  • مراجعة البيانات المتاحة: قد تملك المؤسسة بالفعل حق الوصول إلى ما تحتاج، فلا داعي لجمعه منفصلًا ويوفر الوقت والمال.
  • إذا لم تكن البيانات متاحة داخل الشركة: فيجب الحصول عليها، وقد يكون من الضروري إنشاء أنظمة للمراقبة أو التغذية اللازمة لجمع البيانات.

الحد من تأثير التحيز في مجموعات البيانات

يوجد عدد من الطرق للحد من تأثير التحيز في مجموعات البيانات. يرد في ما يأتي خمس نصائح أساسية عليك مراعاتها. 1 احذر من التحيز في أخذ العينات. 2 تأكد من أن البيانات لها تمثيل متنوع، باستخدام مجموعة من المصادر المختلفة لمنع التمثيل الناقص لعناصر معينة من السكان. 3 نظف البيانات بعناية قبل استخدامها لاكتشاف أي تحيزات محتملة أو بيانات مفقودة أو انحرافات غير متوقعة. 4 استخدم الخوارزميات التي يمكنها اكتشاف التحيز والإبلاغ عنه. 5 تحقق من صحة القرارات وقيمها باستخدام مقاييس العدالة - ابحث بنشاط عن أي تحيزات غير متوقعة تحدث (وقم بمواجهتها). نصيحة مهمة أخرى هي التفاعل مع مجموعة متنوعة من أصحاب المصلحة خلال جميع مراحل مشروع الذكاء الاصطناعي - من البداية إلى النهاية. وجود وجهات نظر متعددة حول نتائج الذكاء الاصطناعي يمكن أن يكون مفيدًا في تسليط الضوء على التحيز وتحديد القرارات السيئة المحتملة.

تحديد مصادر البيانات المناسبة والموثوقة والوصول إليها

عادةً ما يكون إنشاء مصدر بيانات مناسب لحلول الذكاء الاصطناعي مهمة مهندس البيانات، إذ سيقوم بالجمع الأولي للبيانات، وينظفها، ويخططها، ويوحدها - ربما من عدد من مصادر البيانات المتباينة (على سبيل المثال، استجابات واجهة برمجة التطبيقات، ملفات ⁦CSV⁩، قواعد البيانات، وما إلى ذلك). يوجد عدد من الطرق المختلفة التي يمكن لمهندس البيانات من خلالها الحصول على البيانات من مصادر موثوقة. وتشمل الآتي:

  • مقابلات أصحاب المصلحة - عادةً ما تكشف هذه المقابلات عن مصادر البيانات الرئيسة المستخدمة في عمليات سير العمل وممارسات الأعمال وما إلى ذلك.
  • واجهات برمجة التطبيقات - غالبًا ما تكون واجهات برمجة التطبيقات المستندة إلى الويب والخدمات الأخرى مصحوبة بوثائق احترافية توضح مصادر البيانات المختلفة ونقاط النهاية للوصول إليها وتنسيق الاستجابات اللازمة.
  • مجموعات البيانات العامة/المفتوحة - تنشر العديد من المنظمات (بما في ذلك الوكالات الحكومية والهيئات الصناعية والمنظمات البحثية) مجموعات بيانات قابلة للتنزيل مجانًا.
  • حوكمة البيانات - تقوم المؤسسات عادةً بإنشاء إجراءات حوكمة للامتثال لمتطلبات شهادة معالجة البيانات الدولية وأفضل الممارسات. غالبًا ما تحتوي هذه المعلومات على معلومات حول مصادر البيانات المفيدة.
  • مستودعات البيانات وأنظمة الملفات - تخزن العديد من المنظمات بياناتها في مقراتها أو تستخدم مراكز بيانات ذات علامة بيضاء أو خدمات تخزين سحابية. قد تكون بعض البيانات في شكل أشكال التحكم في الإصدار. تصف الوثائق وسجلات الوصول عادة مواقعها.
  • قوائم جرد البيانات - الإجراء المثالي هو توثيق جميع مصادر البيانات، مع استخدام (عقود) البيانات الرسمية لتحديد المصادر والملكية وإمكانية الوصول والاستخدام المسموح به ومعلومات الاتصال وما إلى ذلك.

    بالإضافة إلى ذلك، من الممكن استخدام أدوات (اكتشاف) البيانات الآلية لتحديد مصادر البيانات (الملفات وقواعد البيانات وواجهات برمجة التطبيقات وما إلى ذلك) التي تستخدمها التطبيقات الحالية. الوجهة المعتادة لأي مصدر بيانات جديد هي السحابة، ويرجع ذلك أساسًا إلى حجمها وتوافرها وقابليتها للتطوير.

بحث الموقع الرسمي للحكومة الإلكترونية الأردنية متاح عبر الإنترنت ويستضيف منصة البيانات الحكومية المفتوحة الخاصة بهم. تحتوي هذا البوابة المصنفة بشكل جيد والقابلة للبحث على مجموعات بيانات مفتوحة عالية الجودة متاحة بتنسيقات قابلة للقراءة آليًا (على سبيل المثال، ⁦CSV⁩، ⁦XLSX⁩، وما إلى ذلك) يمكن تنزيلها ومراجعتها. يمكن استخدام هذا المورد العام لتحديد مصادر البيانات المناسبة للمعلومات الآتية:

  • استهلاك الطاقة
  • عدد حالات الحروق في مستشفيات وزارة الصحة لعام 2021
  • عدد القضايا المستلمة والمسجلة بحسب الموقع ونوع المحكمة لعام 2023
  • المواليد الأردنيون لعام 2022 بحسب الولادة والجنس.

ابحث وراجع مصدر بيانات مفتوح آخر ذي صلة يمكنك العثور عليه وتحديد مدى ملاءمته وجودته وتنسيقات البيانات المتاحة. اسأل نفسك: هل البيانات موثوقة جيدًا؟

إعداد البيانات الجاهزة للاستخدام

  • السؤال الحاسم: هل تحتوي البيانات على الميزات الضرورية لمعالجة هدف المشروع، وهل تجيب عن السؤال الأساسي له؟
  • الأسئلة: هل من السهل الوصول إلى البيانات؟ وهل المصدر موثوق وصادق؟ وهل البيانات دقيقة وحديثة وذات نوعية جيدة؟
  • أيضًا: هل تحتوي البيانات على تنوع مناسب؟ هل تحتوي على الحجم الكافي لكل من التدريب والاختبار؟ هل هناك أي قيود قانونية أو فنية؟
  • المتقابلات الخمسة: كثير من هذه الأسئلة تشير مباشرة إليها، لأن الهدف تحديد البيانات ذات القيمة الجيدة.
  • التحليل الأولي للبيانات: من الجيد إجراء تحليل أولي للإجابة عن هذه الأسئلة، وإذا كانت الإجابات تثير أي شكوك حول مصدر البيانات فقد ترغب في البحث عن مصدر آخر.
  • اختبار تجريبي صغير: عادةً ما يكون فكرة جيدة لتقييم مدى جودة تدريب البيانات للخوارزمية التي اخترتها، وهو مفيد دائمًا قبل الالتزام بشراء الترخيص لمصادر البيانات الخارجية.

تنظيف البيانات

هناك العديد من التحديات المختلفة التي ينطوي عليها تنظيف البيانات كجزء من عملية التحضير.

  • تتمثل المشكلة الأولى في إزالة أي إدخالات غير قابلة للتطبيق/غير متوفرة قد تكون موجودة في مجموعة البيانات. يجب أيضًا إزالة الفراغات لأنها لا تضيف أي قيمة للبيانات وقد تمنع المعالجة.
  • في بعض الأحيان قد تحتاج حقول البيانات إلى التقسيم أو الدمج. على سبيل المثال، قد يلزم تقسيم حقل واحد إلى حقلين (على سبيل المثال، الاسم الأول واسم العائلة)، أو قد يلزم ضم حقلين في حقل واحد (على سبيل المثال، الاسم الأول واسم العائلة في الاسم). سيعتمد هذا على طبيعة المعالجة المطلوبة.
  • من الشائع أيضًا العثور على تناقضات في البيانات. خطأ شائع يحدث عند استخدام تنسيقات حالة مختلفة لنفس عنصر البيانات (على سبيل المثال، مزيج من الأحرف الصغيرة، الأحرف الكبيرة في اللغة الإنجليزية، حالة العنوان، وما إلى ذلك). يجب أن يكون موحدًا.
  • يمكن أن يكون تنسيق البيانات الموجهة (على سبيل المثال، تاريخ اليوم والشهر والسنة) مشكلة أيضًا إذا كان تنسيقها يختلف (على سبيل المثال، بين الأوروبي (يوم/شهر/سنة) والأمريكي (شهر/يوم/سنة)).
  • قد تمثل القيم المفقودة مشكلة أيضًا (على سبيل المثال، في سلسلة زمنية حيث قد تكون نقاط بيانات غائبة أحيانًا). عادةً ما يتم تعبئتها أو إزالتها أو وضع علامة عليها.
  • إخفاء هوية البيانات أمر بالغ الأهمية أيضًا، لا سيما عند مراعاة تشريعات حماية البيانات المحلية ومخاوف حوكمة البيانات بشأن المعالجة الأخلاقية للبيانات الشخصية. قد يعني هذا إزالة معلومات التعريف الشخصية غير الضرورية من مجموعة البيانات.

إزالة التكرار

  • جمع البيانات للمشروع: يجب الحرص على بيانات مناسبة للمشروع من حيث الهيكل والشكل.
  • عدم القيام بذلك: قد يؤدي إلى عدد من الصعوبات المحتملة في مخرجات المشروع.

دمج/تجميع مجموعات البيانات

التحيز في البيانات: ما هو وكيف نحدّ منه؟

  • التحيز: إحدى أكثر المشكلات شيوعًا عند إعداد مجموعات البيانات، ويحدث عندما تُمثَّل ميزات معينة بشكل متكرر أو يُرجَّح استخدامها بشكل أكبر.
  • أشكال التحيز: التحيز في الاختيار، التحيز في التمثيل، التحيز الثقافي، التحيز التاريخي، وبعضها يمكن أن يصعب تحديده للغاية.
  • أخطاء في التحليل: قد يكون جمع البيانات متحيزًا عن غير قصد تجاه مجموعة معينة، وتعمل خوارزميات التعلم الآلي بشكل أفضل عندما تكون عامة.
  • مستويات الدقة: غالبًا تتأثر عندما لا تمثل البيانات جميع الجوانب ذات الصلة، وتعني المنخفضة بشدة أن النموذج لا يعمل على النحو الأمثل.
  • نتائج منحرفة ومشوهة: عند اختراق مستويات الدقة يُحتمل جدًا إنتاج نتائج منحرفة، وقد تسبب مشكلات في العالم الحقيقي.
  • مخاوف: توصيات متحيزة في التوظيف، وفي الموافقة على القروض والرهون، وفي عروض التأمين الصحي، وفي تحديد المجرمين المحتملين.

هذه معاينة من الموضوع. أكمل القراءة في التطبيق

كمّل قراءة الموضوع

سجّل مجاناً وكمّل الموضوع من الكتاب، ومنرجّعك لنفس المكان.

  • ب1 بيانات الذكاء الاصطناعي
  • أنواع مختلفة من البيانات
يلّا نبدأتسجيل الدخول

آخر تحديث:

معاينة موضوع «نتاج التعلم ب: تخطيط حل الذكاء الاصطناعي وإعداده لتلبية احتياجات محددة» من وحدة «مقدمة إلى الذكاء الاصطناعي AI» في مادة مقدمة في الذكاء الاصطناعي. أقسام الشرح: ٦٠، التعريفات: ١٠، الأسئلة المحلولة: ٥.

المصدر: بيرسون، نتاج التعلم ب: تخطيط حل الذكاء الاصطناعي وإعداده لتلبية احتياجات محددة (ص ٢١٤–٢٥٢)

موضوعات أخرى في الوحدة

تابع الدراسة