
الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
تطوير حل الذكاء الاصطناعي لتلبية احتياجات محددة
- بعد التخطيط والإعداد لإنشاء حل للذكاء الاصطناعي، يقدم لك هذا الموضوع الإجراءات اللازمة للمضي قدمًا بالخطة وتطوير الحل رسميًا.
من كتاب مقدمة في الذكاء الاصطناعي المقرّر
الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
بعد التخطيط والإعداد لإنشاء حل للذكاء الاصطناعي، يقدم لك هذا الموضوع الإجراءات اللازمة للمضي قدمًا بالخطة وتطوير الحل رسميًا. في هذا الجزء، ستستكشف مجموعة من الخوارزميات المكتوبة بلغة بايثون.
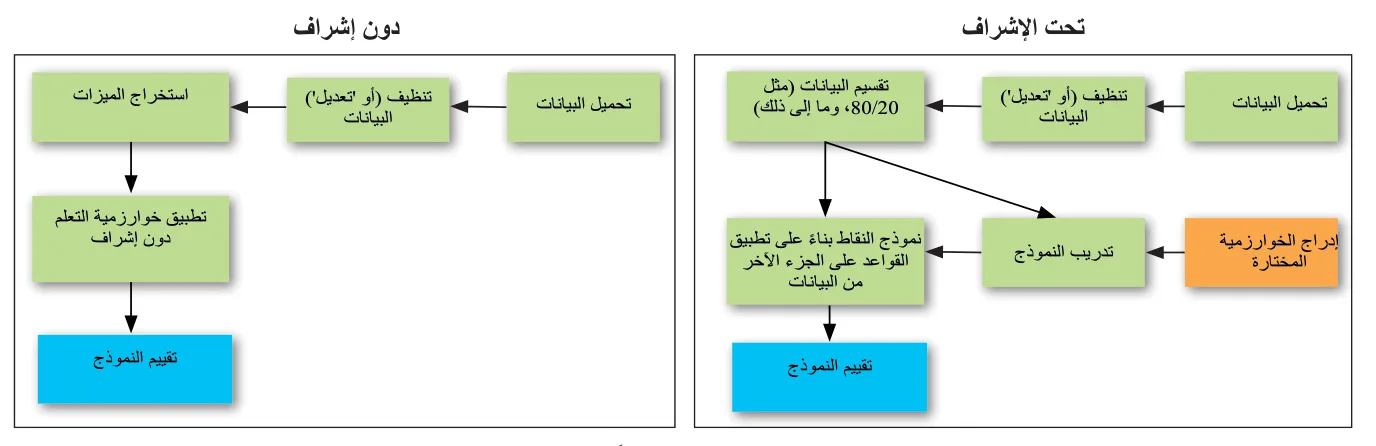
| التعلم تحت الإشراف | التعلم دون إشراف |
|---|---|
| • مدخلات بيانات التدريب معنونة يدويًا | • مدخلات البيانات غير معنونة |
| • مقترن بمخرجات متطابقة | • يتم تحديد الأنماط داخل مدخلات البيانات |
| • يمكن أن يكون مستهلكًا للوقت ومكلفًا | • الهدف هو تحديد الأنماط أو الهياكل المخفية في البيانات؛ واكتشاف أوجه التشابه والاتجاهات وما إلى ذلك. |
| • الهدف هو التنبؤ بمخرجات البيانات غير الموجودة في مجموعة التدريب الخاصة بها من خلال علاقات التعلم بين المدخلات والمخرجات. | • أقل تكلفة مع انخفاض التفاعل البشري |
| • تشمل الخوارزميات الكلاسيكية التصنيف والانحدار | • تشمل الخوارزميات الكلاسيكية التجميع وتقليل الأبعاد |
| • التطبيقات الشائعة: تصفية البريد الإلكتروني أو تعرف الصور أو الصوت وما إلى ذلك. | • التطبيقات الشائعة: تحليل السوق واكتشاف الحالات الشاذة وما إلى ذلك. |
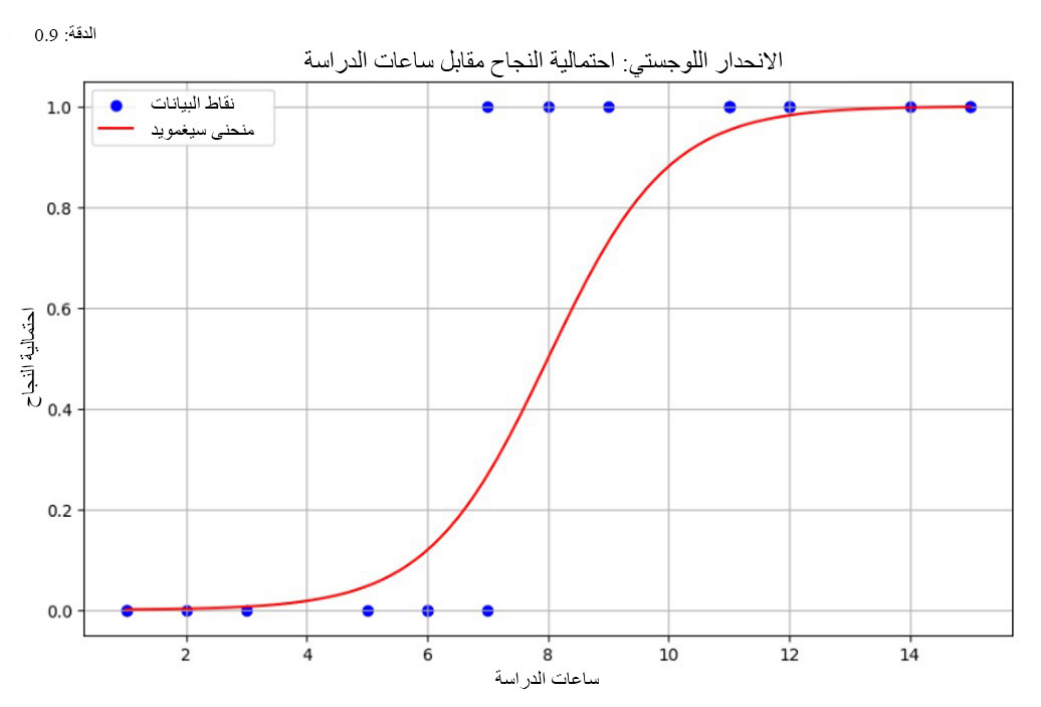
ما نوع المخرجات التي تحققها خوارزمية الانحدار وخوارزمية التصنيف؟
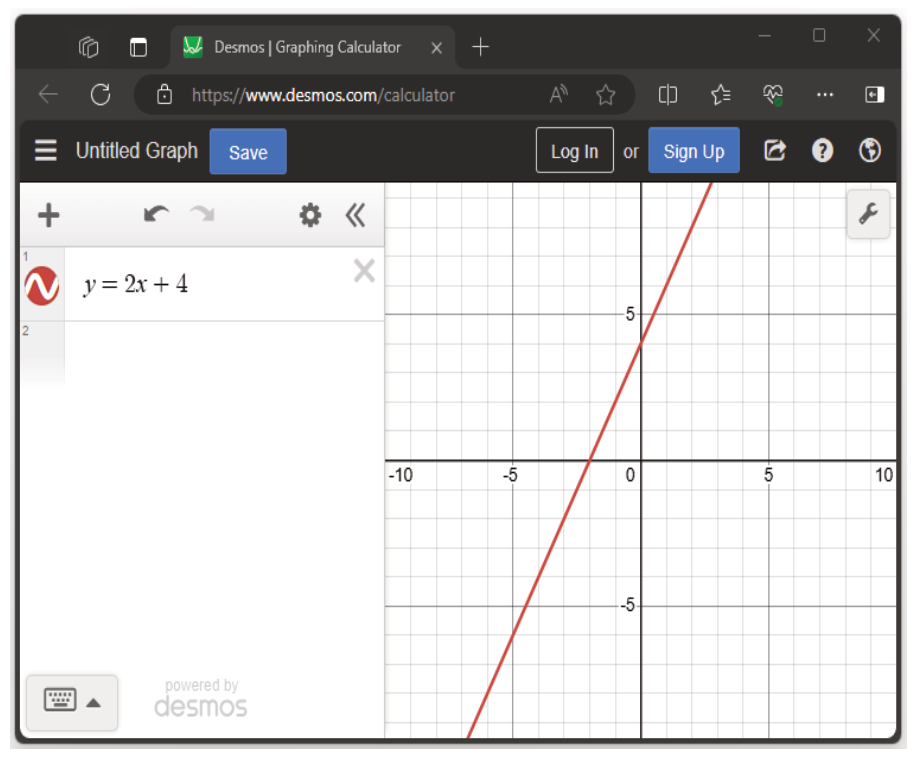
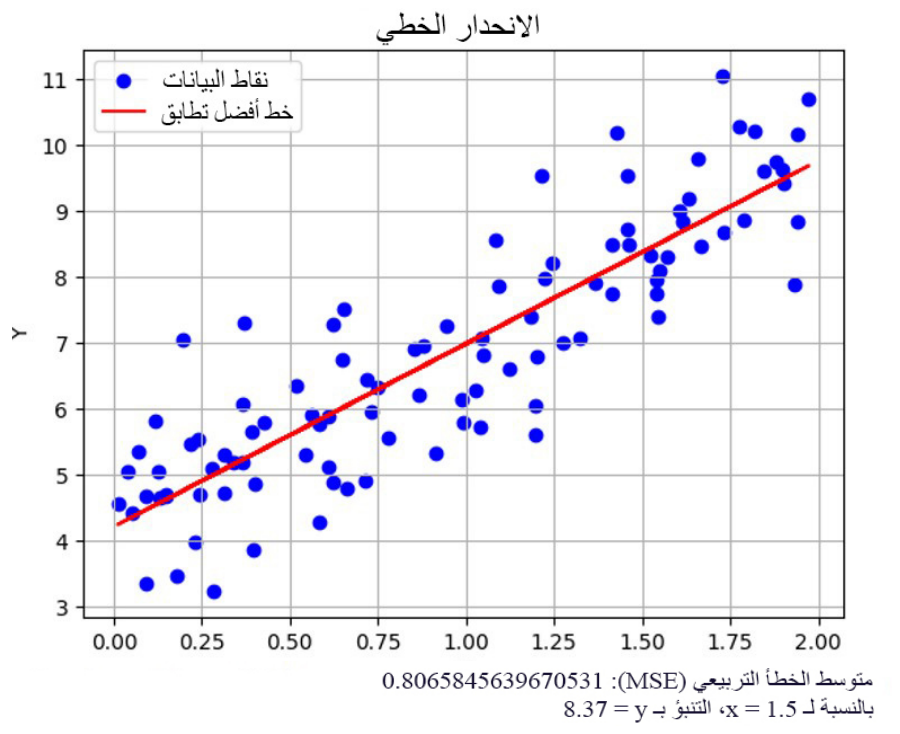
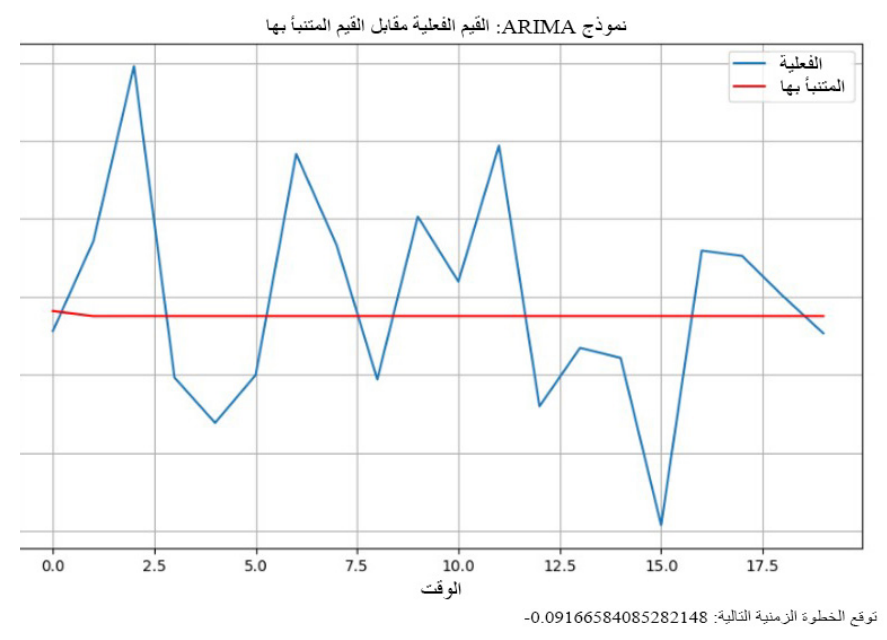
| AR | I | MA |
|---|---|---|
| • = الانحدار الذاتي - نماذج العلاقة بين الملاحظة والقيمة السابقة - يفترض أن القيمة تعتمد على قيمها السابقة | • = متكامل - يستخدم تقنية تسمى التمييز - يتضمن ذلك محاولة إزالة الاتجاهات والفترات من البيانات (والتي تسبب تقلبات) - يهدف إلى جعل السلسلة أكثر ثباتًا وقابلية للتنبؤ - يُستخدم مصطلح 'الثبات' لوصف هذا المعنى | • = المتوسط المتحرك - تقنية تُستخدم "للتسوية" - التقلبات أو الضوضاء في مجموعات البيانات من خلال تحديد الاتجاهات الأساسية - تستخدم (نافذة) متحركة لنقاط البيانات - بيانات جديدة تحل محل البيانات القديمة لمنع تأثر المتوسط بالقمم العليا والدنيا غير العادية، على سبيل المثال، تأثيرات موسمية مثل زيادة مبيعات الآيس كريم في الصيف |
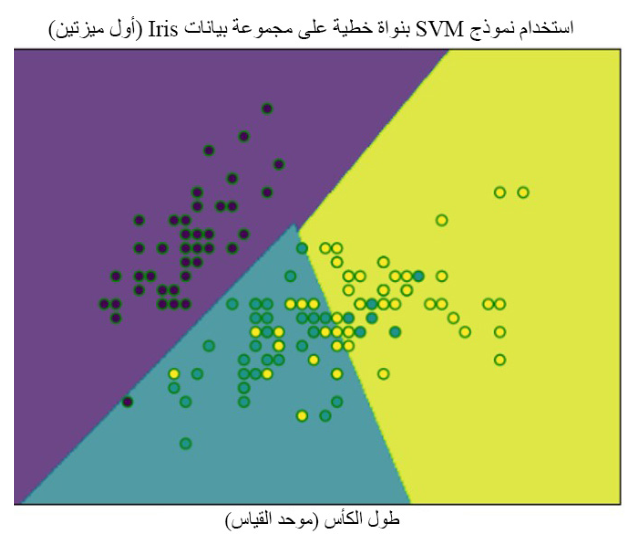
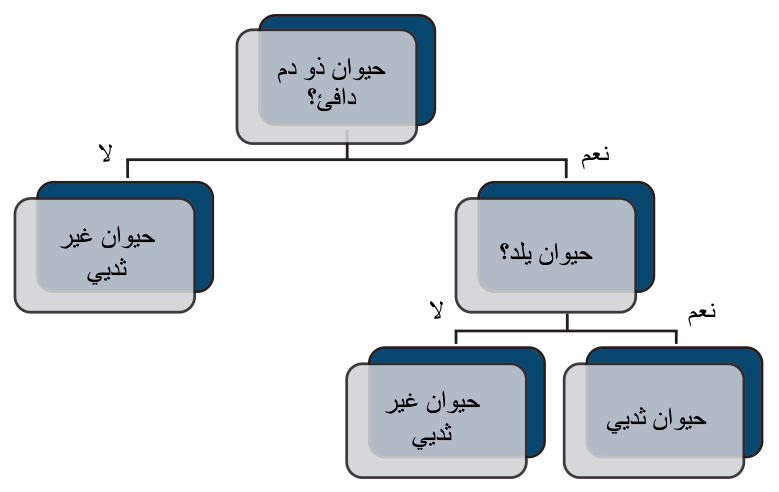
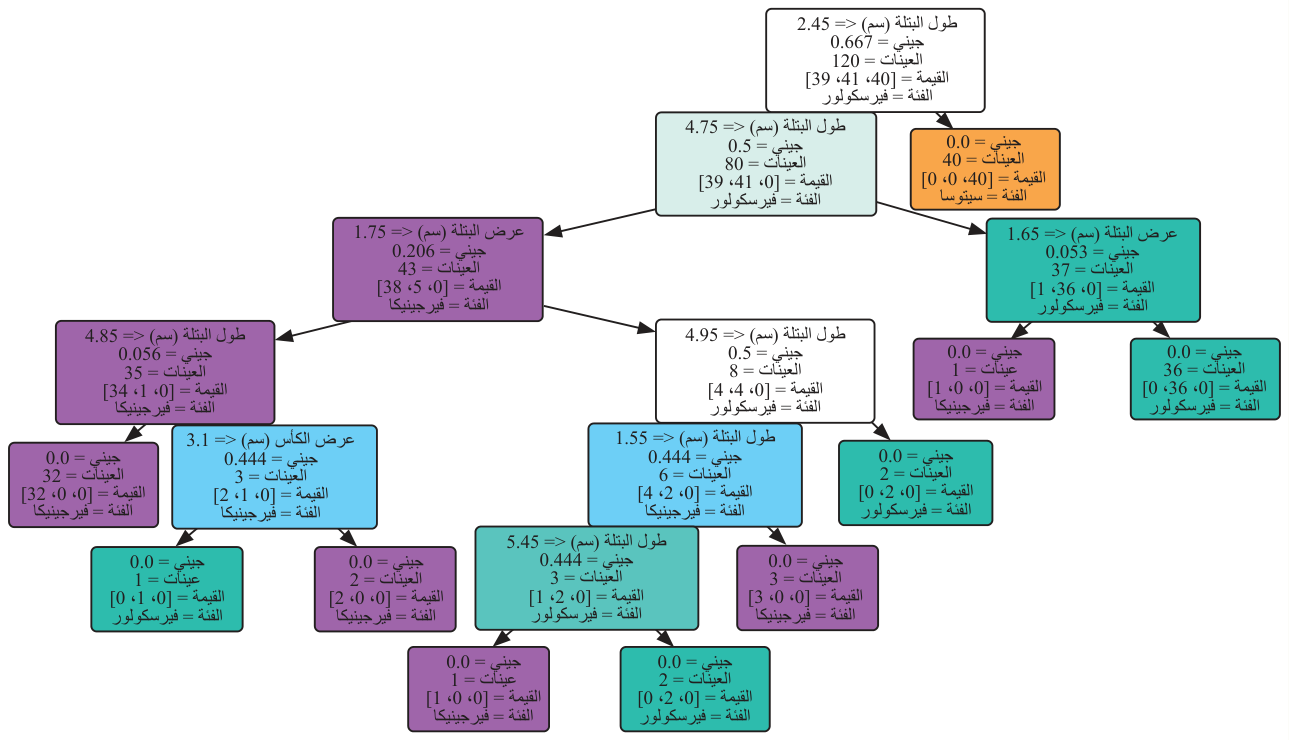
ماذا تمثل العقد الورقية في شجرة القرار؟
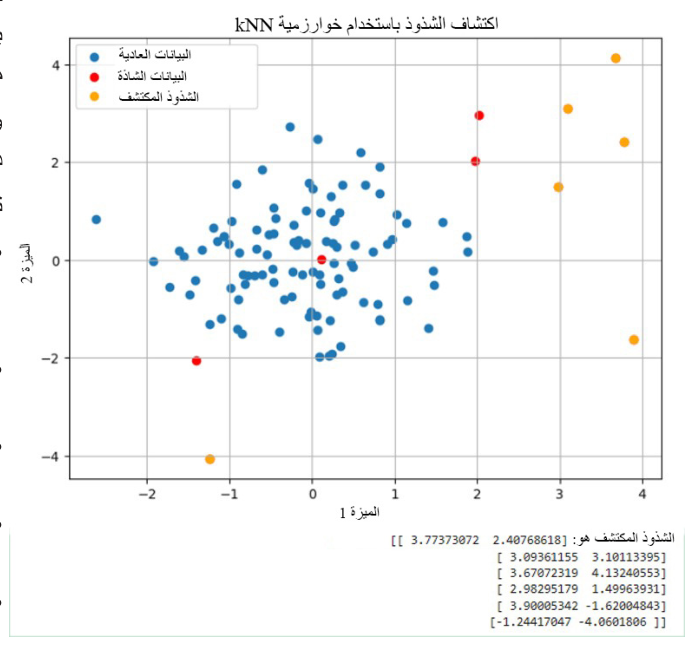
متى تُعد نقطة بيانات انحرافًا في مثال kNN؟
ما التطبيقات الأربعة الرئيسة للشبكات العصبية؟
المثال البرمجي في الشكل 21.41 ينشئ بيانات اصطناعية، بما في ذلك بعض البيانات التي يمكن اعتبارها انحرافات. ثم يحاول ملاءمة نموذج kNN فقط لنقاط البيانات العادية. ثم يتم حساب المسافات لجميع النقاط إلى أقرب نقاط k. أي نقاط تكون فوق نسبة 95% تعتبر انحرافًا. يظهر الإخراج الناتج في الشكل 21.42.
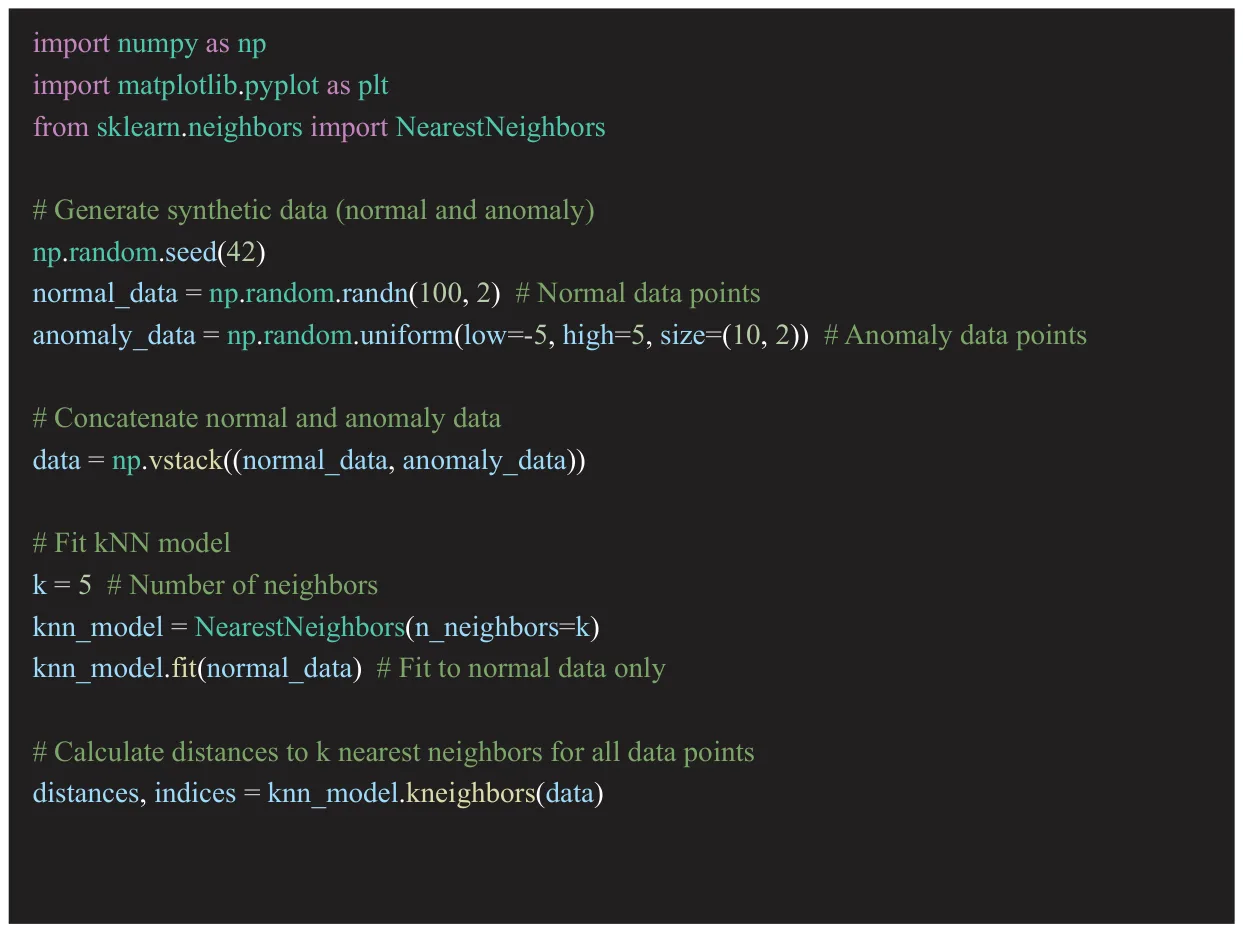
```python import numpy as np import matplotlib.pyplot as plt from sklearn.neighbors import NearestNeighbors
np.random.seed(42) normal_data = np.random.randn(100, 2) # Normal data points anomaly_data = np.random.uniform(low=-5, high=5, size=(10, 2)) # Anomaly data points
data = np.vstack((normal_data, anomaly_data))
k = 5 # Number of neighbors knn_model = NearestNeighbors(n_neighbors=k) knn_model.fit(normal_data) # Fit to normal data only
distances, indices = knn_model.kneighbors(data) ```
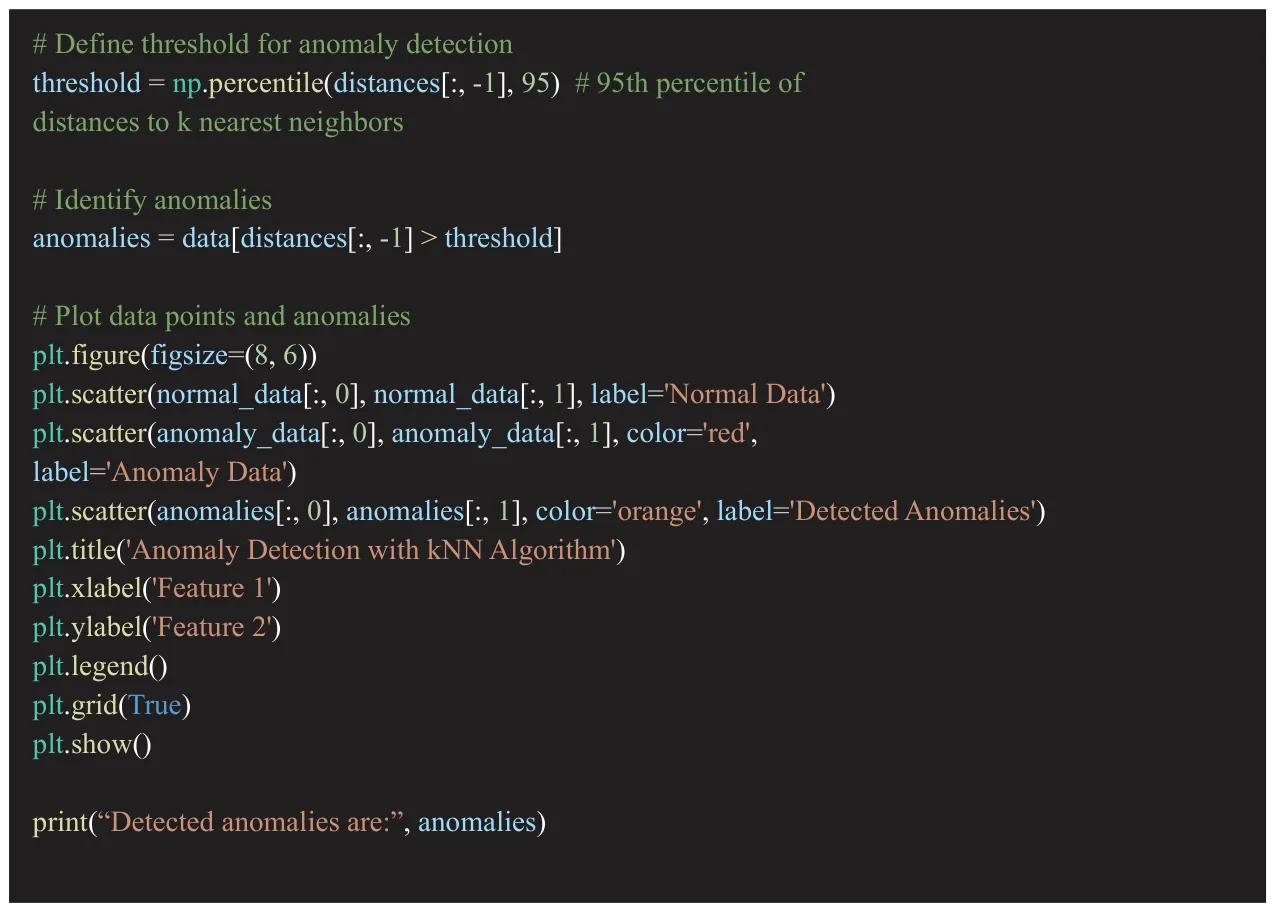
```python
threshold = np.percentile(distances[:, -1], 95) # 95th percentile of distances to k nearest neighbors
anomalies = data[distances[:, -1] > threshold]
plt.figure(figsize=(8, 6)) plt.scatter(normal_data[:, 0], normal_data[:, 1], label='Normal Data') plt.scatter(anomaly_data[:, 0], anomaly_data[:, 1], color='red', label='Anomaly Data') plt.scatter(anomalies[:, 0], anomalies[:, 1], color='orange', label='Detected Anomalies') plt.title('Anomaly Detection with kNN Algorithm') plt.xlabel('Feature 1') plt.ylabel('Feature 2') plt.legend() plt.grid(True) plt.show()
print("Detected anomalies are:", anomalies) ```
كما ترى، هذه العملية ليست مثالية - في حين تم تحديد النقاط البعيدة بشكل صحيح، لم يتم تحديد بعضها الأقرب إلى المركز (أي هربت من الاكتشاف). وبالتالي، سيكون من الضروري تحسين النموذج بشكل أكبر (وزيادة دقته العامة) قبل استخدامه بشكل موثوق في بيئة الإنتاج. تشمل التقنيات الشائعة لتحسين الدقة:
هناك العديد من الاستخدامات المختلفة للشبكات العصبية. تشمل أربعة تطبيقات رئيسية لهذه التقنية ما يأتي:
الفوائد الخمس الأساسية لاستخدام الشبكات العصبية موضحة بوضوح أدناه.
ومع ذلك، فإن الشبكات العصبية تمثل بعض التحديات التشغيلية.
لذلك، من الواضح أن هناك مشكلة تتعلق بالتوازن عند التفكير في الشبكات العصبية. إنها توفر فرصًا رائعة للذكاء الاصطناعي، ولكنها تمثل أيضًا العديد من التحديات الصعبة في الإعداد والتدريب وقابلية الشرح.
ومن الجدير بالذكر أيضًا أن الشبكات العصبية يمكن أن تكون عرضة تحديدًا للهجمات العدائية. في بعض الأحيان يتم تنفيذ الهجمات العدائية ببساطة لتعطيل العمليات، وأحيانًا لخلق نتائج أكثر ملاءمة للمهاجم، وأحيانًا لتحقيق ميزة تجارية. الطبيعة الغامضة لعملية اتخاذ القرار في الشبكة العصبية ووجود مثل هذه الثغرات يمكن أن يؤدي إلى مخاوف بشأن العدالة والتحيز والتأثيرات الاجتماعية. هذا يمكن أن يؤدي إلى تآكل الثقة العامة والثقة بشكل عام. ومصدر قلق خاص بالنظر إلى الاستخدام المتزايد لهذه الأنظمة في قطاعات التمويل والرعاية الصحية والعدالة الجنائية.
الهجمات العدائية - تقع هذه الهجمات عندما يصيغ المخربون مدخلات ضارة يمكن أن 'تسمم' بيانات تدريب الشبكة ما ينجم عنه عدم صحة التنبؤات التي يقدمها النموذج.
إن مشهد أدوات الذكاء الاصطناعي واسع ومعقد على حد سواء، ويضم مجموعة واسعة من المنصات التجارية والمفتوحة المصدر والتطبيقات والمكتبات والأطر، وتقدم مجموعة من الخيارات لأولئك الذين يرغبون في حل مشكلات معقدة في العالم الحقيقي.
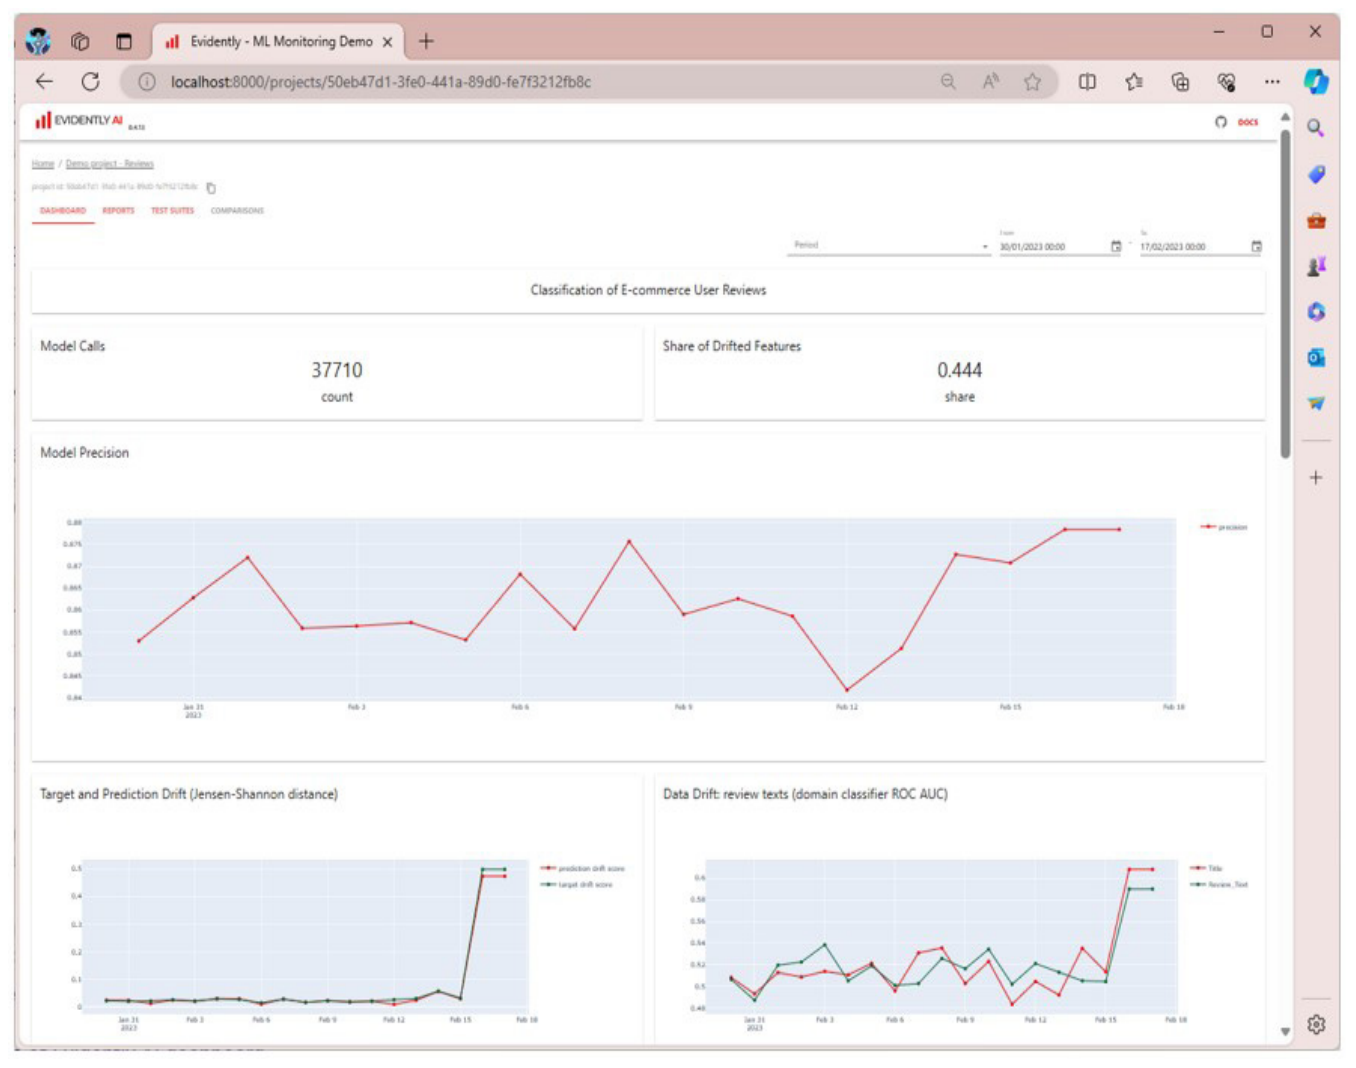
تتضمن هذه المرحلة تحليل البيانات المجمعة لإجراء التجارب واكتساب الأفكار. تشمل الأدوات النموذجية لهذه المرحلة ما يأتي:
لماذا تُعد جافا قابلة للنقل بشكل كبير؟
| مكتبة | إطار العمل |
|---|---|
| مجموعة من الفئات، والدوال، والثوابت، وما إلى ذلك. | يوفر هيكلاً يمكن للمطور بناء مشروعه عليه |
| يقوم المطور بتضمين هذه العناصر بحسب الحاجة | يتم ربط كود المطور واستدعاؤه بحسب الحاجة من الإطار |
| يستدعي المطور هذه العناصر بحسب الحاجة | يحدد الإطار إلى حد كبير هيكل المشروع |
| يتحكم المطور في بنية الحل البرمجي |
الشكل 21.48 يوضح أحد مشتقات R يقوم بحساب المتوسط الحسابي بالطريقة نفسها. يظهر الإخراج الناتج في الشكل 21.49. في هذا المثال، تحتوي R على دالة 'mean' مدمجة يمكن استخدامها فورًا في الكود دون الحاجة إلى استيرادها من مكتبة.
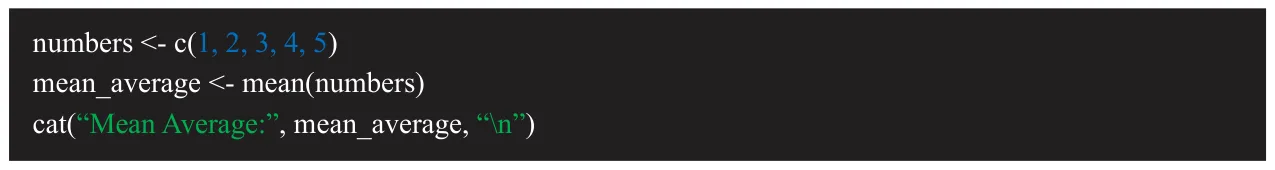
``r numbers <- c(1, 2, 3, 4, 5) mean_average <- mean(numbers) cat("Mean Average:", mean_average, "\n") ``

يوضح الشكل 21.50 برنامج ليسب يقوم بحساب المتوسط الحسابي بالطريقة نفسها. يظهر الناتج في الشكل 21.51.
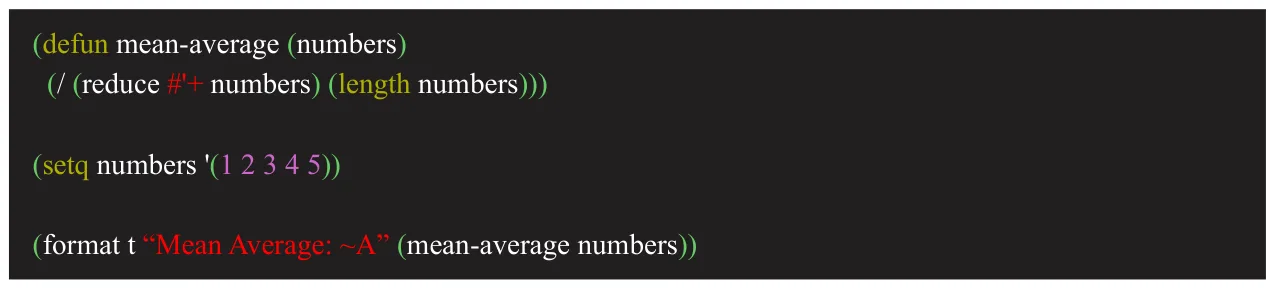
```lisp (defun mean-average (numbers) (/ (reduce #'+ numbers) (length numbers)))
(setq numbers '(1 2 3 4 5))
(format t "Mean Average: ~A" (mean-average numbers)) ```

المكتبات والأطر عبارة عن طرود قابلة لإعادة الاستخدام من أكواد خارجية (عادة) تساعد مطوري البرامج في المهام الشائعة. وعلى الرغم من استخدام هذين المصطلحين غالبًا بالتبادل، إلا أن هناك تمييزًا دقيقًا بينهما. بشكل عام، فإن الطريقة التي يتم بها دمجها في المشاريع هي التي تساعد على تمييزها.
الجدول 21.10 مكتبة مقابل إطار عمل، يوضح الخصائص الرئيسة لكل نوع
| مكتبة | إطار العمل |
|---|---|
| مجموعة من الفئات، والدوال، والثوابت، وما إلى ذلك. | يوفر هيكلاً يمكن للمطور بناء مشروعه عليه |
| يقوم المطور بتضمين هذه العناصر بحسب الحاجة | يتم ربط كود المطور واستدعاؤه بحسب الحاجة من الإطار |
| يستدعي المطور هذه العناصر بحسب الحاجة | يحدد الإطار إلى حد كبير هيكل المشروع |
| يتحكم المطور في بنية الحل البرمجي |
تشمل المكتبات والأطر المشتركة التي تهم أبحاث ومطوري الذكاء الاصطناعي ما يأتي.

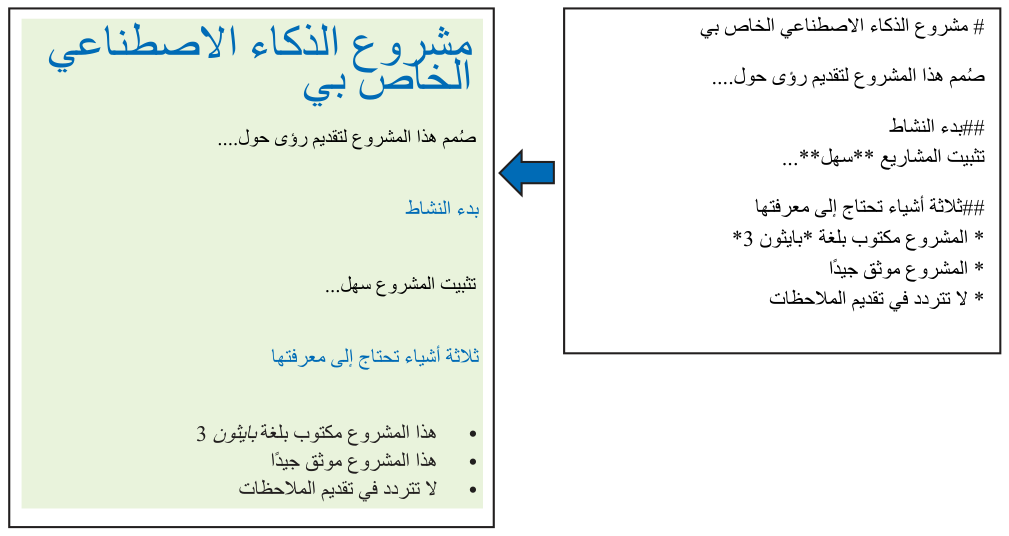
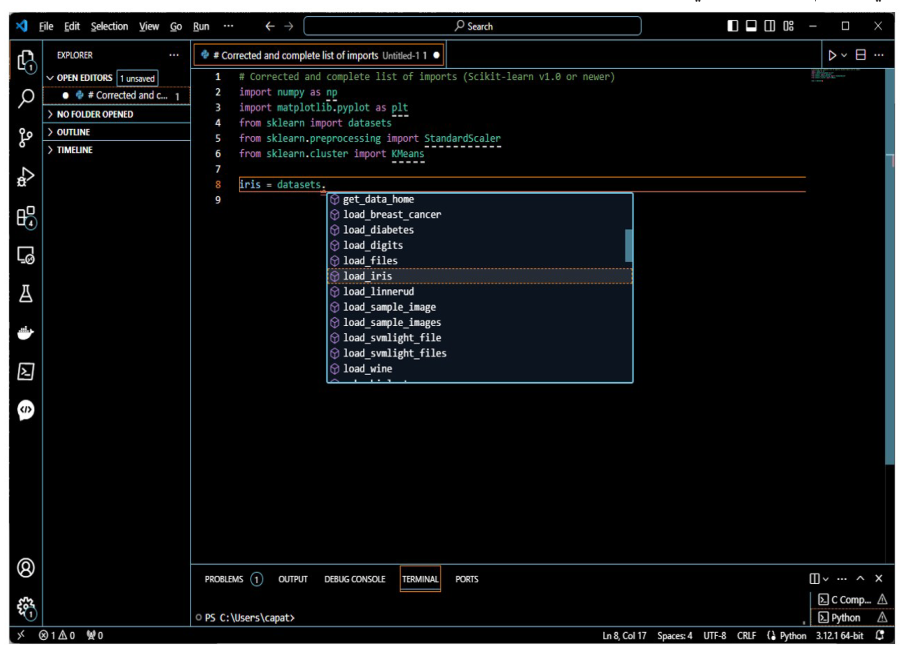
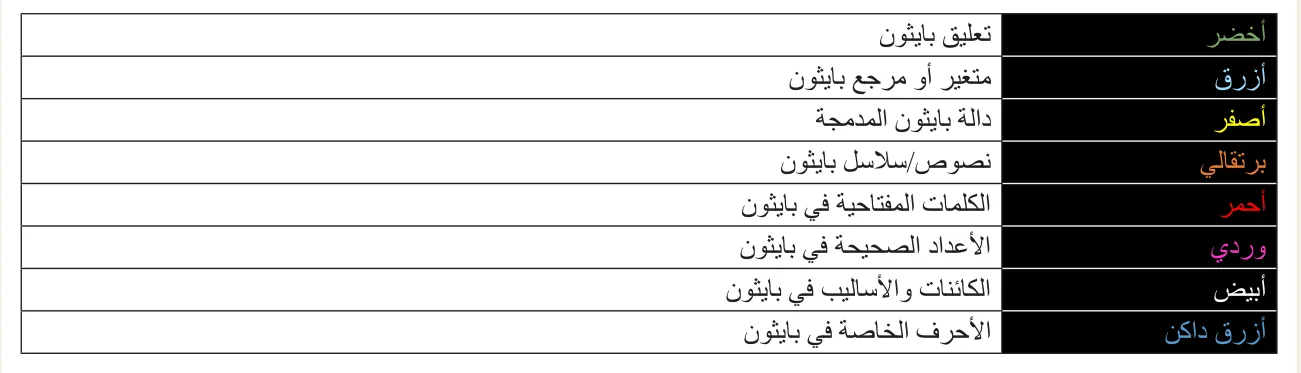
ألوان إبراز كود بايثون ومعنى كل لون.
| أخضر | تعليق بايثون |
| أزرق | متغير أو مرجع بايثون |
| أصفر | دالة بايثون المدمجة |
| برتقالي | نصوص/سلاسل بايثون |
| أحمر | الكلمات المفتاحية في بايثون |
| وردي | الأعداد الصحيحة في بايثون |
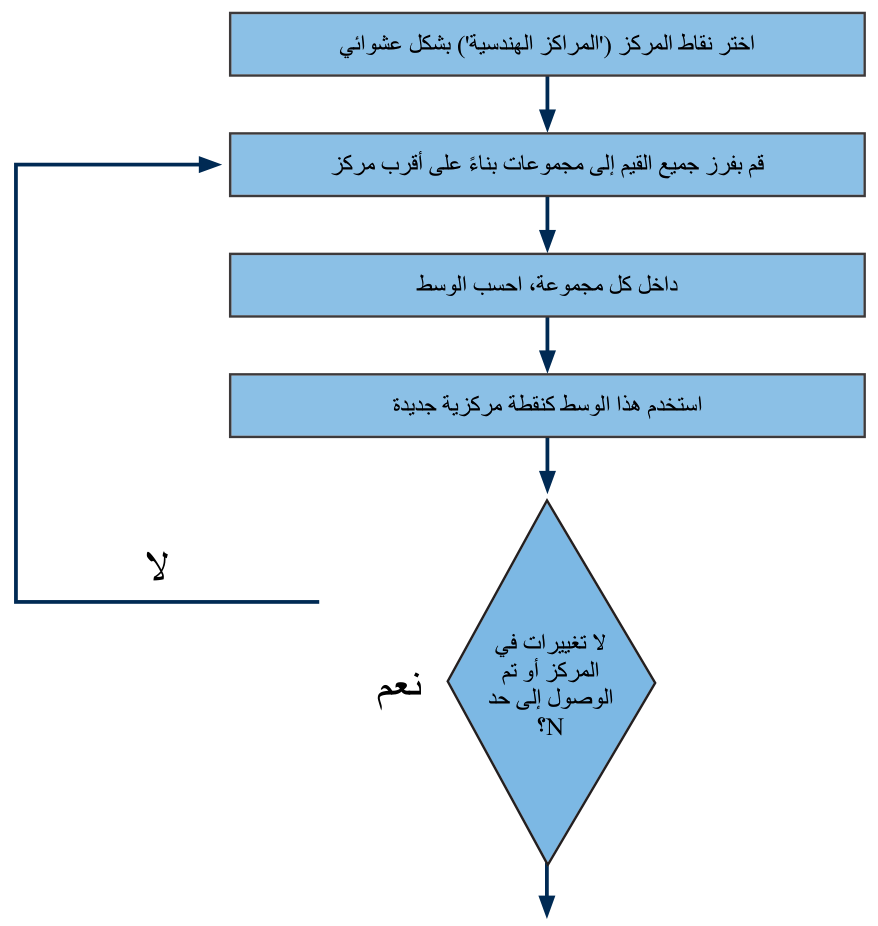
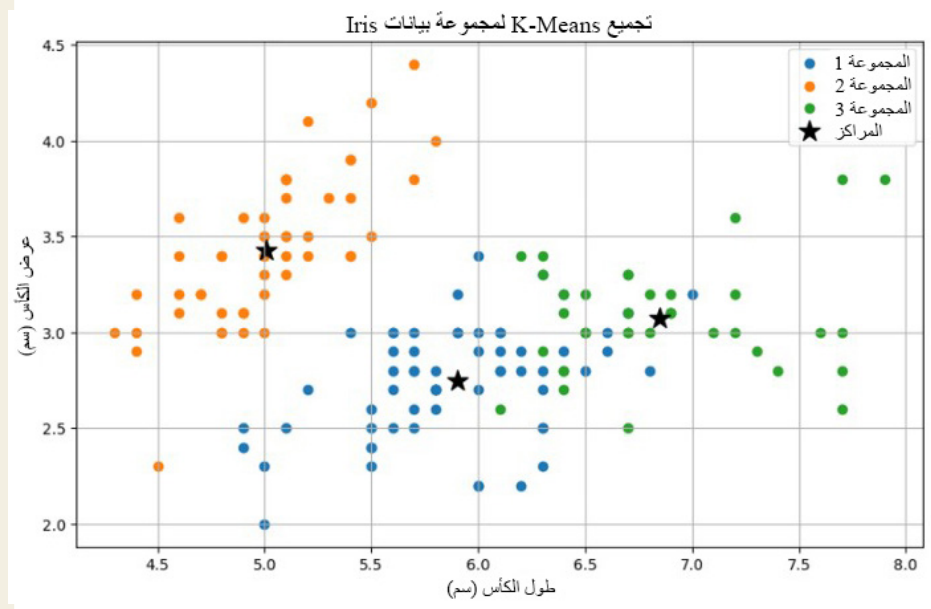
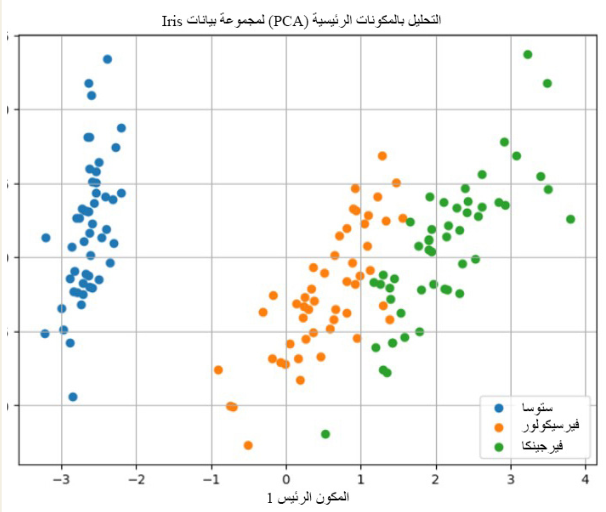
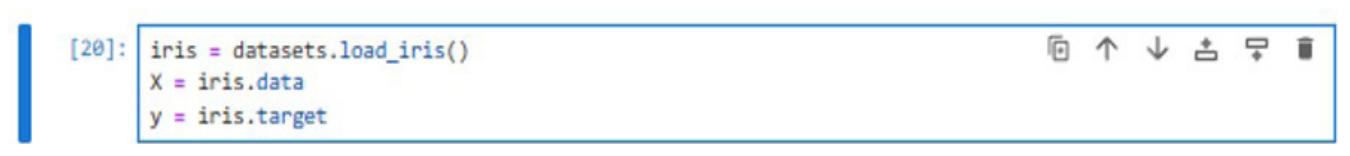
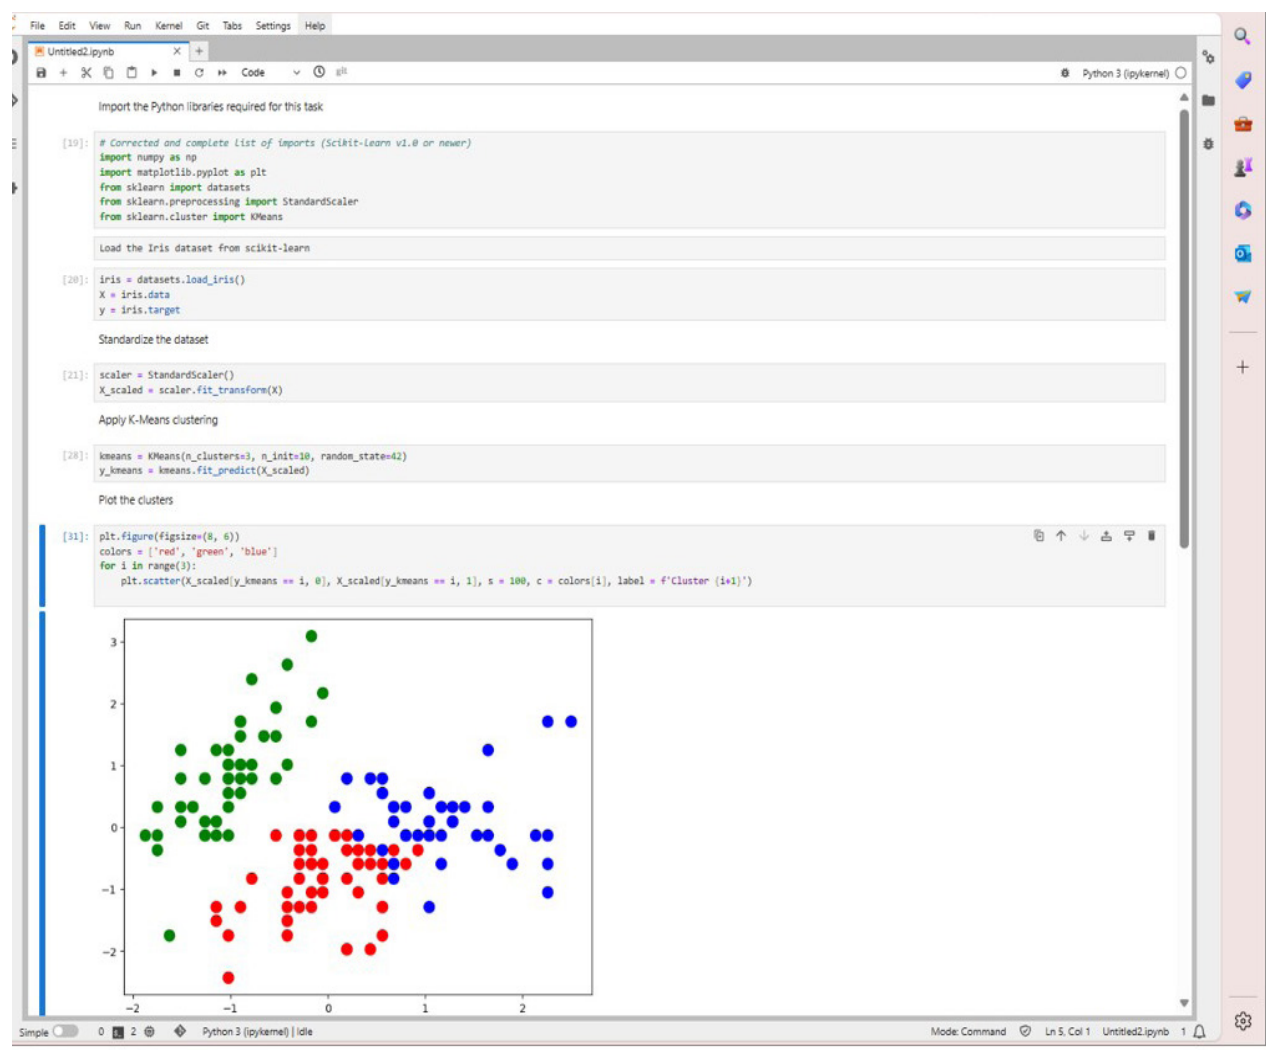
يوضح المثال الآتي استخدام دفتر Jupyter لاستكشاف تصنيف زهرة السوسن باستخدام خوارزمية التجميع K-means الخاصة بلغة scikit-learn.
تمييز بناء الجملة - قدرة الأداة على تحليل لغة البرمجة وتمثيل الكلمات الرئيسة، والدوال، والعوامل، والرموز ذات الألوان المختلفة على الشاشة.
```python
import numpy as np import matplotlib.pyplot as plt from sklearn import datasets from sklearn.preprocessing import StandardScaler from sklearn.cluster import KMeans
iris = datasets.load_iris() X = iris.data y = iris.target
scaler = StandardScaler() X_scaled = scaler.fit_transform(X)
kmeans = KMeans(n_clusters=3, n_init=10, random_state=42) y_kmeans = kmeans.fit_predict(X_scaled)
plt.figure(figsize=(8, 6)) colors = ['red', 'green', 'blue'] for i in range(3): plt.scatter(X_scaled[y_kmeans i, 0], X_scaled[y_kmeans i, 1], s = 100, c = colors[i], label = f'Cluster {i+1}') ```
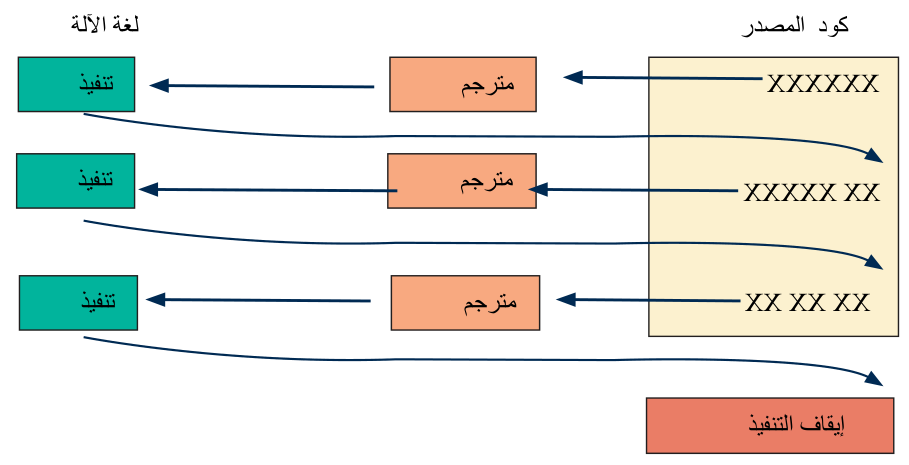
ماذا يحدث عند مواجهة خطأ في بناء الجملة في أثناء الترجمة؟
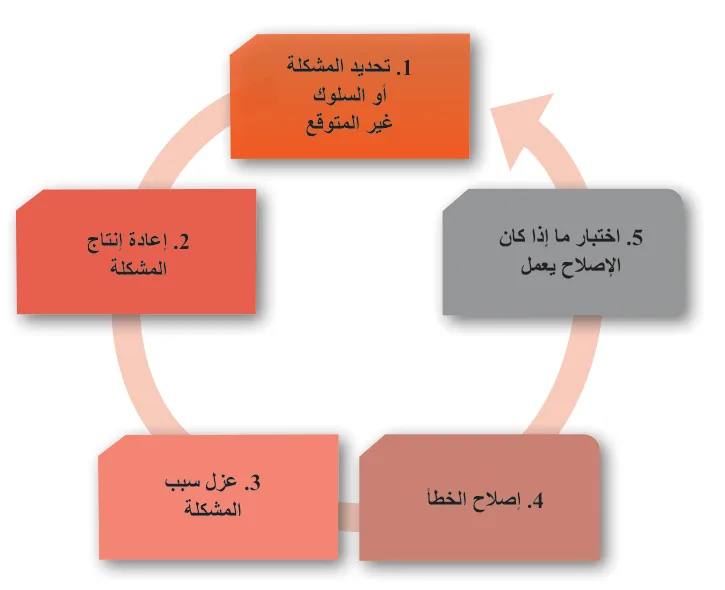
المترجم هو ببساطة برنامج للمساعدة يأخذ رمز المصدر (كود البرنامج المكتوب) سطرًا واحدًا في كل مرة، ويترجمه إلى لغة الآلة وينفذه.
إذا واجه سطرًا لا يمكنه تفسيره بنجاح، فإنه (يتعطل) ويبلغ عن خطأ في بناء الجملة. وإلا، تستمر العملية حتى يتم تفسير جميع الأسطر وتنفيذها بنجاح. غالبًا ما تكون عملية التفسير بطيئة (نسبيًا) ولديها (مقارنة بالتجميع) فرصة ضئيلة للتحسين (أي لاتخاذ أي اختصارات لتوفير الوقت تعمل على تحسين وقت التنفيذ أو كفاءة الذاكرة).
يعتبر بايثون، ليسب وR لغات مفسرة بشكل عام، على الرغم من أن الأولى تُترجم فعليًا إلى بايت كود بايثون أولًا (في المرحلة الوسيطة) قبل أن ينفذها مفسر بايثون - ما يسمح بإدخال مستوى من التحسين الأساسي.
مشاريع الذكاء الاصطناعي كبيرة جدًا بحيث لا يمكن لمطور واحد فقط العمل عليها. للسماح للعديد من المطورين بالمساهمة في مشروع، من المحتم استخدام نوع ما من منصات إدارة الكود. تسمح منصة إدارة الرموز البرمجية لفريق من المطورين بما يأتي:
Git - نظام تحكم في الإصدارات (VCS) أنشأه لينوس تورفالدس (مبتكر نواة لينكس) في عام 2005 وصدر بوصفه أحد البرامج مفتوحة المصدر بموجب رخصة GNU GPL v2.
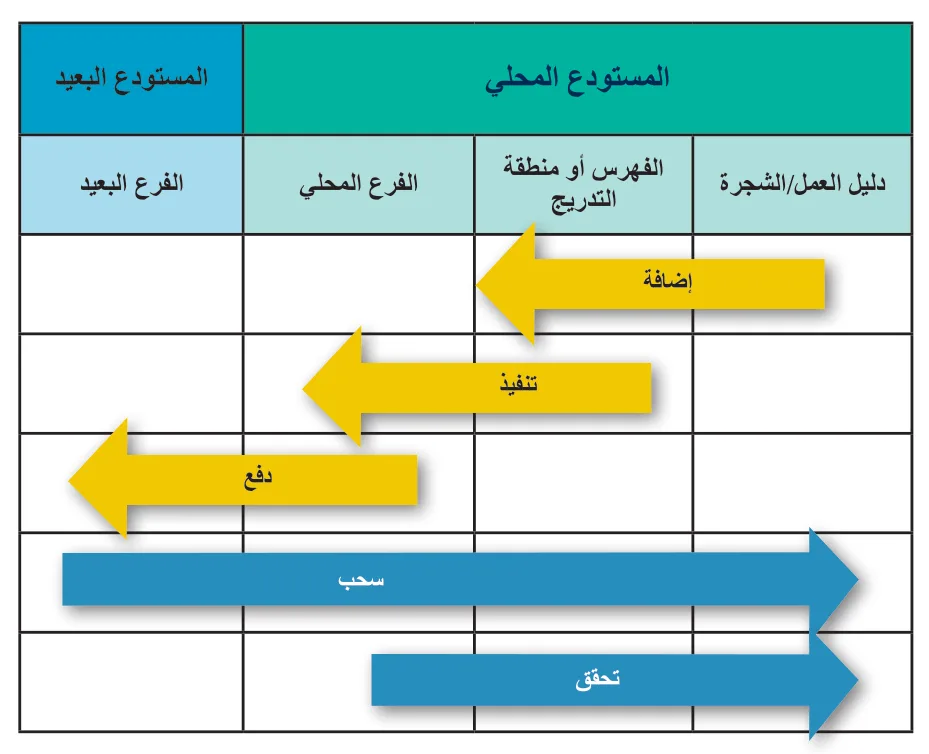
منصة إدارة الأكواد الشهيرة هي Git، وحتى وقت كتابة هذا الكتاب، ما تزال Git تعتبر نظام التحكم في الإصدارات (VCS) الأكثر شهرة في العالم. يتوفر واجهات وخدمات ويب إضافية لـ Git عن طريق منصات مثل: GitLab وGitHub وما إلى ذلك، وتسمح هذه الأمور بتثبيت Git محليًا على أجهزة المطورين. وهذا بدوره يسمح للمطورين بدفع (التزامات) الكود إلى مستودع بعيد لقاعدة الأكواد البرمجية الخاصة بهم وسحب التغييرات منه. يتم تقسيم أي مشكلة في Git إلى ثلاث مناطق منفصلة:
توجد هذه المناطق عادةً على حاسوب المطور. عندما يبدأ المطور، يعتبر دليل العمل (نظيفًا). عندما يقوم المطور بإضافة الأصول أو حذفها أو تعديلها، تتغير حالة الشجرة لدليل العمل. يتم تعقب هذه التغييرات (يعرف Git عنها) أو يتم إلغاء تتبعها (لا يعرف Git عنها).
يؤدي استخدام الأمر 'git add' إلى نقل الملف المعدل إلى منطقة التدريج. يتم استخدام الأمر (git commit) لتنفيذ التغييرات المتعقبة على مستودع Git المحلي. من أفضل الممارسات تضمين تعليق وصفي مناسب إلى جانب الالتزام الذي يتعلق بالغرض منه. بمجرد إجراء التغييرات على المستودع المحلي، يمكن استخدام أمر (git push) آخر لمشاركة/تحميل التغييرات إلى المستودع البعيد. بمجرد قبول تغييرات المطور، يمكن للآخرين جلب هذه التغييرات أو سحبها إلى أجهزتهم المحلية، مع تحديث نسختهم من قاعدة الأكواد البرمجية. تعارضات الدمج شائعة. تحدث هذه عادةً عندما يقوم العديد من المطورين بإجراء تغييرات متناقضة على الأجزاء نفسها من قاعدة الأكواد البرمجية. عادةً ما يقوم مالك قاعدة الأكواد البرمجية بحل هذه المشكلات. ومع ذلك، لتجنبها تمامًا، يُنصح المطورون بالالتزام (قليلًا وفي كثير من الأحيان). قد تحتوي المشاريع أيضًا على فروع متعددة - اعتبرها بمنزلة تفرعات مختلفة (مثل V2، أو 2.1)؟ عندما تعمل في المجال، من المتوقع أن تتمكن من استعادة الإصدارات السابقة من الأكواد البرمجية التي كتبتها. ابدأ التفكير الآن في كيفية استخدام التحكم في الإصدار في أنشطة البرمجة المستقبلية.
فكر في برامج الحاسب التي كتبتها، ثم قمت بتصحيحها ثم ربما أعدت كتابتها. هل سبق لك أن أردت العودة إلى إصدار سابق لأن شيئًا ما كان يعمل لم يعد يعمل؟ هل تحفظ برامجك المعدلة باسم جديد، أم بالاسم ورقم الإصدار نفسه (مثل V2، أو 2.1)؟ عندما تعمل في المجال، من المتوقع أن تتمكن من استعادة الإصدارات السابقة من الأكواد البرمجية التي كتبتها.
هذه معاينة من الموضوع. أكمل القراءة في التطبيق
سجّل مجاناً وكمّل الموضوع من الكتاب، ومنرجّعك لنفس المكان.
معاينة موضوع «نتاج التعلم ج: تطوير حل الذكاء الاصطناعي لتلبية احتياجات محددة» من وحدة «مقدمة إلى الذكاء الاصطناعي AI» في مادة مقدمة في الذكاء الاصطناعي. أقسام الشرح: ٦٠، التعريفات: ٢٠، الأسئلة المحلولة: ٦.
المصدر: بيرسون، نتاج التعلم ج: تطوير حل الذكاء الاصطناعي لتلبية احتياجات محددة (ص ٢٥٣–٢٩٢)





