
شرح الموضوع
الوحدة 21 | مقدمة إلى الذكاء الاصطناعي (AI) | نتاج التعلم ج
تطوير حل الذكاء الاصطناعي لتلبية احتياجات محددة
- بعد التخطيط والإعداد لإنشاء حل للذكاء الاصطناعي، يقدم لك هذا الموضوع الإجراءات اللازمة للمضي قدمًا بالخطة وتطوير الحل رسميًا.
تطوير حل الذكاء الاصطناعي لتلبية احتياجات محددة
نموذج الذكاء الاصطناعي: من أين يأتي؟
بعد التخطيط والإعداد لإنشاء حل للذكاء الاصطناعي، يقدم لك هذا الموضوع الإجراءات اللازمة للمضي قدمًا بالخطة وتطوير الحل رسميًا. في هذا الجزء، ستستكشف مجموعة من الخوارزميات المكتوبة بلغة بايثون.
ج1 نماذج الذكاء الاصطناعي
- نموذج الذكاء الاصطناعي: نقطة البداية في النقاش حول تطوير حلول الذكاء الاصطناعي.
- إنشاؤه: من خلال عملية تسمى التعلم الآلي (ML).
- الطريقتان: التعلم تحت الإشراف والتعلم الآلي دون إشراف.
التعلم تحت الإشراف
- التعلم الآلي تحت الإشراف: تُختار خوارزمية مناسبة لحل المشكلة، ويُستخدم جزء من البيانات المتاحة (عادة 80 في المائة) لتدريبها.
- الاختبار: بعد التدريب يجب اختبار النموذج قبل استخدامه بنسبة 20 في المائة المتبقية من البيانات وتقييم النتيجة.
- التعلم الآلي دون إشراف: يعتمد على تطبيق الخوارزميات (مثل التجميع أو تقليل الأبعاد) للكشف عن الأنماط أو الهياكل أو العلاقات المخفية في البيانات.
التعلم دون إشراف
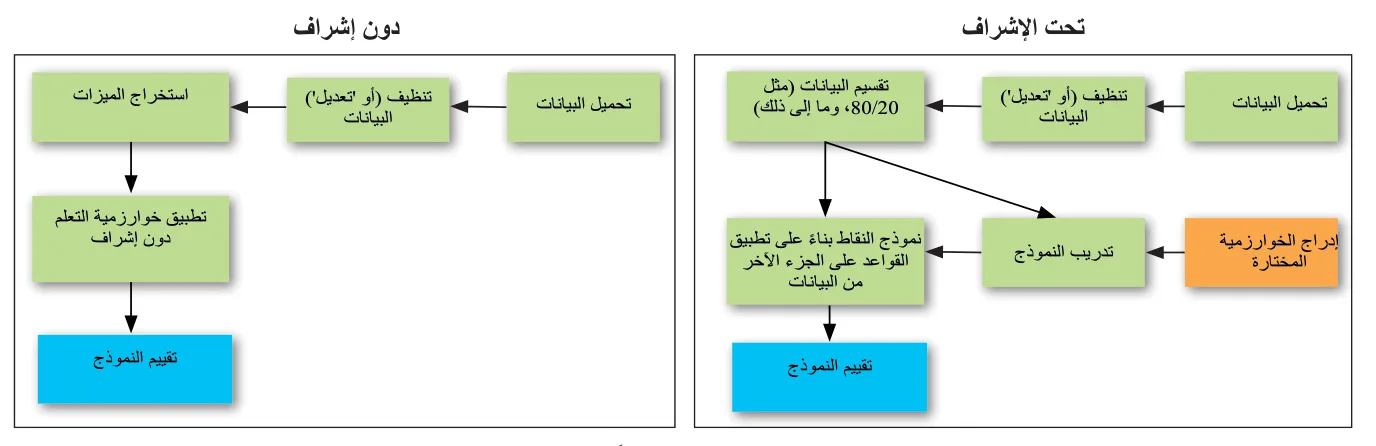
- في الشكل 21.23: كلاهما يبدأ بتحميل البيانات وينتهي بتقييم النموذج الذي تم إنشاؤه، لكن تختلف طريقة تقدمهما قليلًا.
- المحاولات الأولية: قد لا تؤدي إلى تنبؤات شديدة الدقة، فيعدل عالم البيانات اختيار ميزات النموذج أو الأوزان أو معاملات الضبط.
- بعد التعديل: يشغل عملية التدريب مرة أخرى على أمل أن تكون النتائج أفضل.
- مثال القطط: عالم بيانات جمع الكثير من الصور وحدد الميزات الرئيسية التي ستعتبرها مؤشرًا بصريًا للقطط.
- بيانات التدريب: هذه الصور والميزات، وهدفك نظام يصنف الصورة بشكل صحيح.
- المعاملات الفائقة: مدى سرعة تعلم الخوارزمية (معدل التعلم)، وعدد الصور التي تغذي الخوارزمية دفعة واحدة (حجم الدفعة).
- التجريب: ستبدأ في تعديل الميزات المحددة والمعايير الفائقة المستخدمة، وستواصل إجراء المزيد من التجارب حتى تصل إلى أفضل تركيبة.
- حدود الذكاء الاصطناعي: لا يمكنه الإجابة عن كل سؤال، لكن يمكن تدريبه على الإجابة بسرعة عن أسئلة تستغرق من الإنسان وقتًا وجهدًا كبيرين.
- للإجابة: يجب تحديد نوع المشكلة (فيحدد الخوارزمية) ونوع تقنية التعلم التي يجب استخدامها.
تصنيف النموذج بحسب الإدخال
تصنيف النماذج بحسب الإدخال والمخرجات
- التصنيف بحسب المدخلات: يحدد طريقة تعلم النموذج، عادة بالتعلم تحت الإشراف أو دون إشراف.
| التعلم تحت الإشراف | التعلم دون إشراف |
|---|---|
| • مدخلات بيانات التدريب معنونة يدويًا | • مدخلات البيانات غير معنونة |
| • مقترن بمخرجات متطابقة | • يتم تحديد الأنماط داخل مدخلات البيانات |
| • يمكن أن يكون مستهلكًا للوقت ومكلفًا | • الهدف هو تحديد الأنماط أو الهياكل المخفية في البيانات؛ واكتشاف أوجه التشابه والاتجاهات وما إلى ذلك. |
| • الهدف هو التنبؤ بمخرجات البيانات غير الموجودة في مجموعة التدريب الخاصة بها من خلال علاقات التعلم بين المدخلات والمخرجات. | • أقل تكلفة مع انخفاض التفاعل البشري |
| • تشمل الخوارزميات الكلاسيكية التصنيف والانحدار | • تشمل الخوارزميات الكلاسيكية التجميع وتقليل الأبعاد |
| • التطبيقات الشائعة: تصفية البريد الإلكتروني أو تعرف الصور أو الصوت وما إلى ذلك. | • التطبيقات الشائعة: تحليل السوق واكتشاف الحالات الشاذة وما إلى ذلك. |
- الاختيار: يؤثر نوع البيانات وطبيعة النتيجة في نوع خوارزمية التعلم الآلي المستخدمة في النموذج.
- تنبؤ بسيط: قد يُحل باستخدام خوارزمية الانحدار الخطي (إذا أدخلت القيمة x فستتنبأ بالقيمة y).
- أحيانًا: استخدام المصنف أكثر ملاءمة من تقنيات التجميع، والأمور نادرًا ما تنجح في المرة الأولى وقد تحتاج إلى إعادة المحاولة.
- التصنيف بحسب المخرجات: الرقم (خوارزمية الانحدار)، والفئة (التصنيف)، وباقة من المجموعات (التجميع)، والميزات الرئيسة في البيانات المعقدة (تقليل الأبعاد).
تصنيف النموذج بحسب المخرجات المطلوبة
ما نوع المخرجات التي تحققها خوارزمية الانحدار وخوارزمية التصنيف؟
الانحدار الخطي
الانحدار الخطي: خط يتنبأ
- الانحدار الخطي: قد تكون على دراية بالمعادلة، وتُرسم في الشكل 21.24.
- x: متغير مستقل يمثل المدخلات.
- y: يمثل المخرجات المتوقعة، وهو متغير تابع.
- m: يمثل ميل خط الانحدار.
- c: يمثل نقطة تقاطع المحور y لخط الانحدار، أي قيمة y عندما تكون x تساوي 0.
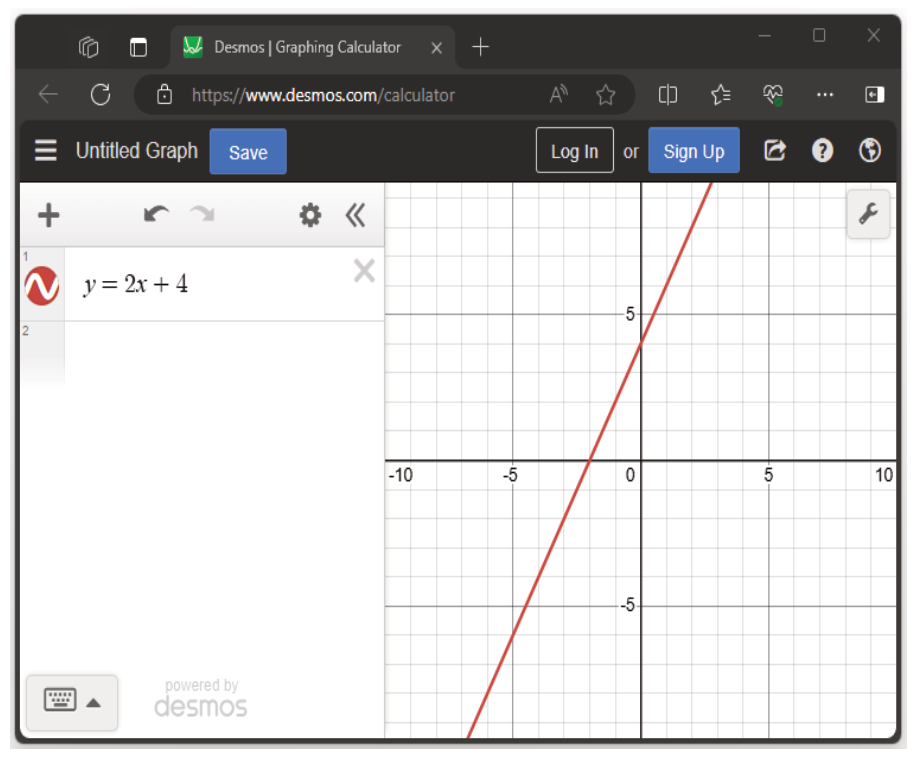
- الاستخدام: يجب أن يكون من الممكن أخذ أي قيمة للمحور x والعثور على قيمتها التابعة (المتوقعة) للمحور y.
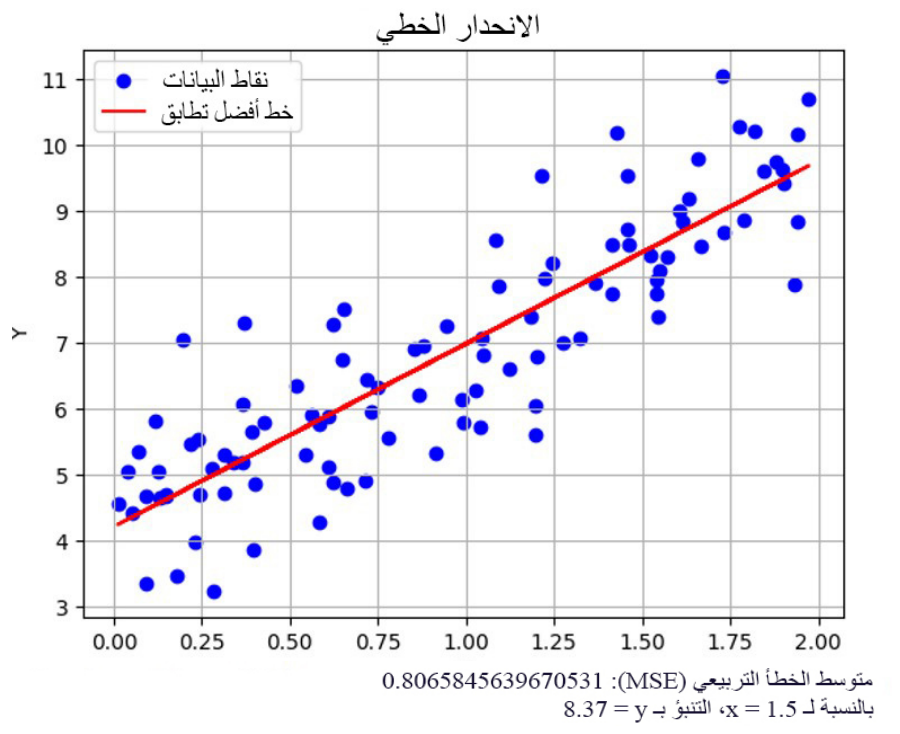
- في الذكاء الاصطناعي: نستخدم التعلم الآلي لرسم الخط الأنسب من البيانات المحددة بدلًا من معادلة بسيطة.
- دالة الخسارة: يتم ذلك بتقليلها، عادةً متوسط الخطأ التربيعي (MSE).
- في بايثون: يمكنك رؤية هذا مطبقًا باستخدام مكتبة scikit-learn ومجموعة بيانات تركيبية.
- الوحدات: لكتابة البرنامج كان من الضروري تضمين وحدات في الجزء العلوي من نص بايثون، مثل numpy وmatplotlib وsklearn.
- مكتبة بايثون القياسية: بعض الوحدات جزء منها ومثبتة بالفعل، وغيرها مكتبات تابعة لجهات خارجية يجب تثبيتها بشكل منفصل.
- أداة pip: عادةً تُستخدم لتنزيل الحزم من فهرس حزم بايثون المعتمد (pypi.org).
- وحدة مفقودة: إذا شغلت برنامجًا لا يتضمن الوحدات الصحيحة فمن المحتمل أن يحدث خطأ.
- الحل: ستحتاج إلى تحديد الوحدة المفقودة، (ربما) تثبيتها، ثم تضمين سطر في الجزء العلوي من البرنامج النصي الخاص بك لاستخدامها.
المتوسط [1، 2، 4]
- النتيجة: تم تدريب النموذج ورسم الخط الأفضل ملاءمة واختباره بقيمة عينة للمحور x، فتولدت قيمة تنبؤية للمحور y.
- أسئلة الأرقام: تستخدم نماذج الانحدار الخطي عادةً للإجابة عن الأسئلة المستندة إلى الأرقام، كالعائد المالي بعد سنوات أو قيمة منزل في المستقبل.
الانحدار اللوجستي
الانحدار اللوجستي: نجاح أم فشل؟
- الانحدار اللوجستي: تحديد علاقة خطية بين x وy ليس دائمًا أفضل نهج، فالنتيجة قد لا تزداد مع كل ساعة دراسة إضافية.
- النهج المختلف: يسألك هل أنت أكثر عرضة للنجاح أو الفشل، والخط المنحني يساعد على فهم احتمال النجاح أو الفشل.
- الاحتمالية: تقع بين 0 (أقل احتمالًا) و1 (أكثر احتمالًا).
- الفرق: هو انحدار فئوي (يحدد الفئات نجح أو فشل) بدلًا من قيمة مستمرة كما في الانحدار الخطي.
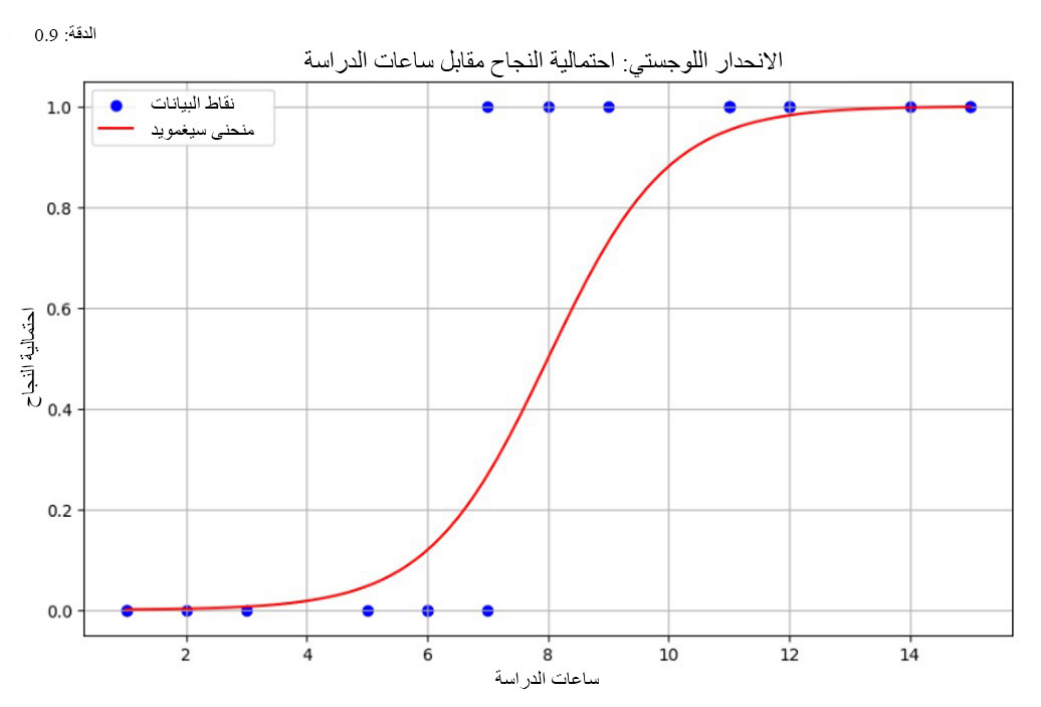
- النتيجة: يصبح احتمال النجاح شبه مؤكد (1.0) عند 12 ساعة دراسة، ثم ينخفض.
- المنحنى: يُرسم على شكل حرف S لتمثيل العلاقات في العالم الحقيقي.
- الدقة: يمكن البحث عن أي قيمة x والتحقق من احتمالية النجاح، لكن دقة النموذج 90 في المائة فقط.
التنبؤ بالسلاسل الزمنية: كيف نسوّي القيم؟
- تقنية قوية: تستخدم في تحليل بيانات السلاسل الزمنية، للتنبؤ بالقيم المستقبلية بناءً على الملاحظات السابقة (المتأخرة).
- اسمها: يمثل الميزات الثلاث: الانحدار الذاتي والمتكامل والمتوسط المتحرك.
| AR | I | MA |
|---|---|---|
| • = الانحدار الذاتي - نماذج العلاقة بين الملاحظة والقيمة السابقة - يفترض أن القيمة تعتمد على قيمها السابقة | • = متكامل - يستخدم تقنية تسمى التمييز - يتضمن ذلك محاولة إزالة الاتجاهات والفترات من البيانات (والتي تسبب تقلبات) - يهدف إلى جعل السلسلة أكثر ثباتًا وقابلية للتنبؤ - يُستخدم مصطلح 'الثبات' لوصف هذا المعنى | • = المتوسط المتحرك - تقنية تُستخدم "للتسوية" - التقلبات أو الضوضاء في مجموعات البيانات من خلال تحديد الاتجاهات الأساسية - تستخدم (نافذة) متحركة لنقاط البيانات - بيانات جديدة تحل محل البيانات القديمة لمنع تأثر المتوسط بالقمم العليا والدنيا غير العادية، على سبيل المثال، تأثيرات موسمية مثل زيادة مبيعات الآيس كريم في الصيف |
- AR (الانحدار الذاتي): يمثل العلاقة بين الملاحظة والقيمة السابقة، ويفترض أن القيمة تعتمد على قيمها السابقة.
- I (متكامل): يستخدم التمييز لإزالة الاتجاهات والفترات التي تسبب تقلبات، ليجعل السلسلة أكثر ثباتًا وقابلية للتنبؤ.
- MA (المتوسط المتحرك): تقنية تُستخدم للتسوية، وبيانات جديدة تحل محل القديمة لمنع تأثر المتوسط بالقمم غير العادية.
مثال عملي
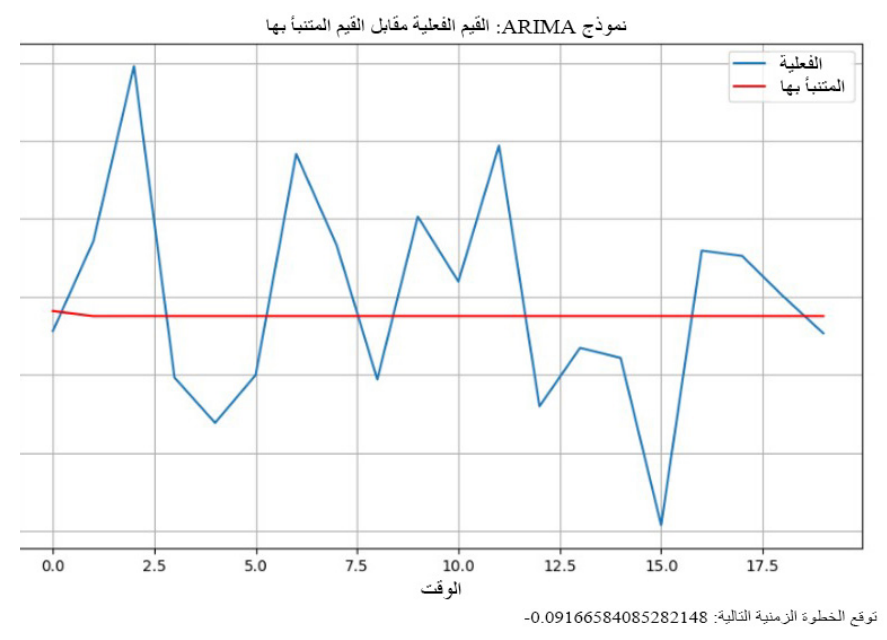
- مثال عملي: كود بايثون يحاكي نموذجًا من نوع ARIMA ببيانات زمنية اصطناعية، ويظهر تأثير التسوية الذي قلل التقلبات والضوضاء.
SVM (آلات المتجه الداعم)
آلات المتجه الداعم: حدود بين الفئات
- SVM: نموذج تعلم آلي قوي ومتعدد الاستخدامات للغاية، يجري تصنيفات خطية أو غير خطية لمجموعات البيانات المعقدة والصغيرة والمتوسطة الحجم.
- المثال: كود يحاكي SVM باستخدام تصنيف المتجهات الداعمة (SVC) في مكتبة scikit-learn.
- مجموعة Iris: موارد شائعة في علم البيانات، يستخدمها الطلاب في مشكلات التصنيف وتصور البيانات.
- الميزات الأربع: طول الكأس، عرض الكأس، طول البتلة، عرض البتلة، لنباتات سيتوزا وفيرسيكلور وفيرجينكا.
- الاستخدام: يمكن استخدام مزيج هذه الميزات للتنبؤ بخصائص زهرة القزحية، ويُرسم التصنيف في الشكل 21.32.
مثال عملي
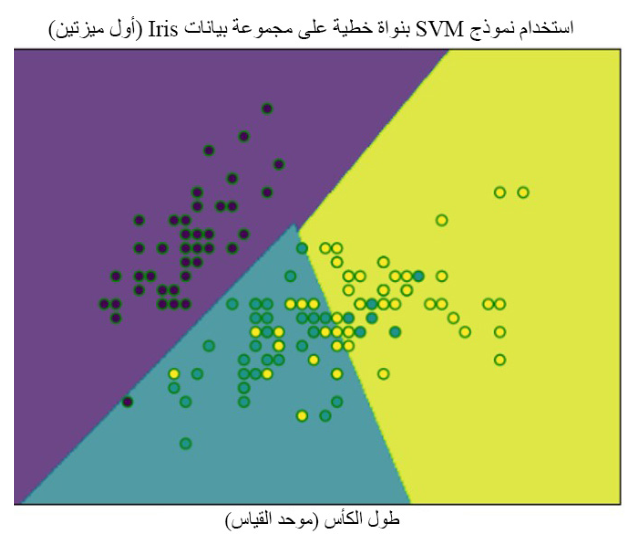
- النتيجة: تم فصل الفئات الثلاث من زهرة السوسن بشكل عام باستخدام الميزتين المختارتين: عرض الكأس وطوله.
- الحدود الملونة: تعطي تمثيلًا مرئيًا واضحًا لمكان الفئات الثلاث في مجموعة البيانات بناءً على توزيع الميزات.
الأشجار والغابات
أشجار القرار والغابات العشوائية
- الأشجار والغابات: في التعلم الآلي للتصنيف تشير إلى أشجار القرار والغابات العشوائية.
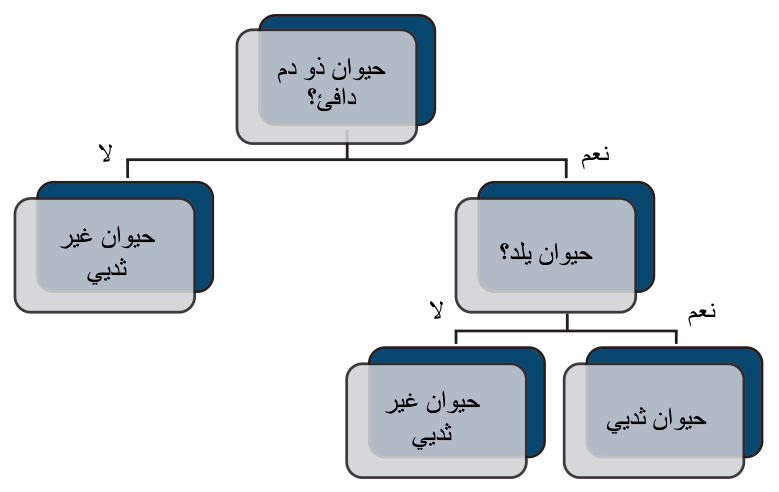
- شجرة القرار: هيكل هرمي تمثل فيه كل عقدة منفصلة اختبارًا من نوع ما، مثل: هل تمطر؟
- الفروع: كل فرع يمثل نتيجة مختلفة للاختبار (نعم) أو (لا).
- العقد الورقية: التي لا تحتوي على عقد فرعية تمثل تسمية الفئة، وهو قرار يتم اتخاذه.
- اتباع المسارات: من العقدة الجذرية (العلوية) إلى الورقة يوفر قواعد يمكن استخدامها للتصنيف.
- أسلوب التعلم الجماعي: يبني الغابة العشوائية أشجار قرارات متعددة لتحسين دقة تصنيفاتها.
- طريقته: تدريب كل شجرة على مجموعة فرعية عشوائية من البيانات المتاحة، ثم حساب متوسط التوقعات للحصول على نتيجة أكثر دقة.
- شعبيتها: بسبب فعاليتها عبر أنواع البيانات المختلفة (التصنيف والانحدار واكتشاف الحالات الشاذة)، وهي سهلة التفسير نسبيًا.
- مثال عملي: كود بايثون يوضح استخدام مصنف شجرة القرار، والدقة وشجرة القرار الناتجة في الشكل 21.35.
ماذا تمثل العقد الورقية في شجرة القرار؟
مثال عملي
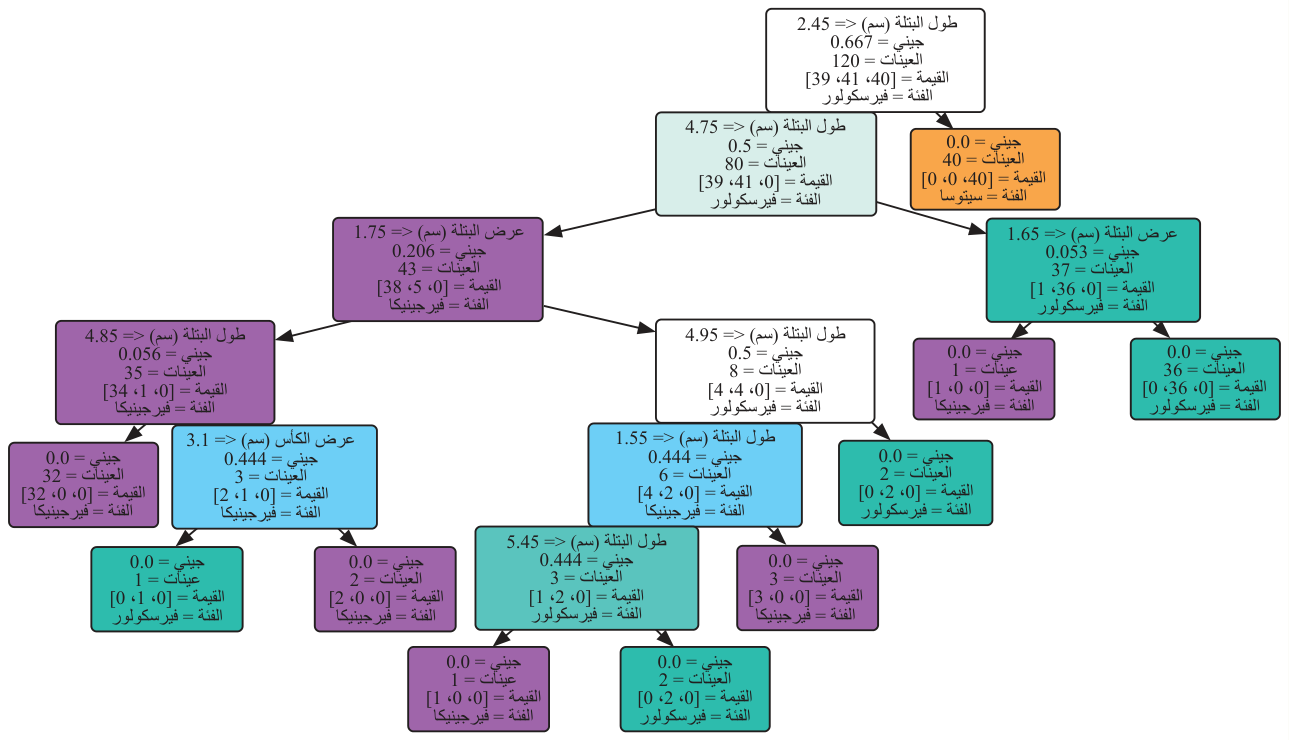
- شجرة السوسن: تستخدم عدة مسارات مختلفة، ويُحدد كل مسار بمجموعة من قيم البيانات التي تحدد احتمالية كون السوسن من فئة معينة.
- عينة جديدة: يمكن اتباع المسار المناسب بقياساتها وتحديد فئتها الأكثر احتمالًا.
طرق بايزي
طرق بايزي والتجميع
- طرق بايزي: مجموعة من الأساليب الإحصائية تعتمد على نظرية بايز، التي تصف احتمال حدوث حدث بناءً على المعرفة السابقة بأحداث قد تكون ذات صلة.
- المصطلحات الثلاثة: P يشير إلى الاحتمال اللاحق، وH يشير إلى الفرضية، وE يشير إلى الدليل.
- صيغة: P(H|E) هو الاحتمال اللاحق للفرضية H بالنظر إلى الدليل E.
- مثال الطبيب: يستخدم خبرته لتحديد احتمالية الإصابة بأمراض مختلفة قد تسبب أعراض المريض، وهذا هو الاحتمال المسبق والفرضية التي يبدأ بها.
- أدلة جديدة: بمجرد إبداء ملاحظات جديدة حول الأعراض ومقارنة احتمالية رؤيتها مع كل مرض، يمكنهم جمع أدلة جديدة.
- التحديث: يسمح بتحديث الفرضيات والحصول على احتمال لاحق محدث لكل مرض، فيراجعون تشخيصهم، وقد تحتاج الطريقة إلى التكرار عدة مرات.
- للذكاء الاصطناعي: هذا النهج الإحصائي مفتاح لمحاكاة الذكاء البشري وتوفير صنع القرار السليم، كأداة استشارة عبر الإنترنت في قطاع الصحة.
- خوارزمية التجميع: تحتاج إلى تحديد الأنماط أو أوجه التشابه من مجموعة البيانات دون أمثلة معنونة، وهذا يقلل عادةً التكاليف.
- تحليل البيانات الاستكشافي: العثور على الأنماط أو العلاقات المخفية في البيانات.
- التسويق المخصص للعملاء: تقسيم العملاء إلى مجموعات بناءً على عادات التسوق أو التركيبة السكانية.
- اكتشاف الانحرافات: العثور على نقاط البيانات غير العادية التي تنحرف بشكل كبير عن المجموعات أو الأنماط المحددة.
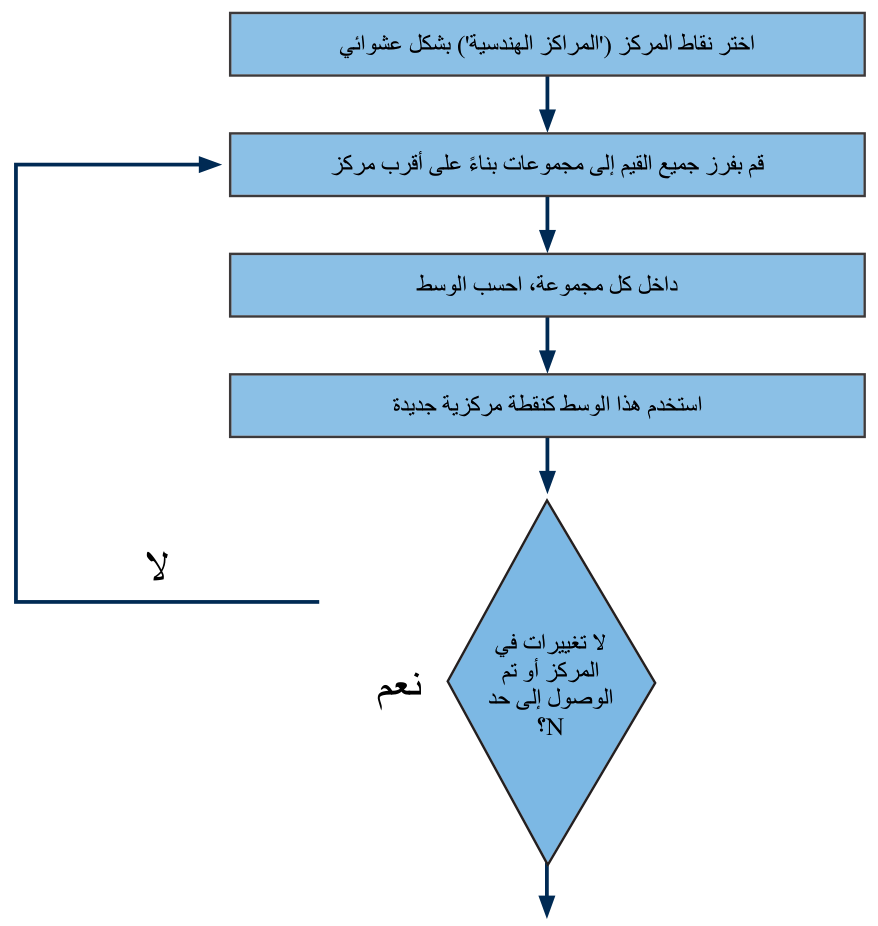
التجميع بالمراكز: كيف تتكون المجموعات؟
- K-means: واحدة من خوارزميات التجميع الأكثر شيوعًا، تعمل بخوارزمية سهلة الفهم نسبيًا.
- K: تمثل عدد المجموعات التي يشتبه في وجودها في البداية.
- N: عند التنفيذ تمثل الحد الأقصى لعدد التكرارات التي ستُنفذ.
- التمثيل: يمثل أفضل في شكل مخطط انسيابي، كما في الشكل 21.36.
مثال عملي
- المثال: يستخدم بايثون لتوضيح K-means، ويعيد النظر في مجموعة بيانات السوسن ويستخدم التجميع لمعرفة هل يمكن تحديد أنواع السوسن بالقيم المختارة.
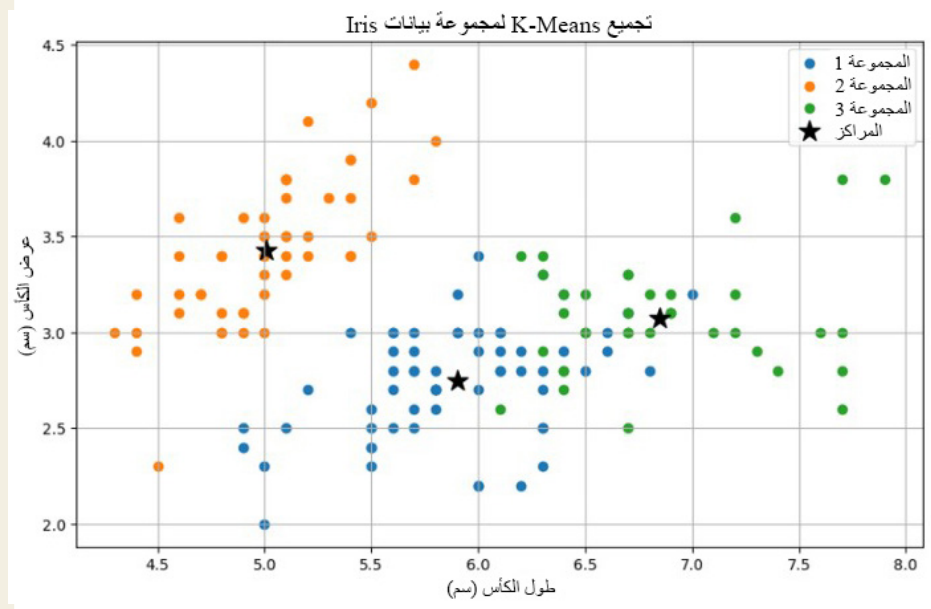
- المجموعات: في الشكل 21.38 يمكنك تحديد ثلاث مجموعات مختلفة بناءً على تجميع ميزاتها المختارة: عرض الكأس وطول الكأس.
- النجوم: تمثل المراكز الهندسية التي تختارها الخوارزمية، وتمثل كل مجموعة إحدى الفئات الثلاث للسوسن.
- الغموض: يوجد بعض الغموض بين المجموعتين 1 و3 لتداخل بعض النقاط، فقد تلزم تحليلات لتحسين التوقعات.
تحليل المكونات الرئيسية (PCA)
تقليل الأبعاد: أقل ميزات وأكثر معنى
- PCA: تحليل المكونات الرئيسية، نوع شائع من تقليل الأبعاد الخطية الإحصائية الذي يستخدم التعلم دون إشراف.
- تقليل الأبعاد الخطية: خوارزمية تقلل عدد ميزات البيانات مع الاحتفاظ بأكبر قدر من المعلومات الأساسية والأنماط والعلاقات.
- المكونات الرئيسية: يشار إلى المخرجات بها، وعند التقليل الصحيح يحتوي الأول على معلومات أكثر أهمية من الثاني، والثاني أكثر من الثالث.
- الأهمية: تقليل الميزات من أربعة إلى اثنتين (إذا تم بشكل صحيح) لا يفقد بيانات مهمة، وكلما زاد عدد الميزات زادت صعوبة معالجة البيانات بسرعة وكفاءة.
مثال عملي
تقليل الأبعاد عمليًا واكتشاف الحالات الشاذة
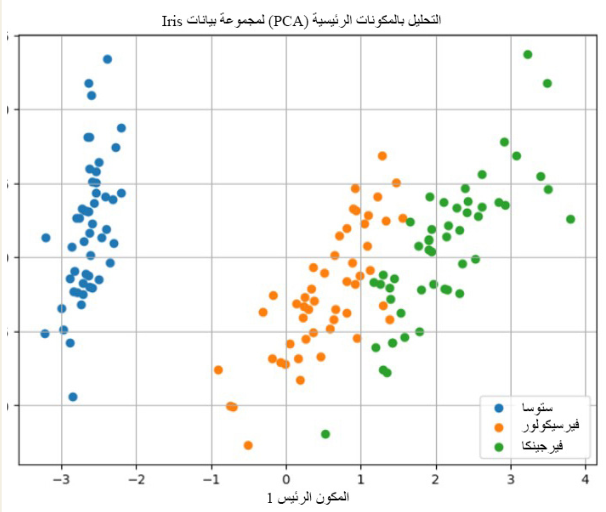
- المثال: يستخدم PCA في بايثون لتقليل أربع ميزات من مجموعة بيانات السوسن (طول الكأس، عرض الكأس، طول البتلة، عرض البتلة) ليصبحا مكونين رئيسيين.
- الفائدة: دون تقليل عدد الميزات من أربعة إلى اثنين كان من الصعب رسم البيانات في فضاء ثنائي الأبعاد.
- الحالات الشاذة: تشمل البريد العشوائي بدلًا من العادي، أو (في الطب) شذوذ الأنسجة الخبيث وليس الحميد.
- الجيران الأقرب (kNN): ربما النهج الأكثر بساطة وفعالية لاكتشاف الحالات الشاذة.
الجيران الأقرب (kNN)
الجيران الأقرب: من يبتعد عن الجميع؟
- الجيران الأقرب: تعمل الخوارزمية بحساب المسافة بين نقطة البيانات وأقرب جيرانها k في مجموعة بيانات التدريب.
- الانحراف: إذا كانت النقطة أبعد بكثير من جيرانها الأقربين وفقًا لحد مفضل، تُصنف على أنها انحراف.
- الحد: يمكن أن يختلف ويُحدد بمزيج من المعرفة الإحصائية ومعرفة المجال.
- المثال: ينشئ بيانات اصطناعية فيها انحرافات، ويلائم نموذج kNN لنقاط البيانات العادية فقط، ثم تُحسب المسافات لأقرب نقاط k.
- القاعدة: أي نقاط فوق نسبة 95% تعتبر انحرافًا.
مثال عملي
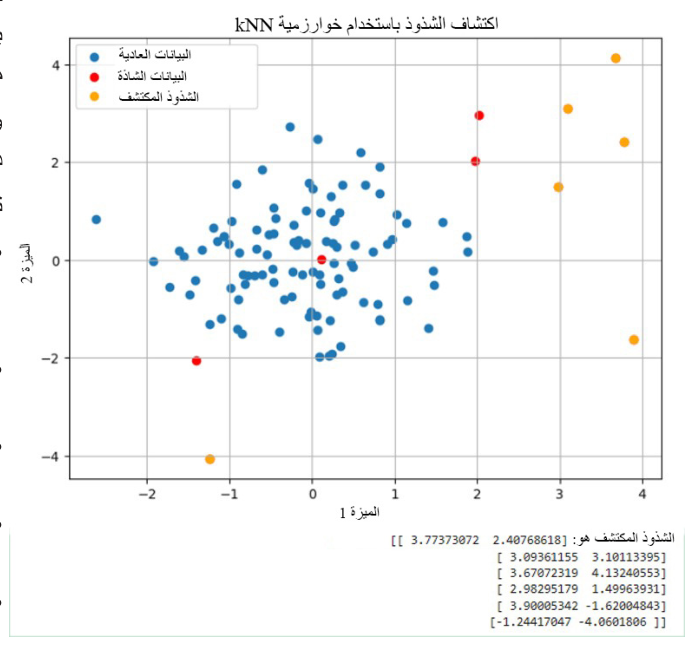
- الحدود: العملية ليست مثالية، فقد حُددت النقاط البعيدة بشكل صحيح ولم يُحدد بعض الأقرب إلى المركز.
- التحسين: يلزم تحسين النموذج وزيادة دقته العامة قبل استخدامه بشكل موثوق في بيئة الإنتاج.
- هندسة الميزات: استخدام المعرفة بالمجال لتحسين اختيار الميزات المستخدمة في النموذج.
- تقنيات أخرى: استخدام خوارزمية أو نموذج مختلف لاكتشاف التأثير في دقة الكشف، وضبط النموذج عن طريق تعديل النسب أو الحدود.
متى تُعد نقطة بيانات انحرافًا في مثال kNN؟
استخدامات وفوائد وعيوب الشبكات العصبية
الشبكات العصبية: فوائد وتحديات
- التطبيقات الأربعة: تعرف الأنماط، وأنظمة التوصية، واكتشاف حالات الانحراف، وأنظمة التحكم المعقدة في الوقت الفعلي.
- الفوائد الخمس: القدرة على التعلم من كميات هائلة من البيانات دون برمجة صريحة، فتكتشف الأنماط والروابط المخفية.
- المعالجة المتوازية: تجعلها فعالة للغاية من الناحية الحسابية وقادرة على التوسع بسرعة.
- التكيف: قابلية كبيرة للتكيف، لا سيما مع علاقات البيانات المعقدة وغير الخطية.
- الاستخراج والتعميم: استخراج الميزات الجديدة تلقائيًا فيقل عمل عالم البيانات، وتعميم جيد على البيانات الجديدة.
- التحديات: شدة التعقيد التي تصعّب تفسيرها وبالتالي تحقيق الذكاء الاصطناعي القابل للتفسير (XAI).
- الموارد: استهلاك قدر كبير من موارد الحوسبة، مثل GPU وحدات معالجة الرسومات والذاكرة.
- البيانات: احتمال تطلبها كميات هائلة من البيانات المعنونة للتدريب الأولي، وهو غالبًا نشاط مكلف، وقد لا تتوفر بيانات كافية بجودة مناسبة.
- تمام الملاءمة: تتعرض في بعض الأحيان لمشكلة تمام الملاءمة، ما يمكن أن يمثل مشكلة عند معالجة بيانات جديدة.
- الهجمات العدائية: قد تكون الشبكات العصبية عرضة لها، لتعطيل العمليات أو لخلق نتائج ملائمة للمهاجم أو لميزة تجارية.
- الغموض: وجود الثغرات مع غموض اتخاذ القرار يثير مخاوف العدالة والتحيز والتأثيرات الاجتماعية ويآكل الثقة.
ما التطبيقات الأربعة الرئيسة للشبكات العصبية؟
ج2 أدوات تطوير حلول الذكاء الاصطناعي
أدوات تطوير حلول الذكاء الاصطناعي
- مشهد أدوات الذكاء الاصطناعي: واسع ومعقد على حد سواء، ويضم مجموعة واسعة من المنصات التجارية والمفتوحة المصدر والتطبيقات والمكتبات والأطر.
- جمع البيانات وتصنيفها: جمع وتصنيف البيانات المجمعة من مصادر متعددة لإنشاء مجموعة بيانات تستخدمها نماذج التعلم الآلي، ومن أدواتها Labelbox.
- استكشاف البيانات وتمثيلها: تتضمن هذه المرحلة تحليل البيانات المجمعة لإجراء التجارب واكتساب الأفكار، وأدواتها Jupyter Notebook وPandas وMatplotlib وSeaborn وTableau.
- التدريب النموذجي والاختبار والتقييم: تتضمن هذه المرحلة تدريب النموذج باستخدام الميزات المحددة والمعلمات الفائقة المرتبطة بها. تشمل الأدوات النموذجية: scikit-learn وTensorFlow وPyTorch وKeras.
- نشر النموذج: بمجرد تدريب النموذج بنجاح يتم نشره في بيئات الإنتاج حيث يمكنه عمل تنبؤات بشأن البيانات الجديدة، ومن الأدوات النموذجية Docker وKubernetes وFastAPI.
- اجمع وصنّف: أنشئ مجموعة بيانات من مصادر متعددة.
- استكشف ومثّل: حلّل البيانات وجرّب لاكتساب الأفكار.
- درّب واختبر: درّب النموذج بالميزات والمعلمات ثم قيّمه.
- انشر: ضع النموذج في بيئة الإنتاج ليتنبأ بالبيانات الجديدة.
نشر النموذج
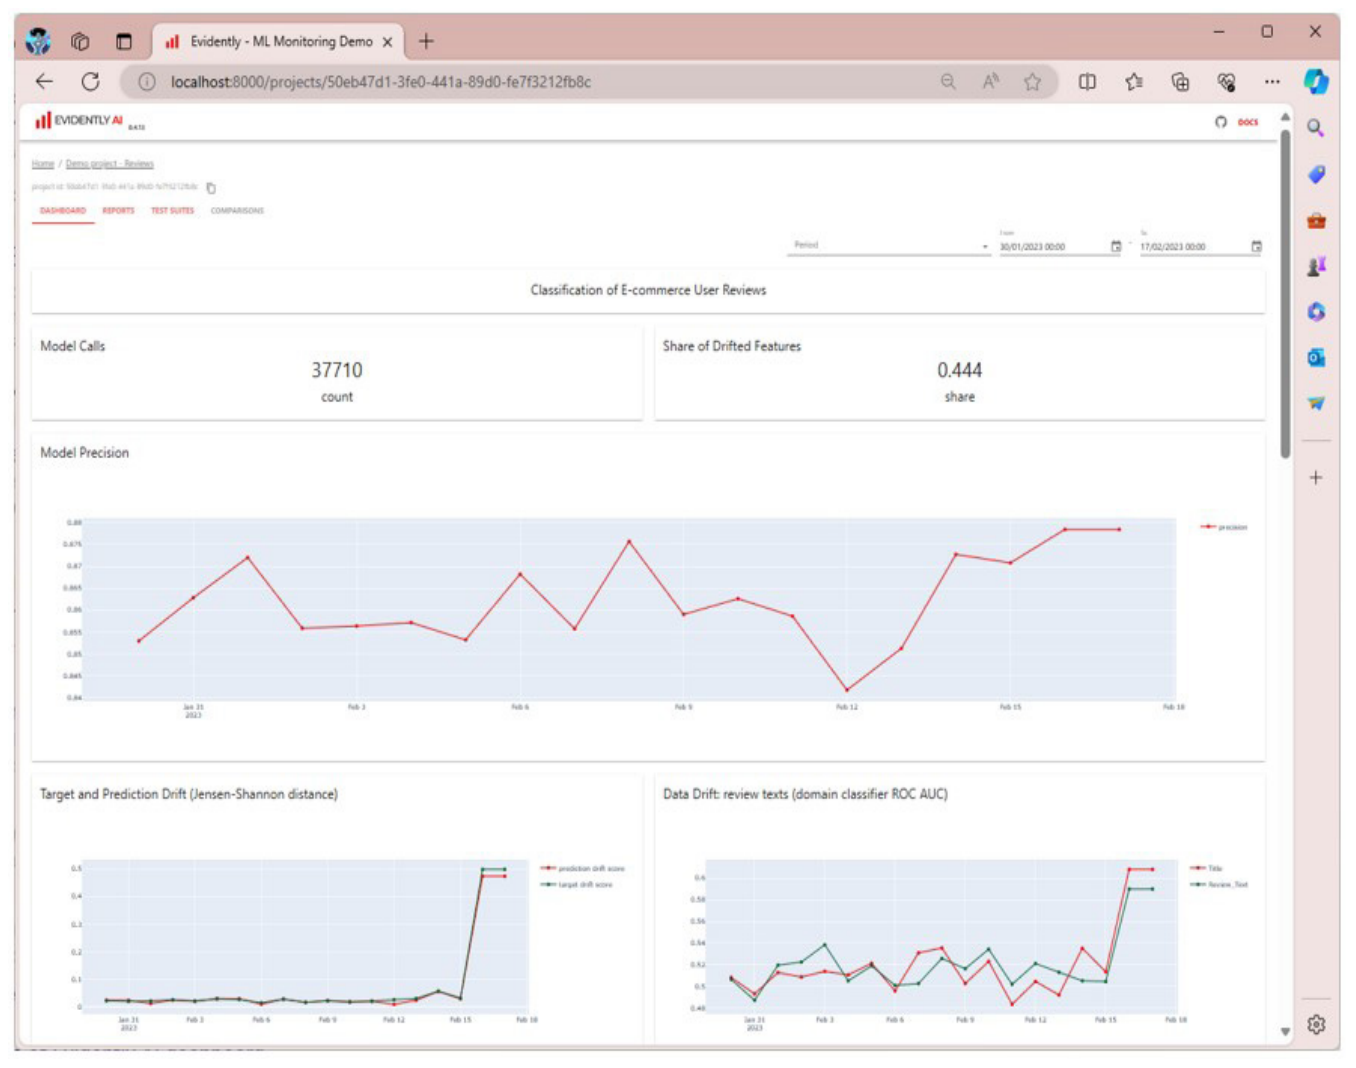
- الذكاء الاصطناعي القابل للتفسير (XAI): استخدام الوسائل المرئية ولوحة التحكم طريقة مثالية لتقديم النتائج بطريقة شفافة وذات مغزى.
- ما تسمح به: تحديد المقاييس الشائعة، تسجيل هذه المقاييس بانتظام، إنشاء مكون مرئي لهذه المقاييس، إنشاء لوحة معلومات تحتوي على عدد من المكونات المرئية المختلفة.
- Evidently AI: أداة مفتوحة المصدر لمراقبة نماذج التعلم الآلي وتحليلها أثناء تشغيلها في الإنتاج.
- التنبيهات: تدعم تنبيهات قابلة للتخصيص تفعّل الإشعارات عندما تنخفض المقاييس عن مستويات التسامح المحددة أو تتجاوزها.
برمجة الحاسب ولغات البرمجة النصية لحلول كتابة الكود
لغات البرمجة: بايثون وجافا وR وليسب
- اللغات: يمكن استخدام لغات كثيرة لتطوير الخوارزميات التي تشكل جوهر حلول الذكاء الاصطناعي، منها بايثون وآر وجافا.
- بايثون: واحدة من أكثر اللغات شعبية في العالم وغالبًا مقدمة المتعلم للبرمجة، ومزيج من نماذج البرمجة (الإجرائية والوظيفية والموجهة للكائنات).
- لغة مفسرة: يُترجم كل توجيه إلى بايت كود بايثون ثم إلى كود الآلة المستهدف، فلا تكون أسرع لغة لكنها مناسبة لعلم البيانات والذكاء الاصطناعي.
- الحزم: قابلة للتوسعة وتستورد حزمًا إضافية (كثير منها مكتوب بلغة C عالية السرعة) لحل التحديات الرياضية والإحصائية والخوارزمية.
- نامباي (NumPy): حزمة أساسية للحوسبة العددية، تدعم المصفوفات الكبيرة متعددة الأبعاد ودوالًا رياضية للعمل عليها بكفاءة.
- الباندا (Pandas): مكتبة لتحليل البيانات ومعالجتها، توفر هياكل مثل DataFrames وSeries للبيانات المنظمة.
- ماتبلوتليب (Matplotlib): مكتبة رسم لإنشاء تصورات ثابتة وتفاعلية ومتحركة في بايثون.
مثال عملي
- المثال: برنامج بايثون يحسب ويخرج متوسط قائمة قيم الأعداد الصحيحة، وهي عملية إحصائية شائعة.
- الرموز: تستخدم بايثون الرموز للإشارة إلى هياكل البيانات، فيُستخدم [ ] للقائمة.
- الاستيراد: من الضروري استيراد دالة mean من وحدة statistics، فهي ليست دالة مضمنة.
- pip: يمكن تنزيل الحزم والوحدات الأخرى بمدير حزم بايثون pip من مستودع pypi.org.
جافا
- جافا: طُورت عام 1995، فهي أصغر من بايثون التي ظهرت عام 1991، وتُعد لغة قائمة على الفئة وموجهة للكائنات (OOP).
- WORA: يمكن نظريًا كتابة البرامج مرة واحدة وتشغيلها في أي مكان لأن جزءًا من كود المصدر يُجمَّع إلى بايت كود جافا.
- JVM: يُنفذ كود جافا على آلة جافا الافتراضية المتوفرة لمعظم بنى الحواسيب، فتصبح قابلة للنقل بشكل كبير.
- الطابع: جافا قوية وثابتة، فبمجرد إعلان المتغير لا يمكن تعيين قيم لا تطابق نوع بياناته، بخلاف بايثون الديناميكية.
لماذا تُعد جافا قابلة للنقل بشكل كبير؟
مثال عملي
- المثال: المشكلة نفسها من مثال بايثون، لكن بلغة جافا.
- الجهد: حل جافا يتطلب جهدًا أكثر من بايثون أو ليسب، إذ يستخدم فئة ودالة وكتلًا بأقواس معقوفة وحلقة for محسنة.
- للمبتدئين: معقدة وأكثر رهبة مقارنة ببايثون، ما يفسر نمو بايثون وارتفاع شعبيتها في السنوات العشر الأخيرة.
- لغة R: لغة مصممة خصيصًا للحوسبة الإحصائية والرسوم، وبارعة في التعامل مع هياكل البيانات المسماة (المصفوفات والمتجهات وإطارات البيانات والقوائم).
- العمليات المتجهة: إحدى مزاياها، تجعل معالجة البيانات وتحليلها بسيطة للغاية، وتقلل التكرارات وأوقات المعالجة بشكل كبير.
- المثال: كود R يحسب المتوسط الحسابي بالطريقة نفسها، ولها دالة mean مدمجة تُستخدم فورًا دون استيرادها من مكتبة.
مثال عملي
ليسب (Lisp)
- ليسب: اختصار لمعالجة القوائم، واحدة من أقدم لغات البرمجة عالية المستوى، طُورت نسختها الأصلية عام 1958.
- مجموعة لغات: ليسب العادية من أشهرها، جنبًا إلى جنب مع كلوجر.
- نقطة قوتها: إجراء العمليات الحسابية الرمزية ودعم الدوال العودية، فهي مناسبة للذكاء الاصطناعي وإثبات النظريات ومعالجة اللغة الطبيعية.
- الدالة العودية: تسمح للوظائف بالاتصال بنفسها لمعالجة خوارزميات مثل العوامل ومتتالية فيبوناتشي والبحث الثنائي.
- المثال: برنامج ليسب يحسب المتوسط الحسابي بالطريقة نفسها.
مثال عملي
- الصياغة: قد تكون مربكة للوهلة الأولى لاستخدامها الأقواس للإشارة إلى الكود وهياكل البيانات معًا.
- الحساب: في هذا المثال يتم حساب المتوسط يدويًا، عن طريق حساب مجموع جميع العناصر في القائمة ثم تقسيمها على طولها.
المكتبات والأطر
المكتبات والأطر: الفرق بينهما
- المكتبات والأطر: طرود قابلة لإعادة الاستخدام من أكواد خارجية تساعد المطورين في المهام الشائعة، والفرق في طريقة دمجها في المشاريع.
- المكتبة: يمكن لمطور البرامج أو عالم البيانات اختيار عناصر الكود التي يرغبون في استخدامها، كما أن بنية الحل تخصهم أيضًا.
- إطار العمل: يتم توفير الهيكل بشكل عام بواسطة البرنامج ويقوم مطور البرامج أو عالم البيانات بإضافة رمز إليه، والهيكل ليس تصميمهم الخاص.
| مكتبة | إطار العمل |
|---|---|
| مجموعة من الفئات، والدوال، والثوابت، وما إلى ذلك. | يوفر هيكلاً يمكن للمطور بناء مشروعه عليه |
| يقوم المطور بتضمين هذه العناصر بحسب الحاجة | يتم ربط كود المطور واستدعاؤه بحسب الحاجة من الإطار |
| يستدعي المطور هذه العناصر بحسب الحاجة | يحدد الإطار إلى حد كبير هيكل المشروع |
| يتحكم المطور في بنية الحل البرمجي |
- Scikit-learn: مكتبة مفتوحة المصدر لبايثون مبنية على NumPy وSciPy وmatplotlib، تشتهر ببساطتها وسهولة استخدامها.
- الدعم: مجموعة كبيرة من خوارزميات التعلم الآلي تحت الإشراف ودون إشراف، وخيار مثالي لاستكشاف البيانات وتحليلها.
- TensorFlow: مكتبة مفتوحة المصدر طورتها Google، تُستخدم للحساب العددي والتعلم الآلي (ML).
- الشبكات العصبية: تساعد على بناء شبكات تكشف الأنماط والارتباطات وتفك رموزها.
- اللغات: تُستخدم أساسًا مع بايثون وC++ (للسرعة)، وتدعم واجهة API للغات Go وJava وSwift وJavaScript.
مكتبات وأطر أخرى لرؤية الحاسب والبيانات الضخمة
- OpenNN: تعني الشبكات العصبية المفتوحة، مكتبة مكتوبة للغة C++ لتنفيذ الشبكة العصبية، وتُستخدم لتطوير النماذج التنبؤية.
- OpenCV: تعني رؤية الحاسب مفتوحة المصدر، طورتها Intel في البداية، وتدعم C++ وبايثون وJava وخوارزميات لرؤية الحاسب والتعلم الآلي.
- تطبيقاتها: أنظمة CCTV للكشف عن الحركات المشبوهة، والسيارات ذاتية القيادة، وأنظمة تمييز الوجوه.
- Weka: بيئة Waikato لتحليل المعرفة، مكتبة مفتوحة المصدر بلغة Java، توفر أدوات لتحليل البيانات والنمذجة التنبؤية والتصور.
- واجهتها الرسومية (GUI): تتيح إنشاء أنواع نماذج مختلفة دون كتابة أي كود، وتستفيد من التوثيق الجيد ودعم المجتمع.
- Apache Hadoop: إطار مفتوح المصدر لتخزين ومعالجة البيانات الضخمة عبر المجموعات، معروف بقابليته للتطوير والمرونة في مواجهة الأعطال.
- HDFS: نظام الملفات الموزع، نظام تخزين قابل للتطوير ويتحمل الأخطاء ويقسم البيانات عبر أجهزة متعددة.
- نموذج MapReduce: يعالج مجموعات البيانات الكبيرة باستخدام خوارزمية موزعة، ونظام YARN يقوم بجدولة وإدارة الموارد في المجموعة.
- المعالجة العنقودية: شبكة من أجهزة الحاسب أو العقد المتصلة، مفيدة بشكل خاص لتطبيقات الذكاء الاصطناعي.
- التوسع: يمكن توسيع نطاقها أو تقليله بسرعة بحسب الأحمال دون تعديل الأكواد أو النماذج أو البيانات الأساسية.
- التسامح مع الأخطاء: فشل العقد الفردية ليس كارثيًا لأن الآخرين يتابعون المعالجة دون توقف.
المعالجة العنقودية

استخدام الأدوات التي توفرها بيئات التطوير المتكاملة وأدوات تطوير الأكواد ذات الصلة
بيئات التطوير: الدفاتر وإبراز الكود
- علماء البيانات: عند تطوير أنظمة الذكاء الاصطناعي يتعين عليهم استكشاف البيانات وإجراء العديد من التجارب لإثبات أفكارهم ومفاهيمهم.
- بيئات التطوير التقليدية: مثل PyCharm وMicrosoft VS Code ليست أفضل الخيارات لتتبع التقدم أو إنشاء سجل سردي للخطوات.
- Jupyter Notebook: تطبيق قائم على الويب لإنشاء ومشاركة مستندات فيها تجارب تعلم آلة قيمة، وكل دفتر مزيج من الخلايا.
- الخلايا: سرد وملاحظات بلغة Markdown، وكود برنامج قابل للتنفيذ، ومخرجات تفاعلية كالصور ومقاطع الفيديو وLaTeX وHTML.
- Markdown: لغة ترميز خفيفة الوزن لتنسيق مستندات النص العادي، وغالبًا لملفات README والوثائق، وتعلمها أسهل بكثير من HTML.
- التحرير: يمكن النقر فوق كل خلية ثم تحريرها أو حذفها أو إعادة تسلسلها، وبعد إعادة تشغيلها تتحدث الخلية الناتجة.
- الحفظ: يمكن حفظ الدفاتر محليًا أو وضعها في VCS للتعاون أو مشاركتها عبر الإنترنت.
- ملفات ipynb: التنسيق الأساسي JSON، فهي قابلة للنقل بشكل كبير عبر الأنظمة والتطبيقات.
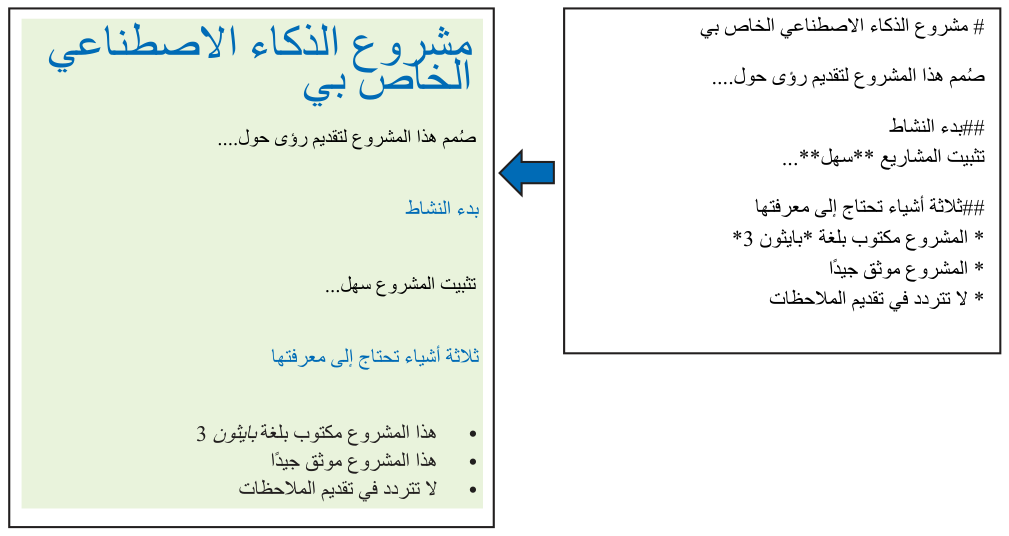
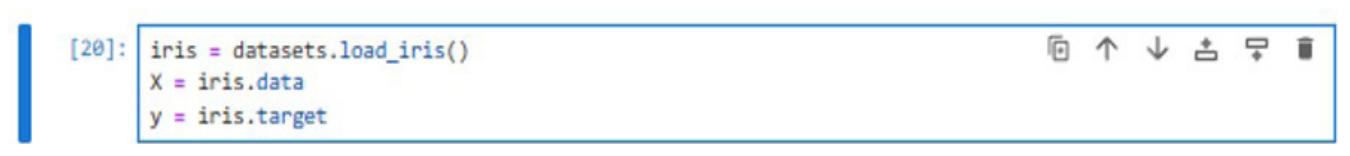
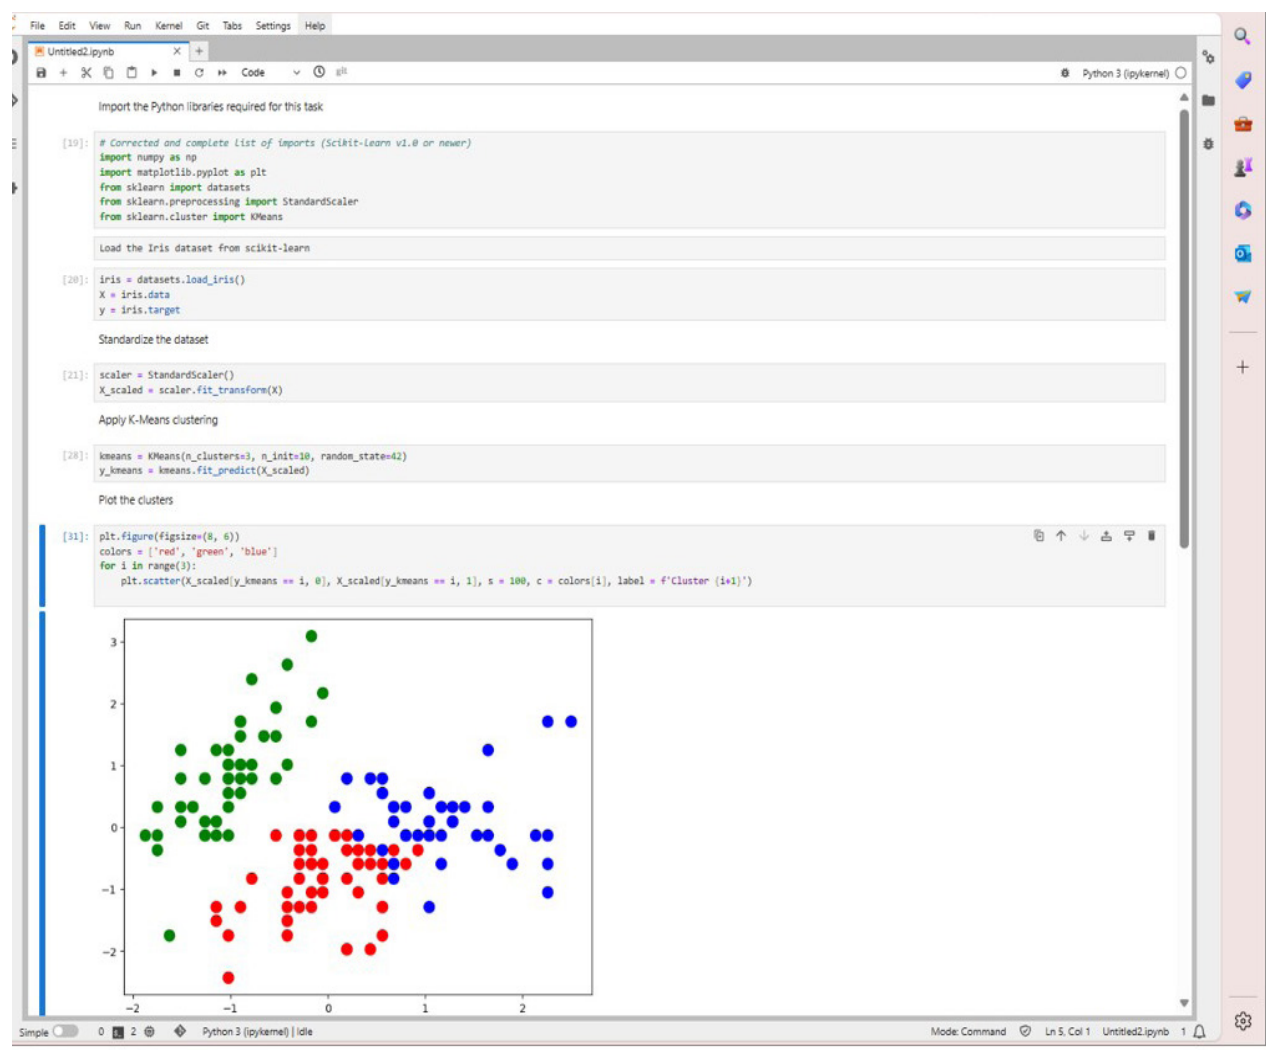
مثال عملي
- المثال: يوضح استخدام دفتر Jupyter لاستكشاف تصنيف زهرة السوسن باستخدام خوارزمية التجميع K-means الخاصة بلغة scikit-learn.
إبراز الأكواد البرمجية والقواعد النحوية
- تمييز بناء الجملة: أدوات الكود القديمة كانت أحادية اللون، أما بيئات التطوير الحديثة ومحررات النصوص الشهيرة فتدعمه جميعًا.
- أسباب استخدامه: يساعد المستخدم على التنقل في الكود، ويحسن قابلية قراءته وفهمه، ويلبي احتياجات ذوي الإعاقات البصرية.
- أيضًا: يساعد على تحديد الأخطاء في بناء الجملة أو المنطق، ويقلل إجهاد العين.
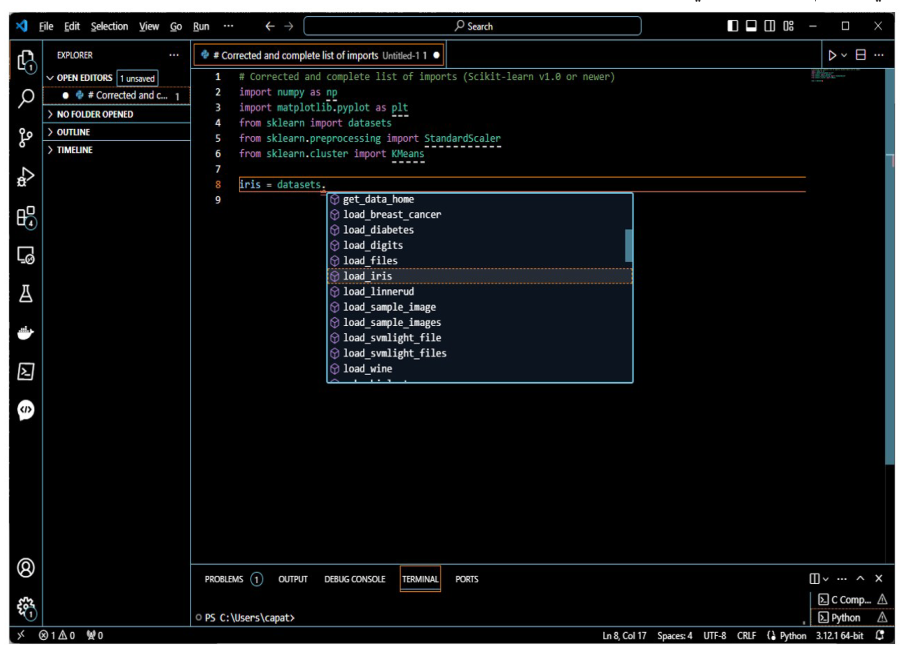
مثال عملي
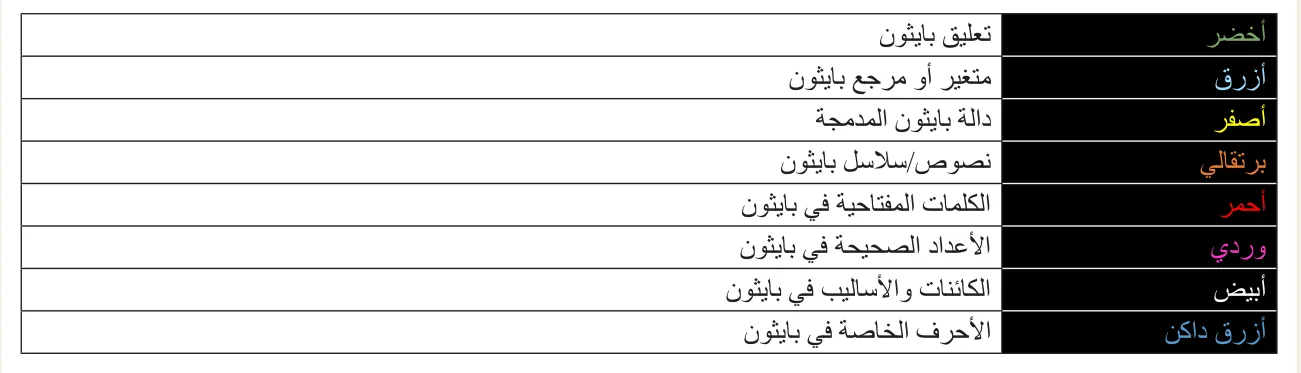
ألوان إبراز كود بايثون ومعنى كل لون.
| أخضر | تعليق بايثون |
| أزرق | متغير أو مرجع بايثون |
| أصفر | دالة بايثون المدمجة |
| برتقالي | نصوص/سلاسل بايثون |
| أحمر | الكلمات المفتاحية في بايثون |
| وردي | الأعداد الصحيحة في بايثون |
- تعديل الألوان: تستخدم اللغات المختلفة مفاتيح تلوين مختلفة، وقد تُعدل خيارات بايثون لتناسب التفضيلات الشخصية.
تنفيذ الأكواد البرمجية
- التنفيذ التلقائي للكود: ميزة مفيدة في بيئات التطوير الحديثة.
- طريقته: تقدم اقتراحات للمطور عما يكتبه بعد ذلك لإكمال سطر الكود، فتقلل الأخطاء المحتملة وتجعل إنشاء الكود أسرع.
- co-pilot: ملحق يستخدم الذكاء الاصطناعي لاقتراح حلول مهام البرمجة الشائعة، ويجب فحص محتواه بدقة قبل الاستخدام.
المترجم الشفوي / المترجم الإلكتروني
المفسِّر والمجمِّع: كيف يُنفَّذ الكود؟
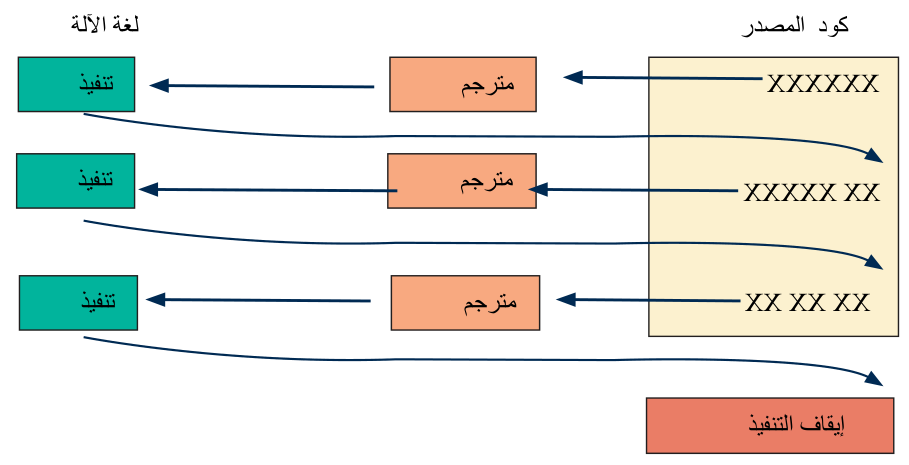
- الترجمة: يمكن لوحدة المعالجة المركزية (CPU) تنفيذ كود الآلة فقط، فيجب ترجمة أي كود تكتبه (بايثون أو R أو جافا) قبل تشغيله.
- الشكلان الأكثر شيوعًا: التفسير والتجميع، ولكل منهما مزايا وعيوب، وقد تستخدم بعض اللغات مزيجًا منهما.
- المفسِّر: برنامج مساعد يأخذ كود المصدر سطرًا في كل مرة ويترجمه إلى لغة الآلة وينفذه.
- الخطأ: إذا واجه سطرًا لا يفسره بنجاح فإنه يتعطل ويبلغ عن خطأ في بناء الجملة.
- السرعة: غالبًا بطيئة نسبيًا، وفرصة التحسين فيها ضئيلة مقارنة بالتجميع.
- اللغات المفسرة: بايثون وليسب وR بشكل عام، وبايثون تُترجم أولًا إلى بايت كود بايثون في مرحلة وسيطة، ما يسمح بتحسين أساسي.
تجميع
- التجميع: يُستخدم زوج من الأدوات، المترجم والموصل، لترجمة كود البرنامج بأكمله إلى لغة الآلة وإنشاء ملف تنفيذي مستقل.
- الميزة الأساسية: أن المترجم يمكنه رؤية ومعالجة رمز المصدر للبرنامج بأكمله دفعة واحدة بدلًا من سطر بسطر، فلديه فرصة لتحقيق تحسين كبير في الكود الناتج.
- الخطأ: إذا واجه أخطاء في بناء الجملة أثناء الترجمة تتوقف العملية دون ملف تنفيذي، بخلاف الكود المفسر الذي ينفذ سطرًا بسطر حتى يحدث خطأ.
- اللغات المترجمة: فورتران وجافا، وفي جافا يُترجم الكود إلى بايت كود ثم تفسره آلة جافا الافتراضية (JVM)، وبعض اللغات مثل ليسب تأتي في شكل مفسر أو مجمع.
ماذا يحدث عند مواجهة خطأ في بناء الجملة في أثناء الترجمة؟
تصحيح الأخطاء
تصحيح الأخطاء ومنصة إدارة الأكواد
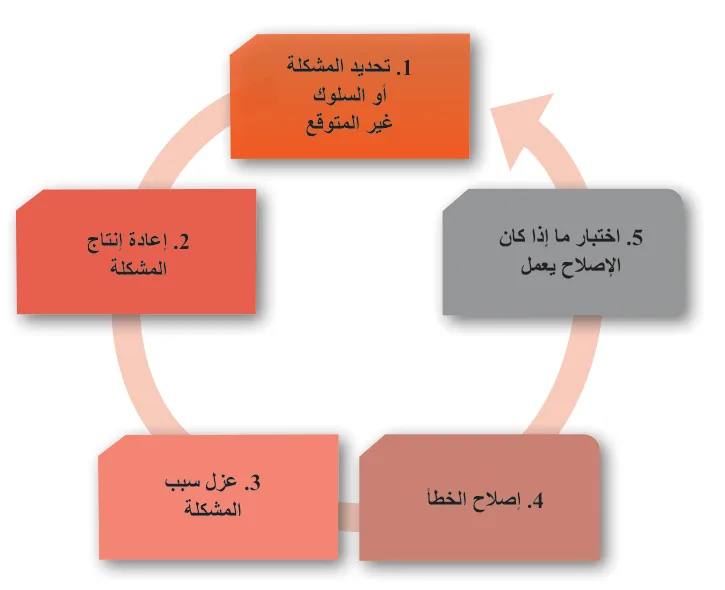
- تصحيح الأخطاء: غالبًا ما يكون العثور على الأخطاء وتصحيحها أمرًا صعبًا في البداية، لكنه عادة ما يصبح أسهل بمجرد أن تصبح لغة البرمجة المستخدمة مألوفة.
- خمس مراحل: عملية من خمس مراحل، وقد تظهر مشكلات جديدة بعد الإصلاح، فقد تدور العملية بشكل حتمي.
- التتبع: يسمح للمطورين بمتابعة تنفيذ الكود سطرًا بسطر ومراقبة الأسطر التي تُنفذ فعليًا.
- المراقبة/الفحص: تسمح بمراقبة تغير قيم المتغيرات في أثناء التنفيذ.
- نقاط التوقف: تحدد الأماكن التي يتوقف فيها الكود عن التنفيذ العادي لتتبع الخط سطرًا بسطر وفحص المتغيرات.
- المشاريع: من الضروري لمشاريع الذكاء الاصطناعي ألا تؤثر الأخطاء في مراحل التدريب أو الاختبار أو الإنتاج.
منصة إدارة الأكواد
- منصة إدارة الأكواد: مشاريع الذكاء الاصطناعي كبيرة جدًا لمطور واحد، فيلزم استخدام منصة لإدارة الكود.
- ما تتيحه المنصة: تخزين قاعدة الشفرة الخاصة بهم بطريقة آمنة ومضمونة، وإدارتها وتأمينها، والتعاون بطريقة منهجية، وتتبع التغييرات (توفير شكل من أشكال التحكم في الإصدار).
- أيضًا: دعم فروع متعددة للتطوير الموازي والتجريبي، ومراقبة المشكلات والأخطاء وطلبات الميزات لترتيب الأولويات.
- Git: حتى وقت كتابة الكتاب ما يزال نظام التحكم في الإصدارات (VCS) الأكثر شهرة في العالم.
- الواجهات: GitLab وGitHub تتيح تثبيت Git محليًا ودفع الالتزامات إلى مستودع بعيد وسحب التغييرات منه.
- المناطق الثلاث: دليل العمل/الشجرة، والفهرس أو منطقة التدريج، ومستودع Git، وتوجد عادةً على حاسوب المطور.
- حالة التتبع: عند البداية دليل العمل نظيف، وتتغير حالته بإضافة الأصول أو حذفها أو تعديلها، وتُتعقب التغييرات أو يُلغى تتبعها.
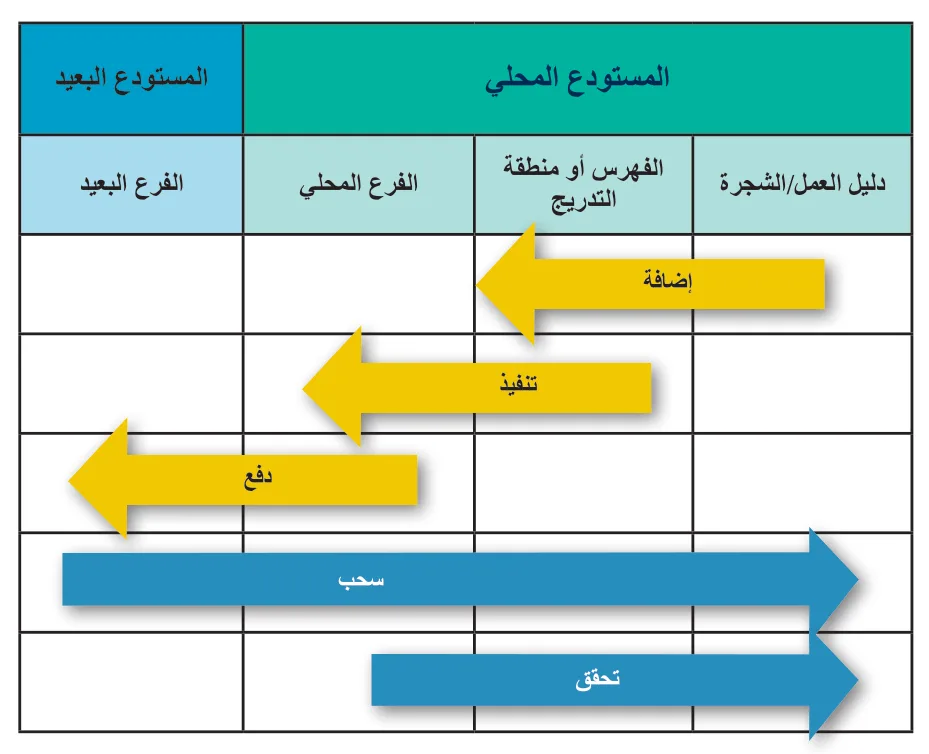
- عدّل الملفات: غيّر دليل العمل بإضافة الأصول أو حذفها أو تعديلها.
- انقل للتدريج: أضف الملف المعدل إلى منطقة التدريج.
- نفّذ التغييرات: سجّل التغييرات في المستودع المحلي مع تعليق وصفي.
- شارك التغييرات: ادفع التغييرات إلى المستودع البعيد.
- اسحب التحديثات: يجلب الآخرون التغييرات المقبولة إلى أجهزتهم.
- git add: ينقل الملف المعدل إلى منطقة التدريج.
- git commit: ينفذ التغييرات المتعقبة على مستودع Git المحلي، ومن الأفضل تضمين تعليق وصفي يتعلق بالغرض منه.
- git push: بعد التغييرات في المستودع المحلي يشارك/يحمّل التغييرات إلى المستودع البعيد.
- تعارضات الدمج: شائعة عندما يغير مطورون كثيرون الأجزاء نفسها، ويحلها مالك قاعدة الأكواد، ولتجنبها يُنصح بالالتزام قليلًا وفي كثير من الأحيان.
- الفروع: تفرعات مختلفة من المشروع، ويُتوقع من العاملين في المجال استعادة الإصدارات السابقة من الأكواد التي كتبوها.
- الحوسبة السحابية: يمكن إجراء مشروع الذكاء الاصطناعي داخل الحدود المادية للمنظمة، لكن المؤسسات تبحث عادةً عن بيئات عبر الإنترنت لبناء الأنظمة واختبارها ونشرها.
- المنصات: خدمات أمازون ويب (AWS)، ومنصة جوجل السحابية (GCP)، وMicrosoft Azure، ذات التكلفة الإجمالية للملكية (TCO) المنخفضة والمرنة.
- الميزة: قابلية التوسع السريع أفقيًا (مزيد من الحوسبة) وعموديًا (موارد أفضل)، وتتناسب مع الطبيعة الديناميكية لطلبات خدمات الذكاء الاصطناعي.
خدمات السحابة للذكاء الاصطناعي
- خدمات Azure المعرفية: تضيف الرؤية واللغة والكلام واتخاذ القرار إلى التطبيقات.
- التعلم الآلي من Azure: لتطوير النماذج وتدريبها ونشرها في نطاق واسع.
- خدمات الروبوتات: لبناء ونشر مساعدات روبوتية تتفاعل مع المستخدمين عبر قنوات مثل الدردشة والبريد الإلكتروني.
- منصة جوجل للذكاء الاصطناعي: مجموعة احترافية لتطوير التعلم الآلي ونشره، منها الدفاتر والتدريب والتنبؤات وحلول الذكاء الاصطناعي المبنية مسبقًا.
- أمازون سيج ميكر: خدمة AWS مدارة بالكامل، وتوفر مثيلات Jupyter Notebook والخوارزميات المحسنة المضمنة وتدريب النماذج ونشر النموذج ومراقبة النماذج وإدارتها.
- الدفع أولًا بأول: يدفع العميل فقط مقابل الحوسبة والخدمات التي يستخدمها فعليًا، مع التوسيع والتقليص بحسب الحاجة.
أمازون سيج ميكر
تمرين تقييمي 21.3
التمرين التقييمي: تطوير الحل وتركيز المهارات
تركيز مهاراتك
- العمل متدربًا: في علوم البيانات، وخاصة الذكاء الاصطناعي، دور وظيفي رائع وسيكون في الغالب على مشاريع ذات تأثير إيجابي.
- المهارات البرمجية: ثقة عند التعامل مع لغات البرمجة وأطر الذكاء الاصطناعي وتدفقات البيانات الديناميكية في الوقت الفعلي.
- الاختبار: مهارات اختبار جيدة لاختبار النماذج وتحسين الخوارزميات بناءً على نتائج الاختبار.
- مهارات البيانات: بصفتك متدربًا في علم البيانات، ستقوم في البداية بدعم الموظفين الأكثر خبرة، وتنظيف البيانات ومعالجتها مسبقًا وإجراء بعض التحليلات الأولية.
- التواصل: يحتاج علماء البيانات إلى التحلي بالبراعة في التواصل، لأن شرح نتائج التحليل قد يكون صعبًا، ويجب أن تمارس مهارات الاتصال المكتوبة والشفوية.

