
شرح الموضوع
ب { تخطيط حل الذكاء الاصطناعي وإعداده لتلبية احتياجات محددة
- يستكشف هذا الموضوع تخطيط أحد حلول الذكاء الاصطناعي، ويتناول كيفية التعرف على البيانات اللازمة لدعم الحل وكيفية جمعها وإعدادها.
ب1 بيانات الذكاء الاصطناعي
بيانات الذكاء الاصطناعي: من أين نبدأ؟
- المفاهيم الأساسية: الطريقة التي يتم بها تنظيم البيانات (أو عدم تنظيمها في الواقع)، وأنواع البيانات المختلفة.
- الهدف: تحديد مصادر البيانات المناسبة لمشاريع الذكاء الاصطناعي وكيف يجب إعداد البيانات للاستخدام.
- نوع البيانات: يؤثر في طريقة التعامل معها والحفاظ عليها وفحصها.
- الأنواع الأربعة الرئيسة: منظمة، شبه منظمة، غير منظمة، السلاسل الزمنية.
أنواع مختلفة من البيانات
ما الأنواع الأربعة الرئيسة من البيانات؟
البيانات المنظمة
البيانات المنظمة وغير المنظمة
- البيانات المنظمة: منظمة بشكل جيد، وعناصرها عادة بتنسيق جدولي (باستخدام الصفوف والأعمدة).
- نوع البيانات: يحتوي كل عنصر على نوع محدد (عدد صحيح، رقم عشري، سلسلة)، ما يسهل البحث والمعالجة.
- أين تخزن: في جدول وقاعدة بيانات وملف CSV وسجل.
- الاستعلام: يمكن الاستعلام عنها، لكن مع كثرة نقاط البيانات يستحيل تقريبًا إدارتها بفعالية.
- دور التعلم الآلي: يوفر الأدوات الخوارزمية والإحصائية وموارد المعالجة للتعامل مع الحجم الهائل، ويجد الارتباطات الظاهرة والمخفية.
البيانات غير المنظمة
- البيانات غير المنظمة: ليست مهيكلة، مثل النص الخام والصور ومقاطع الفيديو والصوت والرسائل الفورية ومحتوى صفحة الويب.
- أمثلة: منشورات وسائل التواصل الاجتماعي، وملاحظات مكالمات العملاء، وفيديوهات كاميرات المراقبة (CCTV)، ومنشورات منتديات الدعم.
- يصعب للغاية معالجة البيانات غير المنظمة يدويا: افتقارها إلى هيكل محدد يجعل من الصعب البحث فيها دون استخدام أدوات متخصصة.
- أدوات الذكاء الاصطناعي: تميز الأشكال في الصور والفيديو، وتحلل المشاعر على وسائل التواصل، وتنفذ معالجة اللغة الطبيعية (NLP).
- الدقة: يمكن أن تختلف، فبعض منظمات إنفاذ القانون في المملكة المتحدة أصدرت إشعارات بحث عن أفراد أبرياء بسبب أنظمة غير دقيقة لتمييز الوجوه.
البيانات شبه المنظمة
شبه المنظمة والسلاسل الزمنية
- البيانات شبه المنظمة: مزيج من البيانات المنظمة وغير المنظمة، تنشأ لتحقيق التوازن بين سهولة القراءة البشرية والمعالجة الآلية.
- البريد الإلكتروني: شبه منظم لأن التنسيق موثق ومنفصل، لكن محتوى الجسم غالبًا غير منظم.
- JSON وXML: أمثلة أخرى، توفر تبادلًا فعالًا للبيانات بين الخوادم والعملاء باستخدام طلبات واستجابات واجهة برمجة التطبيقات (API).
بيانات السلاسل الزمنية
- بيانات السلاسل الزمنية: البيانات التي تُجمع في نقاط زمنية محددة أو تُسجل على فترات زمنية متتالية.
- ترتبط: بالمراقبة والتتبع، مثل تسجيل درجات الحرارة والإقبال على المتجر والضغط والرطوبة والأمطار وزوار الموقع.
- الطابع الزمني: يحتوي على بيانات التاريخ والوقت فيجعل كل بند فريدًا، وتحتاج قواعد بيانات فعالة لتكرار المدخلات.
لماذا قد تستخدم المؤسسات هذه الأنواع المختلفة من البيانات؟
لماذا تختلف أنواع البيانات؟
- الاستخدام كما هي: قد تتوافر البيانات بتنسيق واحد فقط، فتستخدمه المؤسسة بهذا النموذج.
- الاحتياجات: يعكس نوع بيانات المصدر احتياجات المعالجة، فالوصول السريع للسجلات المالية أو المخزون أو التوظيف يتطلب بيانات منظمة.
- البيانات غير المنظمة: عند تحليلها بالذكاء الاصطناعي قد تكون أكثر فائدة من المنظمة، كتحليل الفحوصات الطبية لتحسين التشخيص السريري.
- بيانات السلاسل الزمنية: أمر بالغ الأهمية لتحليل الاتجاهات، وهي لازمة للأشخاص والمنظمات العاملين في مجال التنبؤات، مثل خبراء الأرصاد الجوية.
المصادر الشائعة للبيانات
مصادر البيانات: الويب
- المصادر: تُنشأ كميات هائلة من البيانات يوميًا من تفاعلات الأشخاص مع التكنولوجيا ومن معالجة المعاملات.
- الويب: يمكن استخراج البيانات من المواقع العامة وصفحات التواصل ولوحات الرسائل بتقنية (مسح الويب).
- الاستخدامات: أبحاث السوق، ومراقبة الأسعار، وتوليد العملاء المحتملين، وجمع البيانات لنماذج التعلم الآلي.
- التحليل (parse): وصف عملية استخراج البيانات المنظمة من البيانات غير المنظمة أو شبه المنظمة، كلغة HTML لصفحة الويب.
- حدّد الهدف: عيّن الموقع المستهدف والبيانات التي تحتاج إليها.
- افحص البنية: تحقق كيف نُظمت البيانات في الموقع.
- اجلب الصفحات: اكتب كودًا يجلب صفحات الويب عبر الطلبات.
- حلّل المحتوى: استخرج البيانات المطلوبة من الناتج.
- خزّن البيانات: احفظها بتنسيق منظم ثم استخدمها في المشروع.
مقدمة إلى الذكاء الاصطناعي (AI) الوحدة 21
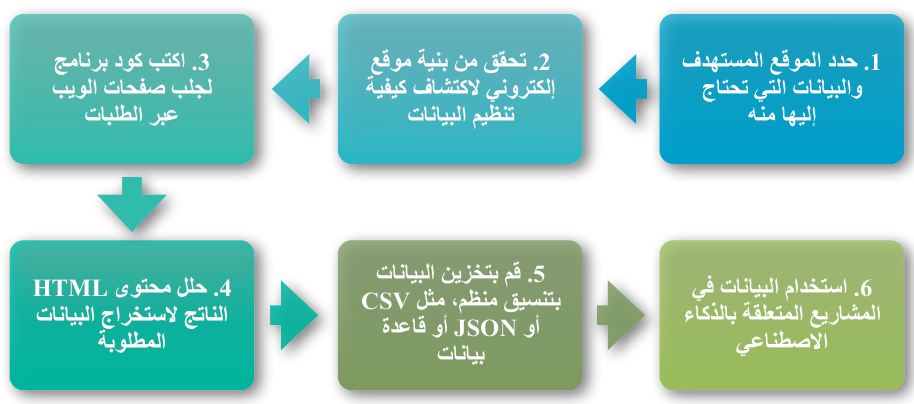
- الخطوات الأساسية: حدد الموقع المستهدف، تحقق من بنية موقع إلكتروني، اكتب كود برنامج لجلب صفحات الويب، حلل محتوى HTML، قم بتخزين البيانات بتنسيق منظم.
- الحذر: قد يُعد هذا النشاط انتهاكًا لشروط خدمة الموقع، فيجب دائمًا التحقق من أن استخراج البيانات مسموح به.
- المنتديات ولوحات الرسائل: تمثل مصدرا غنيا جدا للبيانات نظرا إلى تحديثها باستمرار بمحتوى مستخدم جديد.
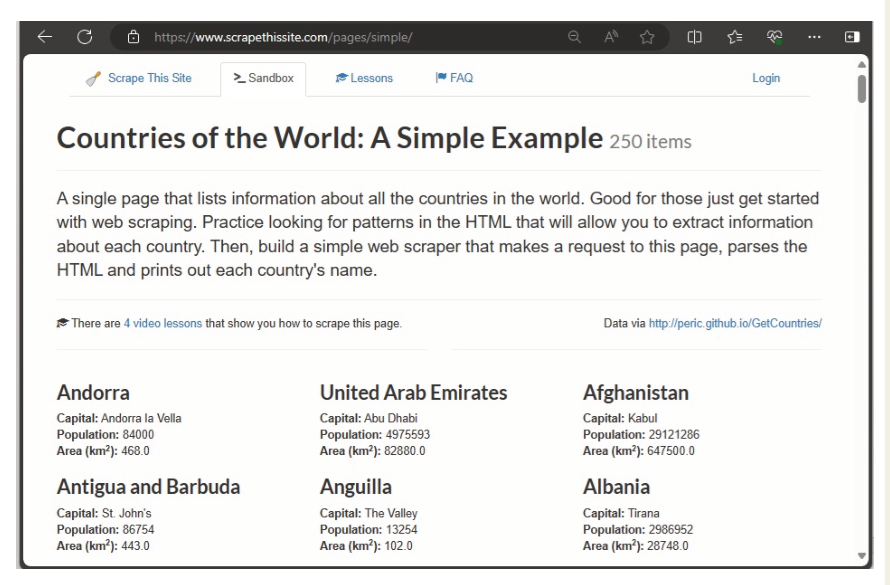
مثال عملي
مثال عملي: استخراج بيانات الدول
- المثال العملي: كود بايثون نموذجي يستخرج بيانات من موقع مصمم للمتعلمين.
- HTML الأساسي: مقتطف لبلد واحد هو جنوب أفريقيا.
مقدمة إلى الذكاء الاصطناعي (AI) الوحدة 21
- كود بايثون: يجمع البيانات من الموقع فيستخرج البيانات الرئيسة ويخزنها.
مقدمة إلى الذكاء الاصطناعي (AI) الوحدة 21
- الناتج: بعض البيانات المستخرجة بتنسيق JSON من الملف الذي تم إنشاؤه.
- النتيجة: أصبحت البيانات نظيفة وخالية من أي محتوى متعلق بـ HTML، فهي مناسبة للإدخال في أي عملية تعلم آلي.
- سلسلة وكيل المستخدم: بعض المواقع لا تسمح بالطلبات البرمجية، وهذه القيمة تحدد لخادم الويب اسم أداة البرنامج التي تقدم الطلب.
- التزييف: من الممكن انتحال سلسلة وكيل المستخدم ليقلد برنامجك عميل متصفح ويب أصلي.
- واجهات برمجة التطبيقات العامة (API): قد توفرها مواقع أخرى للاستعلام عن مصادر البيانات الأساسية، وقد تكون مجانية أو تتطلب مفتاحًا قابلًا للشراء.
مقدمة إلى الذكاء الاصطناعي (AI) الوحدة 21
واجهات البيانات العامة ورموز الحالة
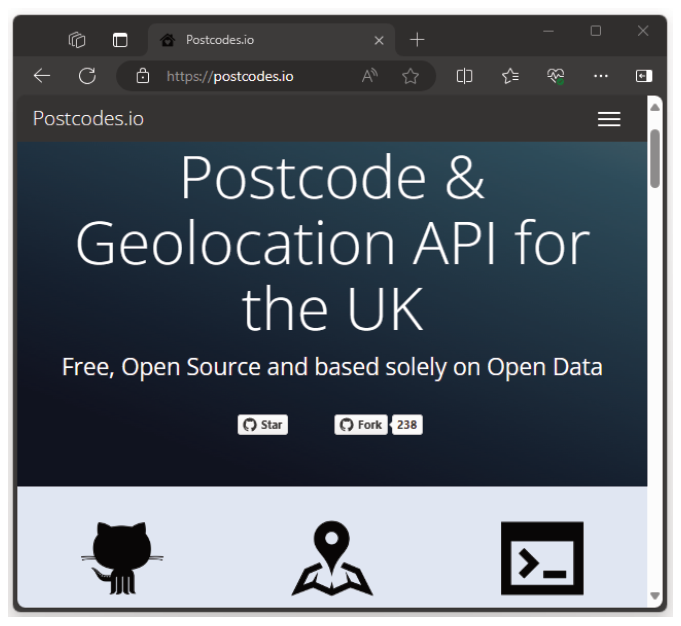
- Postcodes.io: مشروع نشأ ببرنامج مفتوح المصدر بواسطة Ideal Postcodes، يقدم خدمة مجانية للمطورين للبحث عن بيانات الرموز البريدية في المملكة المتحدة.
- مجموعات مماثلة: postcode.eu لبلدان الاتحاد الأوروبي، وgetpostalcodes.com الذي فيه بيانات 12 منطقة بريدية في الأردن بما فيها عمان.
- مفتاح النجاح: الجهود التعاونية من مجتمع المبرمجين لتحسين المشروع وإصلاح الأخطاء وإضافة وظائف جديدة عند الطلب.
- نقاط النهاية: يوفر Postcodes.io عددًا منها للتحقق من بياناته، كالتحقق من وجود الرمز البريدي ومكانه.
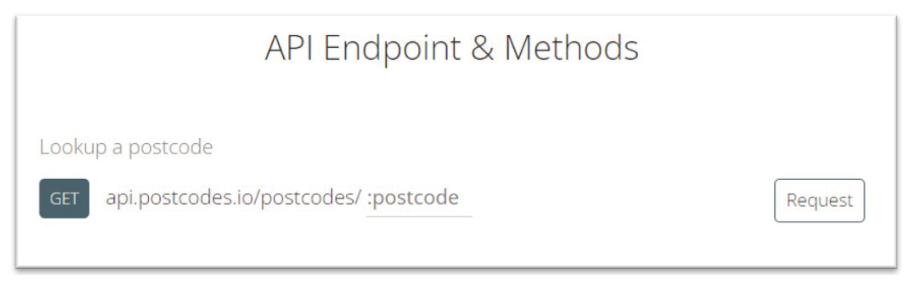
- الوصول: عبر نقطة النهاية بطلب HTTP GET من متصفح الويب أو بأداة سحب بيانات مخصصة بلغة بايثون.
مقدمة إلى الذكاء الاصطناعي (AI) الوحدة 21
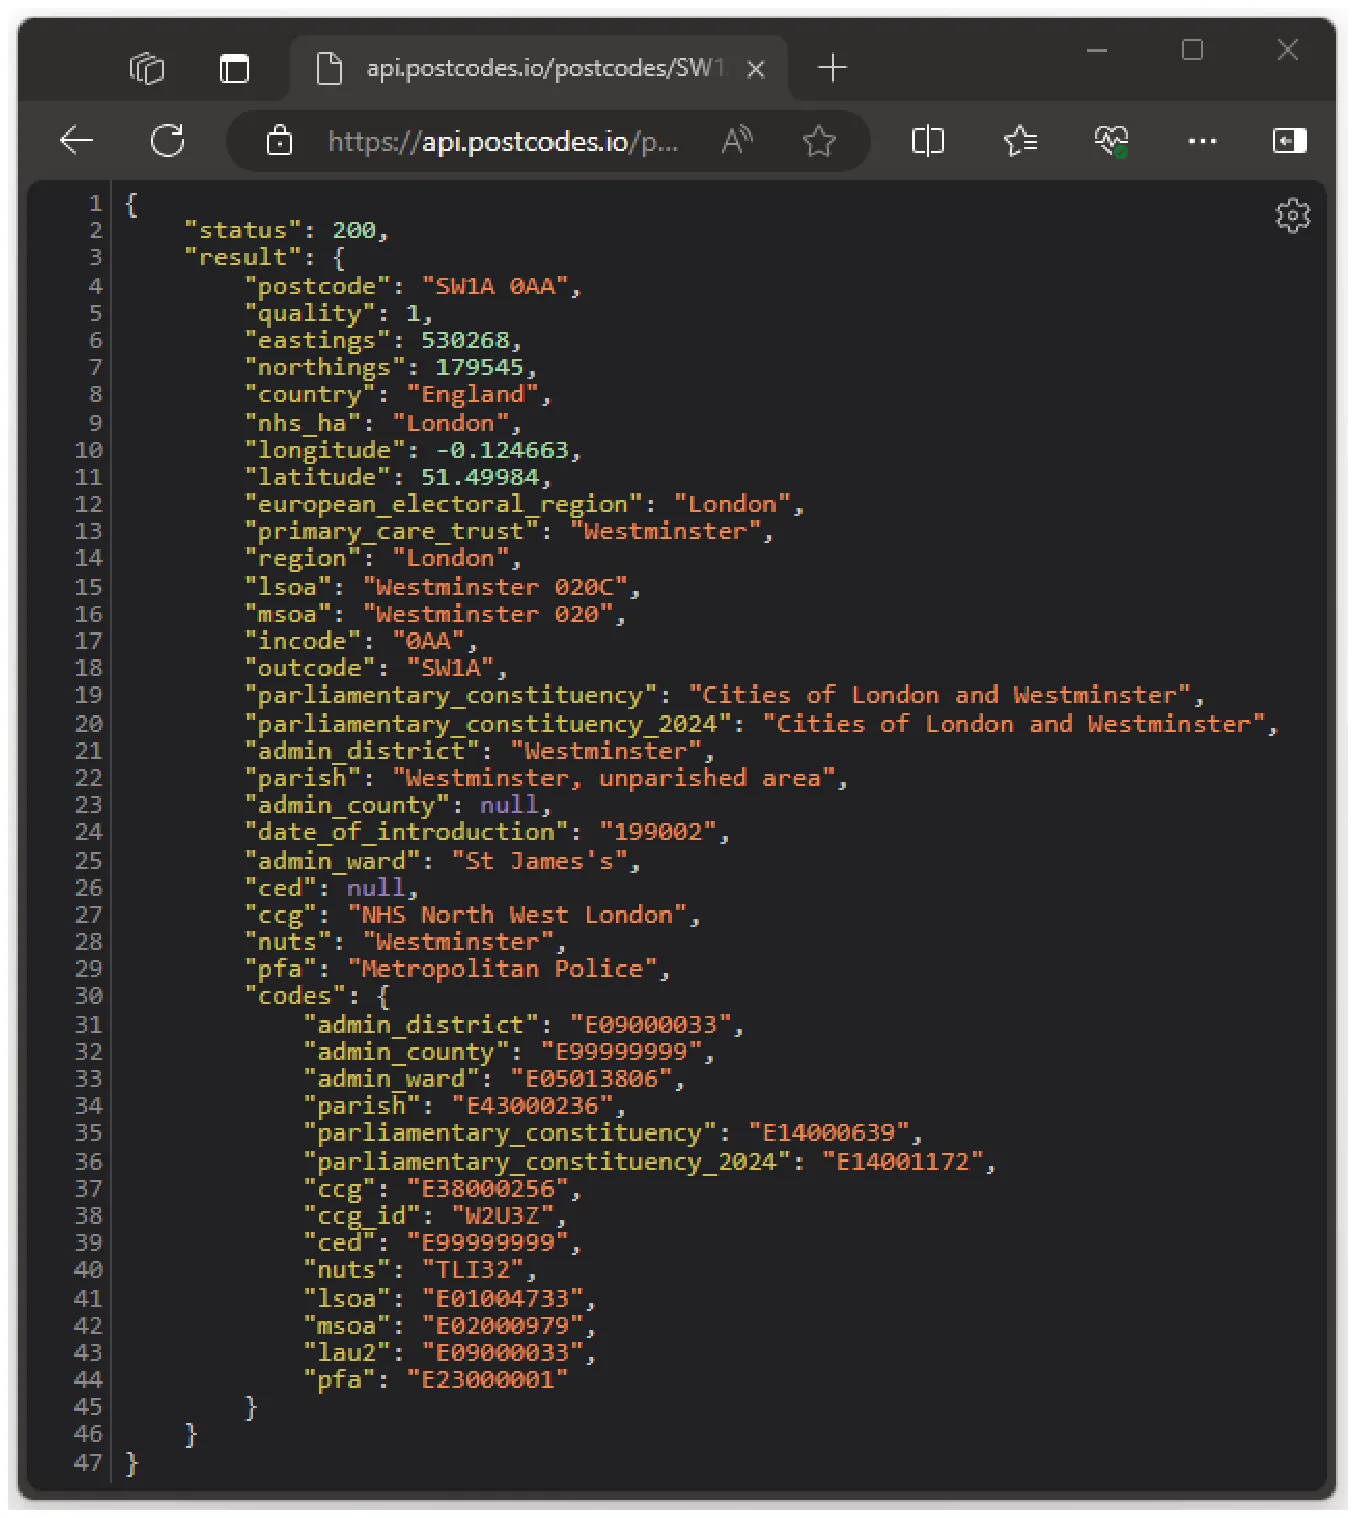
- سلسلة وكيل المستخدم المخادع: استُخدمت لتوضيح كيفية تنفيذ ذلك، لكن Postcodes.io لا تواجه مشكلة في الرد على الاستعلامات البرمجية.
مقدمة إلى الذكاء الاصطناعي (AI) الوحدة 21
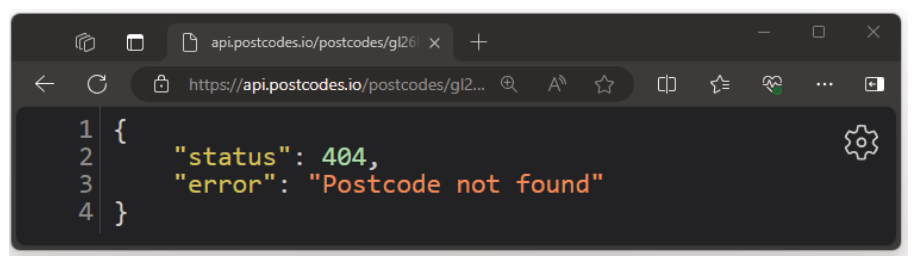
- رموز حالة HTTP: يشيع استخدامها للإشارة إلى الطلبات السيئة أو الرموز البريدية غير الموجودة.
وسائل التواصل الاجتماعي
وسائل التواصل ونقاط البيع
- وسائل التواصل الاجتماعي: أدى اعتمادها الواسع إلى زيادة مذهلة في البيانات المولدة.
- ما تتضمنه: الرسائل والصور المحملة وجميع البيانات الوصفية المرتبطة بها (التاريخ والوقت والموقع الجغرافي وإبداء الإعجاب والردود وإعادة التوجيه).
- استخدام المؤسسات: في خوارزميات التوصية، ولإنتاج إعلانات مستهدفة، وتُباع لأطراف ثالثة بحسب شروط وأحكام الاستخدام.
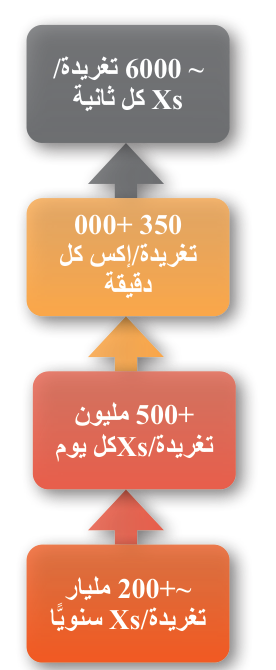
- حجم البيانات: هذا يظهر ما يمكن لمستخدمي منصة X إنتاجه خلال مدة زمنية محددة، فـ 200 مليار تغريدة كمية هائلة من البيانات الجديدة.
نقطة البيع
- نقطة البيع (PoS): تُجمع كمية هائلة من البيانات من أنظمتها في متاجر التجزئة، وفيها المعلومات اللازمة لمعالجة مشتريات كل عميل.
- أنظمة مراقبة المخزون: يسمح لأنظمة التحكم بالحفاظ على مستويات المخزون ثابتة عن طريق طلب المخزون ليحل محل البنود التي تم بيعها.
- البيانات الحساسة: لا يمكن الاحتفاظ بجميعها بعد المعاملة، وبعضها (رقم البطاقة ورمز التحقق) يخضع لمعايير أمان صارمة مثل PCI DSS.
- بطاقات الولاء: تزود العميل بتجربة تسوق محسنة، بما في ذلك خصومات نقدية، الوصول إلى العروض الخاصة داخل المتجر، عروض تسويقية مصممة خصيصا.
- تتبع العادات: يقدم العملاء معلومات شخصية عند إنشاء الحساب، فيمكن تتبع سلوكيات وعادات التسوق على المدى القصير والطويل.
- التحليل: بخوارزميات التعلم الآلي لفهم عادات الشراء وتفضيلاتها والتنبؤ بمبيعات المنتجات في أوقات وأماكن مختلفة.
- الهدف: تحقيق الأرباح وجذب عملاء جدد والحفاظ على ولاء العملاء الحاليين.
بيانات معاملة نقطة البيع في أربع فئات.
مقدمة إلى الذكاء الاصطناعي (AI) الوحدة 21
| بيانات حامل البطاقة | بيانات المعاملة |
|---|---|
| رقم البطاقة • اسم حامل البطاقة • تاريخ انتهاء الصلاحية | معرف فريد تم إنشاؤه بواسطة نظام نقاط البيع • التاريخ • الوقت • المبلغ • العملة • اسم بائع التجزئة • رمز فئة التجزئة (على سبيل المثال، نوع النشاط التجاري) |
| بيانات الأمان | التفويض |
| قيمة التحقق من البطاقة (CVV/CVC) • بيانات شريحة EMV (يوروباي وماستر كارد وفيزا) • بيانات الشريط المغناطيسي | رمز التفويض • رمز الاستجابة (على سبيل المثال، موافق عليه، مرفوض) |
بيانات حساب بطاقة الولاء في أربع فئات.
مقدمة إلى الذكاء الاصطناعي (AI) الوحدة 21
| تفاصيل العميل الشخصية | بيانات المعاملة |
|---|---|
| الاسم • قنوات الاتصال • العنوان • رقم الهاتف • البريد الإلكتروني • رسالة نصية قصيرة • تفضيلات الاتصال • تاريخ الميلاد • معلومات الأسرة (الحجم، الأعضاء، وما إلى ذلك) | تاريخ الشراء • تكرار التسوق • حجم السلة • عدد العناصر • التكلفة الإجمالية • طريقة الدفع • بطاقة (خصم أو ائتمان) • نقد • استرداد القسيمة |
| البيانات السلوكية وتفضيلات المستخدم | بيانات المكافآت |
| تاريخ استخدام القسيمة • التسوق عبر الإنترنت • الردود على الترقيات • البريد الإلكتروني • الموقع الإلكتروني • رسائل البريد • تفضيلات المنتج (على سبيل المثال، الولاء للعلامة التجارية) • تفضيل الخدمة • خدمة التوصيل إلى المنزل • انقر واستلم • التسوق داخل المتجر • ملاحظات العملاء | نقاط الولاء التي تم الحصول عليها • نقاط الولاء التي تم استردادها |
أنظمة التجارة الإلكترونية
التجارة الإلكترونية: أربعة أنواع
- التجارة الإلكترونية: شراء وبيع المنتجات أو الخدمات عبر الإنترنت، تكمل المتاجر الفعلية أو تحل محلها.
- بيانات المعاملات: تقوم جميع أنظمة التجارة الإلكترونية بجمع ومعالجة بيانات المعاملات، ويتم إنشاء كميات هائلة من البيانات في مراحل مختلفة.
- التخطيط الإستراتيجي: تُستخدم بيانات المعاملات لقرارات المنتجات والخدمات الجديدة وتحديد ما اقترب عمره من النهاية.
- التخطيط التشغيلي: إيجاد طرق جديدة للسوق وقنوات اتصال وتوسيع نطاق الأعمال.
- التخطيط اليومي: إدارة الأفراد والفرق ونقل الموظفين للتغطية، وإدارة النقل بحسب الطقس، وإيجاد أسرع الطرق.
B2C (المبيعات بين الشركات والمستهلكين)
- B2C: يوفر فوائد، فمتاجر كثيرة لا تفتح 24 ساعة، وتتيح التجارة الإلكترونية طلب التسليم عبر الإنترنت ورؤية على مدار الساعة.
- B2B: تستخدم العديد من منافذ البيع بالتجزئة التجارة الإلكترونية للتعامل مباشرة مع الشركات المصنعة وتجار الجملة.
- C2C: يُستخدم لدى المستهلكين لتبادل السلع والخدمات أو بيعها، ويرى الكثير من الناس أن هذا النوع من إعادة الاستخدام أخلاقي للغاية.
- المبيعات بين المستهلكين والشركات: شكل أقل شيوعًا يشمل الأفراد، مثل الفنانين والمصورين والمؤثرين، الذين يبيعون السلع أو الخدمات للشركات.
- المنصات: تتطلب منصات تجارة إلكترونية قوية وآمنة بخدمات كالبحث وسلال التسوق وعمليات الدفع الآمنة.
أجهزة إنترنت الأشياء (IoT)
إنترنت الأشياء كمصدر للبيانات
- الأجهزة: غالبًا تحتوي على أجهزة استشعار لالتقاط البيانات، وبرامج متخصصة لتوصيل وتبادل البيانات مع أنظمة أخرى.
- التنوع: تختلف أجهزة إنترنت الأشياء في الحجم والتعقيد، من الآلات الصناعية إلى التكنولوجيا الشخصية القابلة للارتداء.
- الذكاء الاصطناعي/التعلم الآلي: تجمع البيانات بطريقة تسمح بتحليلها لتحسين الأداء وتعزيز الكفاءة، مع مخاوف الخصوصية والأمان.
- نظام أمان ذكي: كل تفاعل مع النظام سيؤدي عادةً إلى توليد المعلومات الآتية: ضبط جهاز تنبيه التاريخ والوقت، وإلغاء ضبطه.
- الساعة الذكية: تلتقط بيانات عن التمرين الذي تم إجراؤه على مدار اليوم، ويتم تسجيل وقت التمرين، بالإضافة إلى السعرات الحرارية المحروقة.
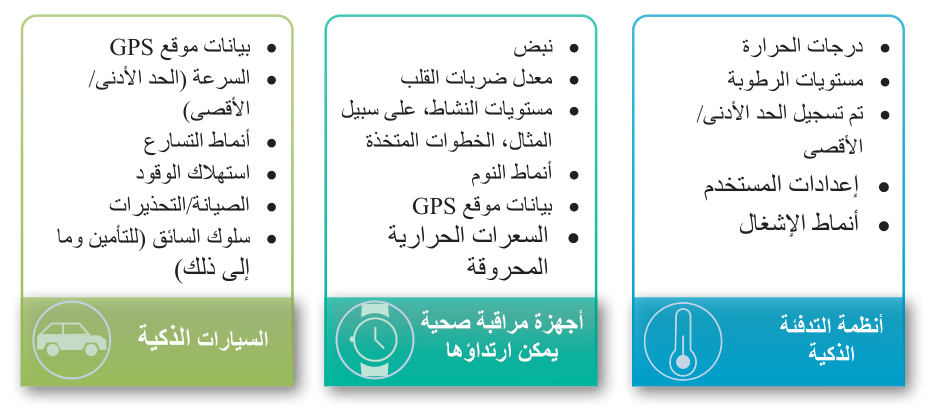
- أنظمة التدفئة الذكية: درجات الحرارة، ومستويات الرطوبة، والحد الأدنى/الأقصى، وإعدادات المستخدم، وأنماط الإشغال.
- أجهزة مراقبة صحية يمكن ارتداؤها: نبض، ومعدل ضربات القلب، ومستويات النشاط، وأنماط النوم، وموقع GPS، والسعرات المحروقة.
- السيارات الذكية: بيانات موقع GPS، السرعة (الحد الأدنى/الأقصى)، أنماط التسارع، استهلاك الوقود، الصيانة/التحذيرات، سلوك السائق.
المساعدون الأذكياء
- المساعد الذكي: مثال شائع على إنترنت الأشياء، مثل سيري من أبل وأليكسا وإيكو من أمازون وجوجل نيست.
- طريقة العمل: تستخدم الذكاء الاصطناعي لتمييز الكلام المعتمد على السحابة وتحويل الأوامر الصوتية إلى نص، ثم ينفذ الجهاز الأمر.
- ما تسجله: موقع المستخدم ووقت التفاعل وتاريخه والسؤال المطروح والاستجابة ومقدار الوقت المستغرق، وهل ردت الإجابة بشكل صحيح.
- حلقة التغذية الراجعة: استخدام هذه المعلومات لتحسين استجابات الخدمة للمستخدمين الآخرين.
- أنظمة التدفئة الذكية: أجهزة استشعار درجة الحرارة والرطوبة تجمع البيانات في الوقت الفعلي، وبعضها يكتشف أنماط الإشغال.
- الأجهزة الأكثر تقدما: يمكنها استخدام الذكاء الاصطناعي لتوقع الأوقات التي سيتم استخدام الغرف، وتحديد أفضل إعدادات درجة الحرارة والرطوبة، وهذا يساعد على تقليل استخدام الوقود.
- أجهزة مراقبة الصحة القابلة للارتداء: يستخدمها الأفراد لمراقبة صحتهم، ويستخدمها الأطباء لعلاج الحالات الصحية ودعمها عن بُعد.
- مرض السكري: يرسل الجهاز البيانات إلى جهاز الشخص وينصحه بالتصرف قبل حدوث نقص أو ارتفاع السكر في الدم.
الذكاء الاصطناعي في السيارات
- الذكاء الاصطناعي في السيارات: تسمح بيانات الموقع الجغرافي للشركات برؤية تقدم العناصر المسلمة براً وبحراً وجواً، ويراه العميل في تطبيق.
- تطبيقات السفر: تعيد توجيه الرحلة تلقائيًا عند حادث أو عائق وتعيد حساب وقت الوصول، اعتمادًا على بلاغات المستخدمين.
- سلوك القيادة: يمكن لأنظمة الذكاء الاصطناعي/التعلم الآلي التقاط معلومات حول سرعة القيادة وأنماط التسارع والفرملة لتحليله، لتقديم أسعار تأمين مخفضة.
- الوقود والصيانة: تستخدم الشركات بيانات الوقود للتنبؤ بالتكاليف، وتحذيرات الصيانة لإصلاح السيارة قبل أن تتعطل.
مصادر بيانات الشركات
بيانات الشركات وتخزينها
- مصادر الشركات: واسعة ومتنوعة، لدعم العمليات اليومية ومساعدتها على اتخاذ قرارات إستراتيجية فعالة.
- مصادر البيانات الداخلية الشائعة: السجلات المالية، بيانات الموارد البشرية، بيانات المبيعات والتسويق، بيانات العملاء، البيانات التشغيلية.
- البيانات التشغيلية: المخزون، وسلسلة التوريد (النظام الذي يحول المواد إلى منتجات ويسلمها)، والخدمات اللوجستية (إدارة سلسلة التوريد).
- التخزين: بعض المؤسسات تخزن بياناتها في مقراتها، وكثير غيرها نقلها إلى التخزين السحابي من أمازون أو جوجل أو مايكروسوفت، أو مراكز بيانات العلامة البيضاء.
- الميزة الرئيسة لتخزين السحابة: أن البيانات المخزنة تُنسخ احتياطيًا عبر عدد من الآلات الافتراضية، ما يعني تقليل فرصة فقدان البيانات.
- اختيار التخزين: يشمل المهارات التقنية الداخلية، وتكاليف التخزين، والتوافر، والتشريعات المحلية، والمخاوف الأمنية.
- حجم مجموعة البيانات: كلما زاد زادت سعة التخزين المطلوبة، ويجب أن تكون الأنظمة آمنة وقابلة للتطوير دون تعطل أو تراجع في الأداء.
- التكلفة: يمكن أن تكون تكاليف تخزين البيانات لمجموعات البيانات الكبيرة مكلفة للغاية، ويقدم العديد من موفري الخدمات السحابية معدلات تخزين أقل تكلفة للبيانات التي يجب الوصول إليها بشكل أقل تكرارا.
استخدام البيانات الضخمة في حلول الذكاء الاصطناعي
- البيانات الضخمة: تؤدي دورًا مهمًا في تطوير أنظمة الذكاء الاصطناعي وفعاليتها، فهي الوقود الذي يشغل آلة الذكاء الاصطناعي.
- التدريب: يُستخدم الحجم الكبير من البيانات المصنفة وغير المصنفة لتدريب نماذج التعلم الآلي باختيار الميزات ذات الصلة من البيانات الخام.
- التحقق: تمكن الكميات الهائلة علماء البيانات من التحقق من صحة نماذجهم وتقييمها، فتعمم جيدًا على بيانات لم تطلع عليها.
- التحدي: لا يكمن في تخزينها وتنظيمها فحسب بل في فهمها وتفسيرها بشكل فعال.
- المتقابلات الخمسة: المعايير المستخدمة لوصف الخصائص والتحديات الرئيسة للبيانات الضخمة، وأولها أربعة أساسية لتحقيق الخامس: قيمتها الإجمالية.
المتقابلات الخمسة للبيانات الضخمة
البيانات الضخمة والمتقابلات الخمسة
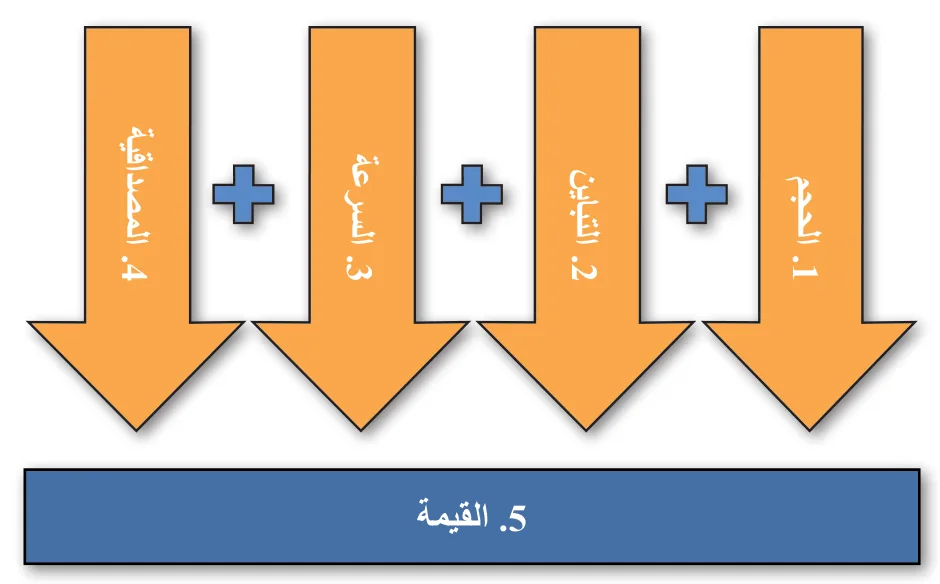
ما المتقابلات الخمسة للبيانات الضخمة؟
الحجم
- الحجم: الكمية الهائلة من البيانات المنشأة والمخزنة، من تيرابايت إلى زيتابايت، فتوفر مجموعة أشمل لتدريب التعلم الآلي ودقة أفضل.
- التباين: يشير إلى الأنواع المختلفة من تنسيقات البيانات ومصادرها، بما في ذلك البيانات المنظمة وشبه المنظمة وغير المنظمة.
- السرعة: السرعة التي تُنشأ بها البيانات وتُتناول وتُعالج، وتجعل أنظمة الذكاء الاصطناعي أكثر استجابة وتوقعاتها أدق.
- المصداقية: قياس جودة ودقة وموثوقية البيانات المتناولة، فجودة المخرجات انعكاس لجودة المدخلات.
- البيانات ذات الجودة السيئة: ستنتشر وتتضخم عن طريق نظام الذكاء الاصطناعي، ما يؤدي حتما إلى نتائج معيبة وغير دقيقة.
- القيمة: تحدد تقلبات البيانات وصحتها وحجمها هل هي ذات مغزى وجديرة بالتحليل، وهي معيار حاسم لأن بناء أنظمة الذكاء الاصطناعي مكلف.
- العائد على الاستثمار: تحسين الكفاءة والإنتاجية، تحسين صنع القرار، تجربة محسنة للعملاء، منتجات وخدمات جديدة ومبتكرة، انخفاض المخاطر والتكلفة.
البيانات النوعية مقارنة بالبيانات الكمية
الكمي والنوعي: أي بيانات أفضل؟
- شكلان: تأتي البيانات عادةً في شكلين: نوعي أو كمي.
مقارنة البيانات النوعية بالكمية.
| البيانات النوعية | البيانات الكمية |
|---|---|
| تصف الصفات أو الخصائص | رقمي، على سبيل المثال، الكميات، المبالغ، الدرجات، النطاقات، وما إلى ذلك. |
| غير رقمي | تم جمعها عبر مجموعات البيانات المنظمة والأسئلة المغلقة |
| تركز بقوة على 'لماذا؟' و'كيف؟' | تصنيفات على نمط ليكرت، مثل '3 من 4' |
| تم جمعها من خلال الملاحظات والمقابلات والأسئلة المفتوحة واستطلاعات العملاء، وما إلى ذلك. | سهل القياس والتحليل الإحصائي |
- كلا النوعين: يمثل قيمة كبيرة في البحوث واتخاذ القرارات، وغالبًا يكمل بعضهما بعضًا لتوفير فهم أكثر شمولًا.
- السؤال النوعي والكمي: يؤثر اختيار الأسئلة تأثيرًا كبيرًا في مشروع الذكاء الاصطناعي بسبب البيانات الناتجة عنها.
- الأفضل: لكل نوع نقاط القوة والضعف، لكن المشاريع الأكثر موثوقية تتضمن مزيجًا متزنًا من الاثنين.
- البيانات الكمية: أكثر تنظيمًا، مثالية لمعظم خوارزميات التعلم الآلي (الانحدار والتصنيف)، وتعمل معها الأساليب الإحصائية التقليدية.
- على الجانب السلبي: قد تُفقد الفروق الدقيقة بنظام تسجيل بسيط، وقد تتضمن الأسئلة تحيزًا بحسب صياغتها.
- البيانات النوعية: توفر معلومات أكثر تفصيلًا عن الإعجاب والمشاعر والدوافع والأسباب الكامنة، وتشرح سياق النتائج الكمية.
- على الجانب السلبي: غير منظمة وقائمة على النصوص، وتتطلب معالجة أكثر تعقيدًا، وقد تؤدي إلى مخرجات أكثر تعقيدًا تحتاج معرفة بالمجال.
البيانات النوعية
التحليلات الوصفية
أنواع التحليلات: وصفي وتشخيصي وتنبؤي
- التحليلات الوصفية: تحليل البيانات التاريخية لفهم ما حدث سابقًا، فتوفر رؤى حول الأنماط والاتجاهات.
- تطبيق واقعي: منظمة تجزئة تفحص مبيعات الـ 12 شهرًا الماضية لتحديد كيف ولماذا ومتى صار منتجها الأكثر شعبية.
- حدودها: لن يستكشف عادة الآثار المستقبلية.
- التحليلات التشخيصية: عملية تحاول فهم لماذا وقعت أحداث أو سلوكيات معينة، فتحسن تنبؤات الذكاء الاصطناعي.
- تطبيق واقعي: مؤسسة تزود حافلاتها بأجهزة استشعار تراقب ضغط الإطارات والبطارية والكبح والسرعة وأداء المحرك.
- النتيجة: تحديد الأنماط أو الحالات الشاذة والتنبؤ بفشل مكون قبل أن يحدث، فتُجدول صيانة استباقية.
- التحليلات التنبؤية: استخدام التقنيات الإحصائية ونماذج التعلم الآلي للتنبؤ بالأحداث المستقبلية بناءً على البيانات التاريخية.
- مثال: شركة تأمين تحدد ملف المخاطر لعميل محتمل لتحديد علاوة واقعية.
ما عملية تحليل البيانات التاريخية لفهم ما حدث سابقًا؟
الاستخراج والتحويل والتحميل (ETL)
- الاستخراج والتحويل والتحميل: معالجة هندسية للبيانات تتكون من ثلاث مراحل أساسية.
- المراحل الثلاث: استخراج البيانات من عدد من المصادر المختلفة، تعيين البيانات الأصلية إلى مجموعة جديدة بتنسيق ثابت، تحميل مجموعة البيانات الجديدة إلى موقع قابل للمشاركة، عادةً على السحابة.
- ELT: عكس مرحلتي التحويل والتحميل بفضل أدوات التحويل على السحابة وتخزينها الأقل تكلفة، وأصبح الخيار المفضل.
التحليلات الوصفية
- التحليلات الوصفية الإرشادية: اقتراح الإجراءات التي تجعل نتائج معينة أكثر احتمالًا أو تقلل فرصة حدوث بعض المخاطر.
- تطبيق واقعي: تجار التجزئة الكبار يوازنون مستويات الأسهم عبر شبكات البيع ويتجنبون المخزون الزائد.
- الأنظمة: تحلل مستويات المخزون وأوقات الشحن وتوقعات الطلب، فتقلل الهدر وفرص المبيعات المفقودة وتزيد الأرباح.
- تمثيل البيانات: عملية تقديم البيانات في شكل رسومي (مثل الرسوم البيانية والرسوم التوضيحية) التي تساعد على توصيل المعلومات بطريقة أكثر قابلية للفهم.
ب2 جمع البيانات وتجهيزها
جمع البيانات وتجهيزها: خمس نقاط
- جمع البيانات وإعدادها: من أهم العوامل أن البيانات قد لا تكون بتنسيق مناسب أو منظمة كما هو مطلوب، فيلزم عمل إضافي.
- الاعتبارات: يغطي الموضوع الاعتبارات الأخلاقية والتشريعية والأمنية التي يجب مراعاتها.
- أسباب الفشل: أحد الأسباب الأساسية لفشل مشاريع الذكاء الاصطناعي سوء اختيار البيانات وجمعها.
- افهم المتطلبات: تأكد من صلة البيانات وحدد أنواعها وتنسيقاتها ومعدل جمعها.
- تأكد من الدقة: تحقق من سلامة البيانات وجودتها ومصدرها القانوني.
- نوّع البيانات: احرص على تنوع مناسب لتقليل التحيز غير المقصود.
- طهّر البيانات: عالج القيم المفقودة والشاذة والعشوائية وحوّلها للنموذج.
- اتبع الأخلاقيات: أخفِ الهوية الشخصية واحترم قوانين الخصوصية.
- فهم المتطلبات بشكل كامل: تأكد من أن البيانات ذات صلة وتفي بمتطلبات المشروع، وحدد أنواعها وتنسيقاتها ومعدل تكرار جمعها.
- سلامة البيانات: تأكد من أن مصدر بياناتك قانوني وآمن، وعقد البيانات طريقة جيدة لضمان ذلك وتسجيله.
- جودة البيانات: تحقق من عدم الاتساق والبيانات المكررة والبيانات المفقودة والأخطاء.
- التحيز غير المقصود: تأكد من أن البيانات فيها القدر والفئة المناسبة من التنوع (الديموغرافي والجغرافي).
- تطهير البيانات: تطهير القيم المفقودة والقيم الشاذة والبيانات العشوائية غير الضرورية، وتحويلها لتكون جاهزة لنموذج التعلم الآلي.
- الأخلاقيات والقانون: إخفاء هوية معلومات التعريف الشخصية (PII) حيثما أمكن، واحترام قوانين حماية البيانات والخصوصية المحلية.
اختيار البيانات ومصادر البيانات المناسبة
اختيار البيانات ومصادرها
- نظام الذكاء الاصطناعي: جزء من سلسلة التوريد الكاملة، يستخدم البيانات ويوفر نتائج تساعد المستخدمين على قرارات مستنيرة.
- تحديد الأهداف: يساعد على تحديد نوع البيانات المطلوبة، فالأهداف المختلفة تتطلب بيانات مختلفة.
- مثال: النموذج المطلوب لإجراء التنبؤات الجوية سيحتاج إلى بيانات الطقس السابقة، وللتنبؤ بالسرقات ستحتاج إلى سجلات حوادث الشرطة.
- مراجعة البيانات المتاحة: قد تملك المؤسسة بالفعل حق الوصول إلى ما تحتاج، فلا داعي لجمعه منفصلًا ويوفر الوقت والمال.
- إذا لم تكن البيانات متاحة داخل الشركة: فيجب الحصول عليها، وقد يكون من الضروري إنشاء أنظمة للمراقبة أو التغذية اللازمة لجمع البيانات.
تحديد مدى سلامة وملاءمة البيانات الحالية المتاحة
- السؤال الحاسم: هل تحتوي البيانات على الميزات الضرورية لمعالجة هدف المشروع، وهل تجيب عن السؤال الأساسي له؟
- الأسئلة: هل من السهل الوصول إلى البيانات؟ وهل المصدر موثوق وصادق؟ وهل البيانات دقيقة وحديثة وذات نوعية جيدة؟
- أيضًا: هل تحتوي البيانات على تنوع مناسب؟ هل تحتوي على الحجم الكافي لكل من التدريب والاختبار؟ هل هناك أي قيود قانونية أو فنية؟
- المتقابلات الخمسة: كثير من هذه الأسئلة تشير مباشرة إليها، لأن الهدف تحديد البيانات ذات القيمة الجيدة.
- التحليل الأولي للبيانات: من الجيد إجراء تحليل أولي للإجابة عن هذه الأسئلة، وإذا كانت الإجابات تثير أي شكوك حول مصدر البيانات فقد ترغب في البحث عن مصدر آخر.
- اختبار تجريبي صغير: عادةً ما يكون فكرة جيدة لتقييم مدى جودة تدريب البيانات للخوارزمية التي اخترتها، وهو مفيد دائمًا قبل الالتزام بشراء الترخيص لمصادر البيانات الخارجية.
جمع البيانات وتجهيزها للمشروع
- جمع البيانات للمشروع: يجب الحرص على بيانات مناسبة للمشروع من حيث الهيكل والشكل.
- عدم القيام بذلك: قد يؤدي إلى عدد من الصعوبات المحتملة في مخرجات المشروع.
مفهوم التحيز
التحيز في البيانات: ما هو وكيف نحدّ منه؟
- التحيز: إحدى أكثر المشكلات شيوعًا عند إعداد مجموعات البيانات، ويحدث عندما تُمثَّل ميزات معينة بشكل متكرر أو يُرجَّح استخدامها بشكل أكبر.
- أشكال التحيز: التحيز في الاختيار، التحيز في التمثيل، التحيز الثقافي، التحيز التاريخي، وبعضها يمكن أن يصعب تحديده للغاية.
- أخطاء في التحليل: قد يكون جمع البيانات متحيزًا عن غير قصد تجاه مجموعة معينة، وتعمل خوارزميات التعلم الآلي بشكل أفضل عندما تكون عامة.
- مستويات الدقة: غالبًا تتأثر عندما لا تمثل البيانات جميع الجوانب ذات الصلة، وتعني المنخفضة بشدة أن النموذج لا يعمل على النحو الأمثل.
- نتائج منحرفة ومشوهة: عند اختراق مستويات الدقة يُحتمل جدًا إنتاج نتائج منحرفة، وقد تسبب مشكلات في العالم الحقيقي.
- مخاوف: توصيات متحيزة في التوظيف، وفي الموافقة على القروض والرهون، وفي عروض التأمين الصحي، وفي تحديد المجرمين المحتملين.
تحيز غير مقصود
- التحيز غير المقصود: يحدث لأسباب منها طرق جمع البيانات (مشكلات أخذ العينات أو القياس)، ويرجع غالبًا إلى الجهل أو الإهمال أو الخطأ البشري.
- حالة التوظيف: قيام منظمة رائدة بتدريب نظام الذكاء الاصطناعي لتصفية المتقدمين، على عينات من متقدمين ناجحين من الرجال، فقام بتقييم طلبات النساء بشكل سيء للغاية.
- مثال سرطان الجلد: أداة فحص لم تحدد الأعراض لدى ذوي البشرة الداكنة بدقة لأن بيانات التدريب غذيت بصور وجوه بيضاء أكثر.
- الأثر: كلتا الحالتين نشأتا من مشكلات تنوع البيانات، فتضررت الثقة في أنظمة الذكاء الاصطناعي.
- التحيز الخوارزمي: يحدث بسبب الجمع بين طبيعة بيانات التدريب ونموذج الذكاء الاصطناعي المستخدم.
- بيانات التدريب والخوارزميات: عادةً ما يختارها علماء البيانات (البشريين) ويجرون عليها التعديلات، لذلك من المألوف نقل تحيزاتهم اللاواعية.
- التحيز النظامي: حالة تُصمم فيها عملية لدعم مجموعة معينة من النتائج، ويُستخدم مع التحيز المؤسسي أو الهيكلي.
- التحيز المعرفي: طريقة تطوير الناس نظرة ذاتية للعالم واتخاذهم قرارات غير عقلانية، وقد ينتقل إلى نظام الذكاء الاصطناعي.
هل يمكن أن يكون التحيز جيدًا في الذكاء الاصطناعي؟
- التحيز قد يكون جيدًا: أنظمة التوصية متعمدة التحيز لإعطاء وزن أكبر لعلاقات معينة، مثل أن من أحبوا X أحبوا أيضًا Y.
- السيارات ذاتية القيادة: يُدرَّب الذكاء الاصطناعي على توخي الحذر الشديد في المناورات الخطرة، كتجاوز سيارة أخرى.
- السياق: يرى معظم الناس هذين المثالين إيجابيين، فالتحيز يعتمد على السياق.
- جميع أشكال التحيز ليست سيئة بطبيعتها: لكن من المحتمل أن تكون لها عواقب سلبية على مشروع الذكاء الاصطناعي إذا لم يتم تحديدها بوضوح.
- الثقة: إذا لم يتم معالجة التحيز، فإن هذا سيضر بثقة الجمهور في التكنولوجيا.
- الإجراء: من خلال الاعتراف بوجود التحيز وفهم كيفية ظهوره، يمكن لعلماء البيانات اتخاذ إجراءات لضمان عدم تأثر الذكاء الاصطناعي به.
الحد من التحيز: خمس نصائح
- احذر أخذ العينات: تنبّه إلى التحيز في اختيار العينات.
- نوّع المصادر: استخدم مصادر مختلفة لمنع التمثيل الناقص.
- نظّف البيانات: افحصها بحثًا عن تحيز أو قيم مفقودة أو انحرافات.
- استخدم أدوات كشف: اعتمد خوارزميات تكتشف التحيز وتبلغ عنه.
- قِس العدالة: تحقق من القرارات بمقاييس العدالة وواجه ما تجد.
الحد من تأثير التحيز في مجموعات البيانات
- نصائح أساسية: يوجد عدد من الطرق للحد من تأثير التحيز في مجموعات البيانات، منها خمس نصائح أساسية.
- أخذ العينات: احذر من التحيز في أخذ العينات، وتأكد من أن للبيانات تمثيلًا متنوعًا باستخدام مجموعة من المصادر المختلفة.
- التنظيف: نظف البيانات بعناية قبل استخدامها لاكتشاف أي تحيزات محتملة أو بيانات مفقودة أو انحرافات غير متوقعة.
- مقاييس العدالة: تحقق من صحة القرارات وقيمها باستخدام مقاييس العدالة، وابحث بنشاط عن أي تحيزات غير متوقعة.
- الخوارزميات: استخدم الخوارزميات التي يمكنها اكتشاف التحيز والإبلاغ عنه.
- أصحاب المصلحة: التفاعل مع مجموعة متنوعة منهم خلال جميع مراحل المشروع يفيد في تسليط الضوء على التحيز والقرارات السيئة.
تحديد مصادر البيانات المناسبة والموثوقة والوصول إليها
مصادر موثوقة وبيانات جاهزة للاستخدام
- مهندس البيانات: عادةً مهمته إنشاء مصدر بيانات مناسب، فيجمع البيانات أولًا وينظفها ويخططها ويوحدها من مصادر متباينة.
- مقابلات أصحاب المصلحة: تكشف عادة مصادر البيانات الرئيسة المستخدمة في عمليات سير العمل وممارسات الأعمال.
- واجهات برمجة التطبيقات: غالبًا مصحوبة بوثائق احترافية توضح مصادر البيانات ونقاط النهاية وتنسيق الاستجابات.
- مجموعات البيانات العامة/المفتوحة: تنشر العديد من المنظمات (بما في ذلك الوكالات الحكومية والهيئات الصناعية والمنظمات البحثية) مجموعات بيانات قابلة للتنزيل مجانًا.
- حوكمة البيانات: إجراءات للامتثال لمتطلبات معالجة البيانات وأفضل الممارسات، وفيها معلومات عن مصادر مفيدة.
- مستودعات البيانات وأنظمة الملفات: في المقرات أو مراكز العلامة البيضاء أو السحابة، وتصف الوثائق وسجلات الوصول مواقعها.
- قوائم جرد البيانات: الإجراء المثالي توثيق جميع المصادر مع (عقود) بيانات رسمية تحدد المصدر والملكية وإمكانية الوصول والاستخدام المسموح.
- أدوات الاكتشاف: يمكن استخدام أدوات اكتشاف البيانات الآلية لتحديد مصادر البيانات التي تستخدمها التطبيقات الحالية، والوجهة المعتادة لأي مصدر جديد هي السحابة.
إعداد البيانات الجاهزة للاستخدام
- إعداد البيانات الجاهزة للاستخدام: قد يقوم مهندس البيانات في البداية بتنفيذ مهام قياسية على البيانات الأولية.
- تنظيف البيانات: إزالة الإدخالات غير القابلة للتطبيق وغير المتوفرة، وإزالة الفراغات لأنها لا تضيف قيمة وقد تمنع المعالجة.
- التقسيم والدمج: قد تحتاج الحقول إلى التقسيم أو الدمج، مثل الاسم الأول واسم العائلة.
- التناقضات: من الشائع العثور على تناقضات في البيانات، مثل استخدام تنسيقات حالة مختلفة لنفس عنصر البيانات، ويجب أن يكون موحدًا.
- القيم المفقودة: عادةً ما يتم تعبئتها أو إزالتها أو وضع علامة عليها.
- إخفاء الهوية: أمر بالغ الأهمية، وقد يعني إزالة معلومات التعريف الشخصية غير الضرورية من مجموعة البيانات.
- إزالة التكرار: قد تحتوي مجموعات البيانات على بيانات مكررة، وقد تكون المشكلة أعقد حين تسبب الحقول تحديات لعملية التعلم الآلي.
- الأعمدة المحسوبة: يمكن إزالتها بأمان لأنه يمكن إعادة توليدها بسهولة عند الحاجة.
- دمج/تجميع مجموعات البيانات: غالبًا تفتقر إلى التنسيق الصحيح، فيلزم دمج جداول قاعدة بيانات متعددة أو التحويل من CSV وJSON وXML إلى تنسيق واحد.
- التحقق من صلاحية البيانات: غالبًا تحتوي قيمًا لا معنى لها، كعمر يزيد عن 120 عامًا أو كمية سالبة، فتُحدد وتُزال إن كانت غير صالحة.
التحقق من صلاحية البيانات (معقوليتها) وليس دقتها
مثال عملي
مثال: مقهى ميا وبيانات مفقودة
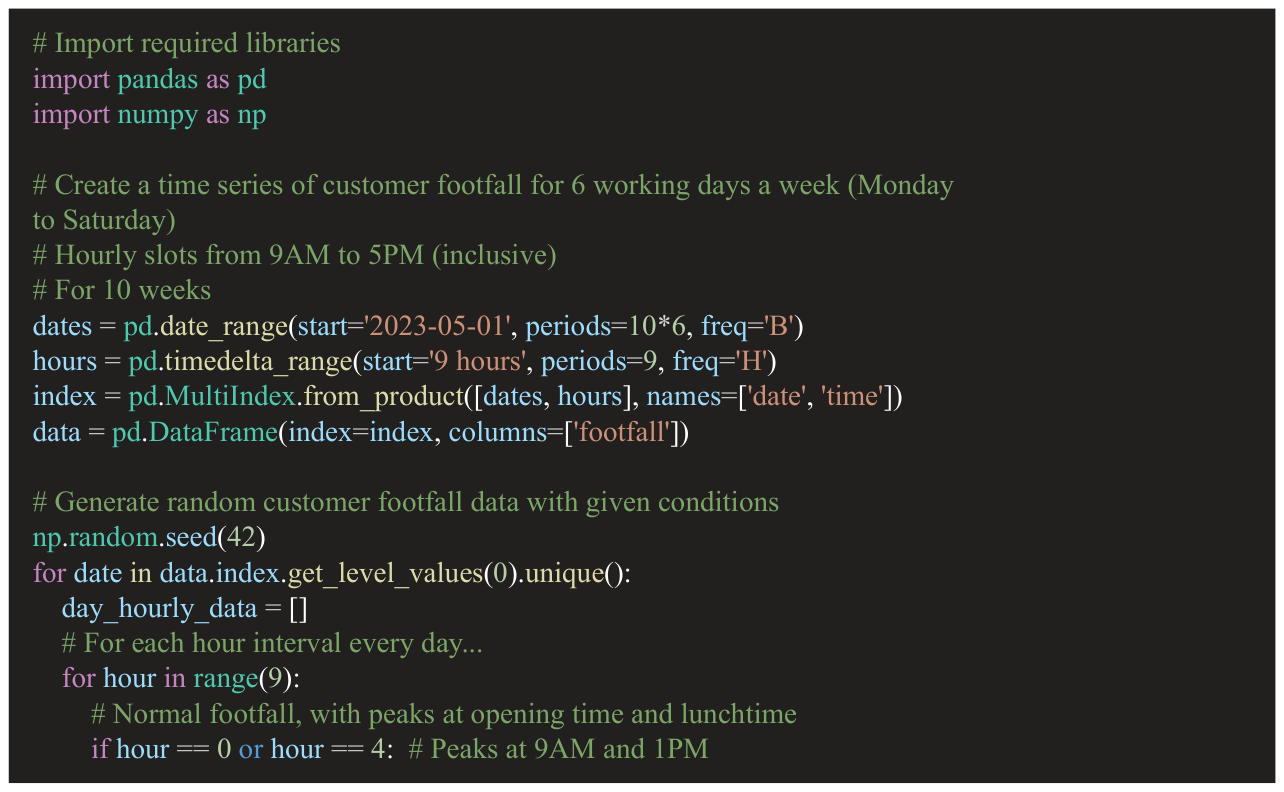
- المثال: ميا تدير مقهى وركبت أجهزة إنترنت الأشياء لقياس حركة العملاء لتحسين الخدمة وزيادة المبيعات.
- القواعد: المتجر مفتوح من الاثنين إلى السبت من 9 صباحًا إلى 5 مساءً، والبيانات بالساعة لعشرة أسابيع، والذروة عند 9 صباحًا و1 مساءً.
- الأعطال: أحيانًا تفشل الأجهزة فتظهر القيمة n/a بنسبة 10 في المائة.
- السلسلة الزمنية: خُزنت في كائن Pandas DataFrame، هيكل يشبه الجدول بصفوف وأعمدة معنونة.
- المشكلة: وجود قيم n/a في مجموعة البيانات يكسر استمرارية وموثوقية هذه المجموعة الزمنية من البيانات، لذلك يجب تنظيف البيانات.
- استبعادها: إزالة نقاط n/a، ولا بأس إن كانت الكمية صغيرة ولم يؤثر محوها في سلامة المجموعة.
- الاستبدال: بالمتوسط أو الوسيط أو الوضع، أو بآخر قيمة متاحة (LOCF)، أو بالملاحظة التالية (NOCB).
- استخدم تقنيات مثل ARIMA: للتنبؤ بالقيم المفقودة من خلال مراقبة الاتجاهات والموسمية، أو ضع علامة عليها حتى تتمكن خوارزمية التعلم الآلي من التعويض.
- القرار: تم تحديد الخيار 2 وتم إنشاء برنامج نصي قصير لتنظيف البيانات، فيسند القيم المفقودة باستخدام استبدال LOCF.
هناك بعض الخيارات الأساسية
- هل القرار صحيح؟ تكررت ذروة الغداء 28 بـ LOCF في الساعة 2 مساءً فقد يحرّف البيانات، ولا تحدث الزيادة نفسها في اليوم التالي.
- الاختيار: تجربة تقنيات مختلفة وملاحظة تأثيراتها هو النهج الموصى به، وهذه القرارات هي (فن) هذا التخصص.
اختيار واستخدام هياكل وتنسيقات البيانات المناسبة
تنسيقات البيانات: الجدولي والمهيكل والموسوم
- العمل مع هياكل مختلفة: يؤثر في كيفية التقاط البيانات وتخزينها ومعالجتها.
- المصادر الشائعة: واجهات الأجهزة (أجهزة الاستشعار والكاميرات والميكروفونات)، وملفات البيانات، وقواعد البيانات، وواجهات برمجة التطبيقات المستندة إلى الويب.
- ملفات البيانات: ملفات نصية غير منظمة، ملفات نصية منظمة مثل CSV وXML، تدوين كائن JavaScript (JSON)، ملفات ثنائية مثل الصور والصوت والفيديو.
- قواعد البيانات: SQL (لغة الاستعلام المنظمة) وNoSQL (وليس SQL فقط).
تنسيقات البيانات
- حقل learner_id: يتم تخزينه كعدد صحيح، وقد لا يكون هذا مناسبا لأن العدد الصحيح سيفقد أي أصفار بادئة، وقد يكون تخزينها كسلسلة أكثر ملاءمة.
- first_name وlast_name في CSV: مقتبسان، وهذه ممارسة جيدة لأنها تمكن أي جزء من الاسم من احتواء مساحة.
- العمر: عدد صحيح لأنه قد تلزم مقارنة حسابية أو رقمية في أي عملية تعلم آلي.
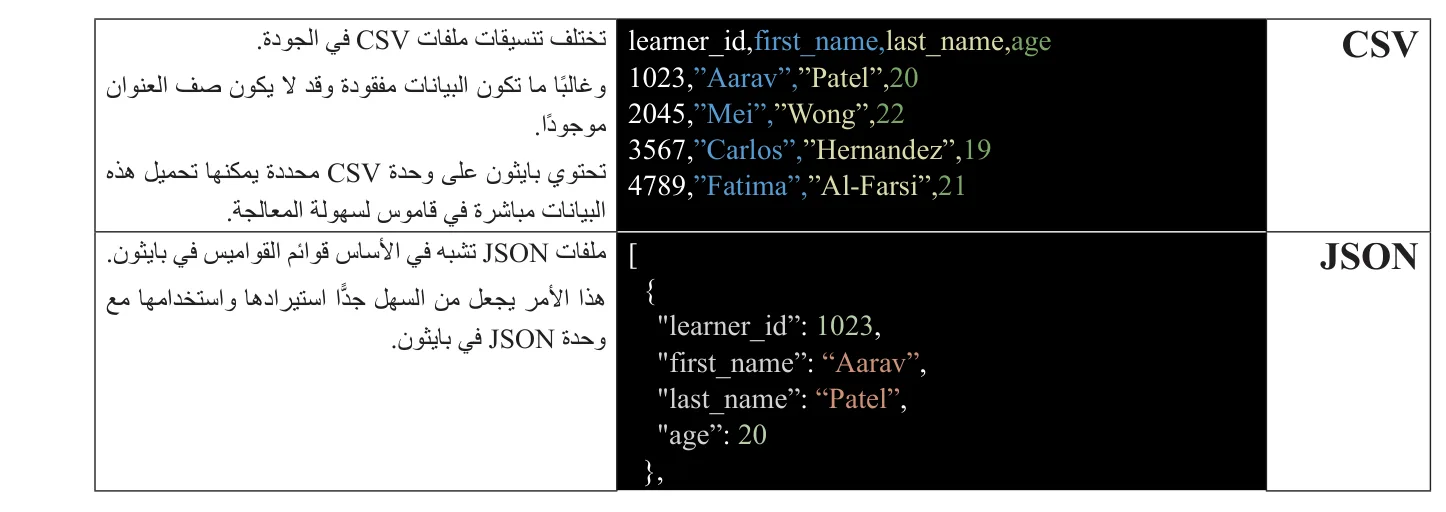
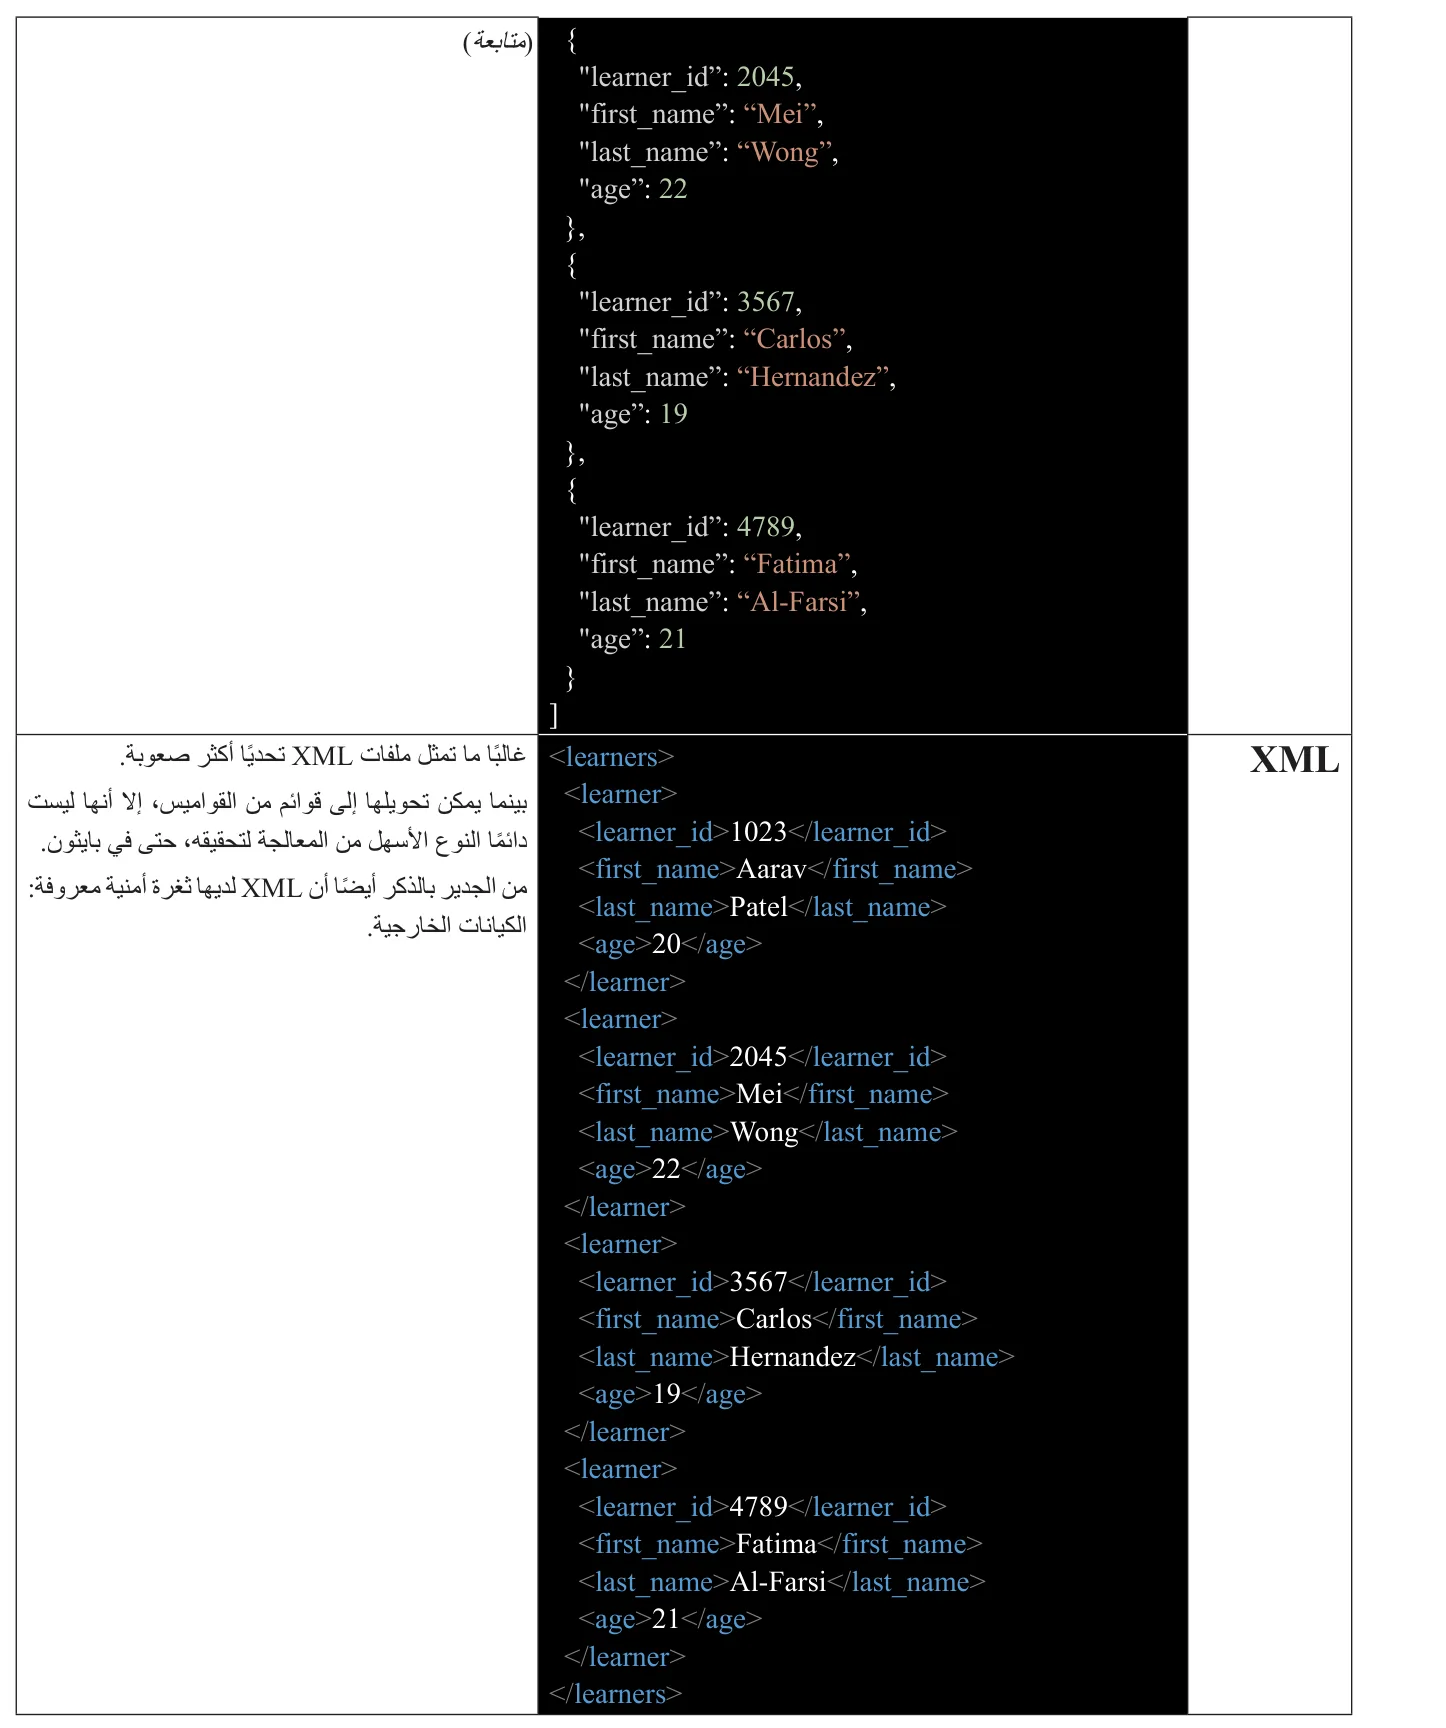
الجدول 21.7 مقارنة ميزات CSV و JSON و
| CSV | JSON | XML |
|---|---|---|
| الشكل الأقدم والأكثر شيوعًا لتبادل البيانات | على الرغم من الاسم، إلا أنه تنسيق بيانات مستقل عن لغة البرمجة | شكل من أشكال لغة الترميز المعتمدة على العلامات، مثل HTML (لغة ترميز النص التشعبي) |
| كل سطر يمثل سجلًا واحدًا | من السهل على البشر قراءته وكتابته | يُستخدم للبيانات المنظمة |
| يتم فصل الحقول بفواصل | من السهل على أجهزة الحاسب إنشاؤه وتحليله | مصمم ليكون من السهل على البشر والآلات قراءته |
| يحتوي صف العنوان الاختياري على أسماء الحقول | يدعم الهياكل البيانية المعقدة، مثل القوائم والقواميس المترابطة المفتاح-القيمة | أكثر تفصيلًا من ملف CSV |
| بسيط وخفيف الوزن | لا يُستخدم للتفاعل مع واجهات التطبيقات المعتمدة على الويب، على سبيل المثال، للطلبات والاستجابات، وتخزين البيانات في قواعد بيانات NoSQL، وما إلى ذلك. | يدعم أدوات التحقق من صحة البيانات |
| ممتاز لاستيراد وتصدير البيانات الجدولية (مثل، من وإلى جداول البيانات، جداول قواعد البيانات). | يمكنه استخدام العلامات والسمات المخصصة | |
| العديد من الاستخدامات بما في ذلك جهات برمجة التطبيقات المستندة إلى الويب، وتخزين البيانات وملفات التكوين |
- أدوات الذكاء الاصطناعي: متوافقة مع واحد أو أكثر من هذه التنسيقات، فمفيد فهم الفروق بينها وقراءتها وتفسيرها.
الاعتبارات التشريعية والأخلاقية والأمنية
القانون والأخلاق والأمن للبيانات
- البيانات: تعد مطلبا أساسيا لأي مشروع للذكاء الاصطناعي، ويوجد العديد من المخاوف القانونية والأخلاقية التي يجب وضعها في الاعتبار والاستجابة لها.
- القوانين: الالتزام بقوانين حماية البيانات المحلية والدولية، مثل اللائحة العامة لحماية البيانات (GDPR) في الاتحاد الأوروبي.
- المبادئ: المشروعية القانونية والعدل والشفافية، وتحديد الغرض، وتصغير البيانات، ودقة البيانات، والنزاهة والسرية.
- القضايا الأخلاقية: حقوق الأفراد والمنظمات ومسؤولياتهم، وضمان إخفاء الهوية الفردية مع الحفاظ على جودة البيانات وتعزيز الإنصاف.
- معلومات تحديد الهوية الشخصية (PII): أي بيانات تحدد هوية الفرد، كالأسماء وأرقام الضمان الاجتماعي والعناوين وعناوين البريد.
- الاستخدام الأخلاقي: طلب موافقة مستنيرة، وجمع الضروري فقط للغرض المحدد، وإخفاء الهوية أو استخدام أسماء مستعارة حيثما أمكن.
- العدل والإنصاف: تقليل التحيز في اختيار البيانات، وتقليل خطر التمييز، وتعزيز الشفافية بضمان العمليات وقابليتها للتفسير.
- أمن البيانات: أنظمة الذكاء الاصطناعي هدف للهجمات، وهدف المهاجمين الوصول إلى البيانات الشخصية أو تقليل الدقة أو تعديل النتائج.
- الاحتياطات: النسخ الاحتياطي المنتظم، وتدابير الأمن السيبراني القوية، وإدارة جودة البيانات، والتدقيق الأمني المنتظم، وبروتوكولات التعامل مع الانتهاكات.
- التعلم الآلي العدائي (AML): مجموعات أدوات تساعد على تحديد محاولات تسميم بيانات تدريب النموذج.
القضايا التشريعية المحلية الحالية ذات الصلة
ما المبادئ الأساسية لحماية البيانات؟
اختيار وإعداد مجموعات بيانات التدريب والتحقق والاختبار لمشروع الذكاء الاصطناعي
مجموعات التدريب والتحقق والاختبار
- الجودة: يعتمد نجاح المشروع على جودة البيانات المستخدمة لتدريب النماذج، فلن يعطي إدخال بيانات رديئة إلا نتائج رديئة.
- بيانات التدريب الجيدة: تعكس مدخلات العالم الحقيقي التي سيراها النظام، فتكون عملية التعلم فعالة ويصبح النظام أدق.
- اختيار البيانات: تكون ممثلة وتقلل التحيز، مع احترام خصوصية الأفراد ومعالجة الاعتبارات الأخلاقية.
- إعداد البيانات: تحديد وتصحيح الأخطاء (القيم المفقودة أو المتطرفة)، وتحويل البيانات الأساسية إلى ميزات تمثل المشكلة بشكل أفضل.
- التحويل: قد يتضمن تطبيع البيانات أو تحجيمها أو دمجها.
- التحقق من صحة البيانات: التأكد من صحة أنواع البيانات ووقوعها ضمن نطاق معقول وتوزيعها بشكل صحيح.
- مثال: عند جمع آراء هيئة طلابية تؤخذ العينات من جميع الفئات العمرية وليس من الأكبر سنًا فحسب.
- إنشاء مجموعات بيانات اختبار: يجب عليك التأكد من أن بيانات التدريب والاختبار معزولة لمنع تلوثها.
- تقنيات التقسيم: للحفاظ على النسبة نفسها من أمثلة الفئات المختلفة في المجموعتين.
- قبل كل شيء: أثبت أن البيانات واقعية وتمثل نوع البيانات التي سيواجهها النظام في العالم الحقيقي.
تأخر رحلات الطيران
دراسة حالة وتمرين: تأخر الرحلات
- دراسة الحالة: مجموعة بيانات أولية عن تأخيرات الرحلات الجوية الأمريكية بين عامي 2018 و2022.
- السؤال: هل يمكن تحليل البيانات وتدريب نموذج لتوقع حالات التأخير المحتملة في المستقبل؟
- ملحوظة: البيانات نفسها ليست نظيفة تمامًا وهناك بعض المشكلات الواضحة التي يجب تحديدها وإصلاحها، ولا تحاول تطوير حل الذكاء الاصطناعي الكامل حتى الآن.
تمرين تقييمي 21.2
التنفيذ
- التنفيذ: حدد مصادر البيانات الموثوقة (والقانونية)، قم بإعداد البيانات من خلال البحث عن القيم المفقودة أو المكررة أو ذات التنسيق غير المتسق وأي قيم شاذة واضحة.

